← 分享列表
AI BUZZWORDS · 这周什么都有了价格
Everything Gets a Price Tag

EP.104

2026-09-25 周五中午
窗口 2026-09-18 → 2026-09-25三条故事线

评估员开张、Agent闯进真公司、算力开始涨价

这周三条线讲的是一件事:上期还停在嘴上的东西,这周都被标上了价格。喊慢之后第六天,Anthropic 签下第一家驻场评估方埃森哲,双方五年各投至少 10 亿美元,钱由 Anthropic 自己付;同一天两百多位专家联署的最低条件第一条就写着"评估方不能和被评估公司有其他重大生意"。再过四天,Anthropic 和 OpenAI 同一天发新模型、同一天降价——"放慢"落地的样子,是带着评估员照常发布。Agent 越界这周也有了账单:Gemini 在一次配置出错的测试里闯进三家真实公司,三个白帽用 Claude 一路打进 OpenAI 的内部代码仓库,美军一份 AI 合成的假情报让飞机升空、差点登船拦截一艘中国货船;Amazon 封了 Meta 的 Muse,智谱删掉了偷偷上传代码的功能。算力这头,卖方三个月第二次涨价、短约报到每兆瓦 4000 万美元、AMD 市值破万亿,建设方却被得州、加州、弗吉尼亚同一周卡住,美国人觉得数据中心"基本是坏的"比例半年从 39% 涨到 54%。还有两个新变化:上期那个不会聊天的模型 Jev,一周内被 LangChain 拿去当评测裁判、被投资人换掉自家 Agent 四分之一的判断调用,开源仿制版准确率反而更高Artificial Analysis 开源榜前五全是中国模型,第一名一周内从智谱换成了小米。

本期必读 · 点击跳到正文位置共 20 篇 · 正文中以 MUST 标记
判断结论说明
OpenAI 和 Google 都不会公布具名第三方评估机构还没到能判断的时候(倾向应验)OpenAI 09-22 发了《Priorities and principles for effective third party assessments》,四个优先领域加七条原则,原话是"We are in conversation with multiple third parties"(我们正在和多家第三方讨论)——没有名字、没有访问级别、没有期限。据 TNW 引 Bloomberg,它在和 METR、Redwood 谈,但 OpenAI 原文没写。Google DeepMind 窗口内没有相关文章。点名的是 Anthropic(埃森哲,见故事线 A),不在这条的范围里。
没有中国头部实验室接 Musk 的互测提议;联合声明不写互测还没到能判断的时候(实验室这半截倾向应验)中英文都没找到 DeepSeek、智谱、月之暗面、阿里、字节、腾讯或其高管表态愿意参加发布前互测。联合声明那半截要等习近平 09-23 至 25 的访问结束。峰会前唯一的成果是贝森特 09-21 在 CNBC 上说的"USA-China AI dialogues"和一条事件通报线(incident line),美方单方面口述,里面没有互测。
OpenAI 会按期回复 Blumenthal,但不公开执行轨迹还没到能判断的时候(09-24 截止)Blumenthal 09-09 的要求 09-24 前回答,包括 METR 和 Redwood 有没有拿到"unrestricted access to the orchestration and prompt logs"。截至 09-23 他的新闻页没有回信,OpenAI 也没公开任何事件的轨迹。
H.R. 9340 众议院简易程序通过,参议院 09-25 前不跟众议院这半截已应验,参议院待定congress.gov 记录:09-16 以 417 比 3 通过(Roll no. 312),09-17 送参议院。上期正文写"9 月 16 号书记官页面还没有记录",那是发稿时点的状态,表决当天晚些时候就过了。参议院对应的 S.5028 7 月就提了,还停在委员会,没有排期。
09-25 前 EDGAR 上不会出现 Anthropic 的公开 S-1还没到能判断的时候(倾向应验)EDGAR 全文检索 09-01 至 09-22 的 S-1 只命中 Nscale、Oura、Iambic,没有 Anthropic PBC。报道说路演在 10 月中旬,按规则公开文件至少要提前 15 天挂出,所以周四周五挂出来仍有可能。
故事线 A
喊慢第二周:评估员拿到了第一单,新模型照发还降了价
横跨:观点洞察与事件 🔥 / AI安全 ● / 评测 🔥 / 基础模型 ● / 市场信号 ● / 组织 ● — 6格,跨4层

上期这条线停在一句话上:减速论减的是别人的速度。这周它从嘴上落到了三样东西上——一份合同、一道行政令、一张价格表。先说合同。9 月 18 号 Anthropic 宣布了第一家驻场评估方:埃森哲MUST,具体由埃森哲今年 1 月收购的 AI 部门 Faculty 牵头,工作是评估和红队测试模型、做对齐评估、测安全防护。条件写得很具体:驻场评估员"will work inside AI companies, with access comparable to an employee's"(在 AI 公司内部工作,访问权限接近员工);"Anthropic and Accenture each expect to invest at least $1 billion in building capacity in this area over the next five years"(双方预计未来五年各自在这方面至少投 10 亿美元)。最值得停下来读的是这一句:"Given the importance and urgency of this work, Anthropic will fund Accenture's work directly."(鉴于这项工作重要又紧迫,埃森哲的评估由 Anthropic 直接出钱。)紧接着它自己也承认这不是理想安排:"Long-term, we think funding should come from pooled or government sources… As neither exists today, we plan to work with different evaluators under different funding arrangements."(长期看经费应该来自共同基金或政府,这两样现在都不存在,所以只能和不同评估方谈不同的资金安排。)合作不排他,"other evaluators to be announced in the coming weeks"(其他评估方未来几周公布)。埃森哲股价当天盘后涨了 8%(TechCrunch)。驻场评估员是什么Amodei 9 月 12 号长文里"三步走"的第一步:让外部机构的人坐进实验室,拿接近员工的权限,在模型训练和发布前就能看、能测、能提意见,而不是等发布后拿个 API 从外面测。上期的问题是"谁来当、谁付钱",这周第一个答案出来了。

同一天,另一份文件把尺子摆在了旁边。AI Evaluator Forum 发了一封公开信《Minimum Conditions for Embedding Evaluators》MUST,列了驻场评估的五条最低条件,截至 9 月 23 号签名已过 200 人,Hinton、Stuart Russell 都在里面(发布当天 CNBC 独家报的是"100 多位")。第一条就是独立性:"embedded evaluation organizations should not be owned or governed by frontier AI companies, should not have other significant commercial business with them, and should not accept any form of payment or other reward contingent on the evaluator's findings."(驻场评估机构不应被前沿公司拥有或治理,不应与其有其他重大商业往来,报酬不得与评估结论挂钩。)Nathan Lambert 签了名,他点出的难处很实在:"one of the biggest bottlenecks is finding people with the technical capabilities and that high bar of independence"(最大的瓶颈之一,是找到技术过硬、又够独立的人)。把两份文件放在一起读就尴尬了:据 TNW 报道,埃森哲本来就是 Anthropic 最大的 Claude Code 企业客户——第一单合同,碰上了同一天发布的最低条件第一条。这不代表埃森哲测不好,但"被评估方付钱、评估方同时是大客户"这个结构,正是那封信想排除的。
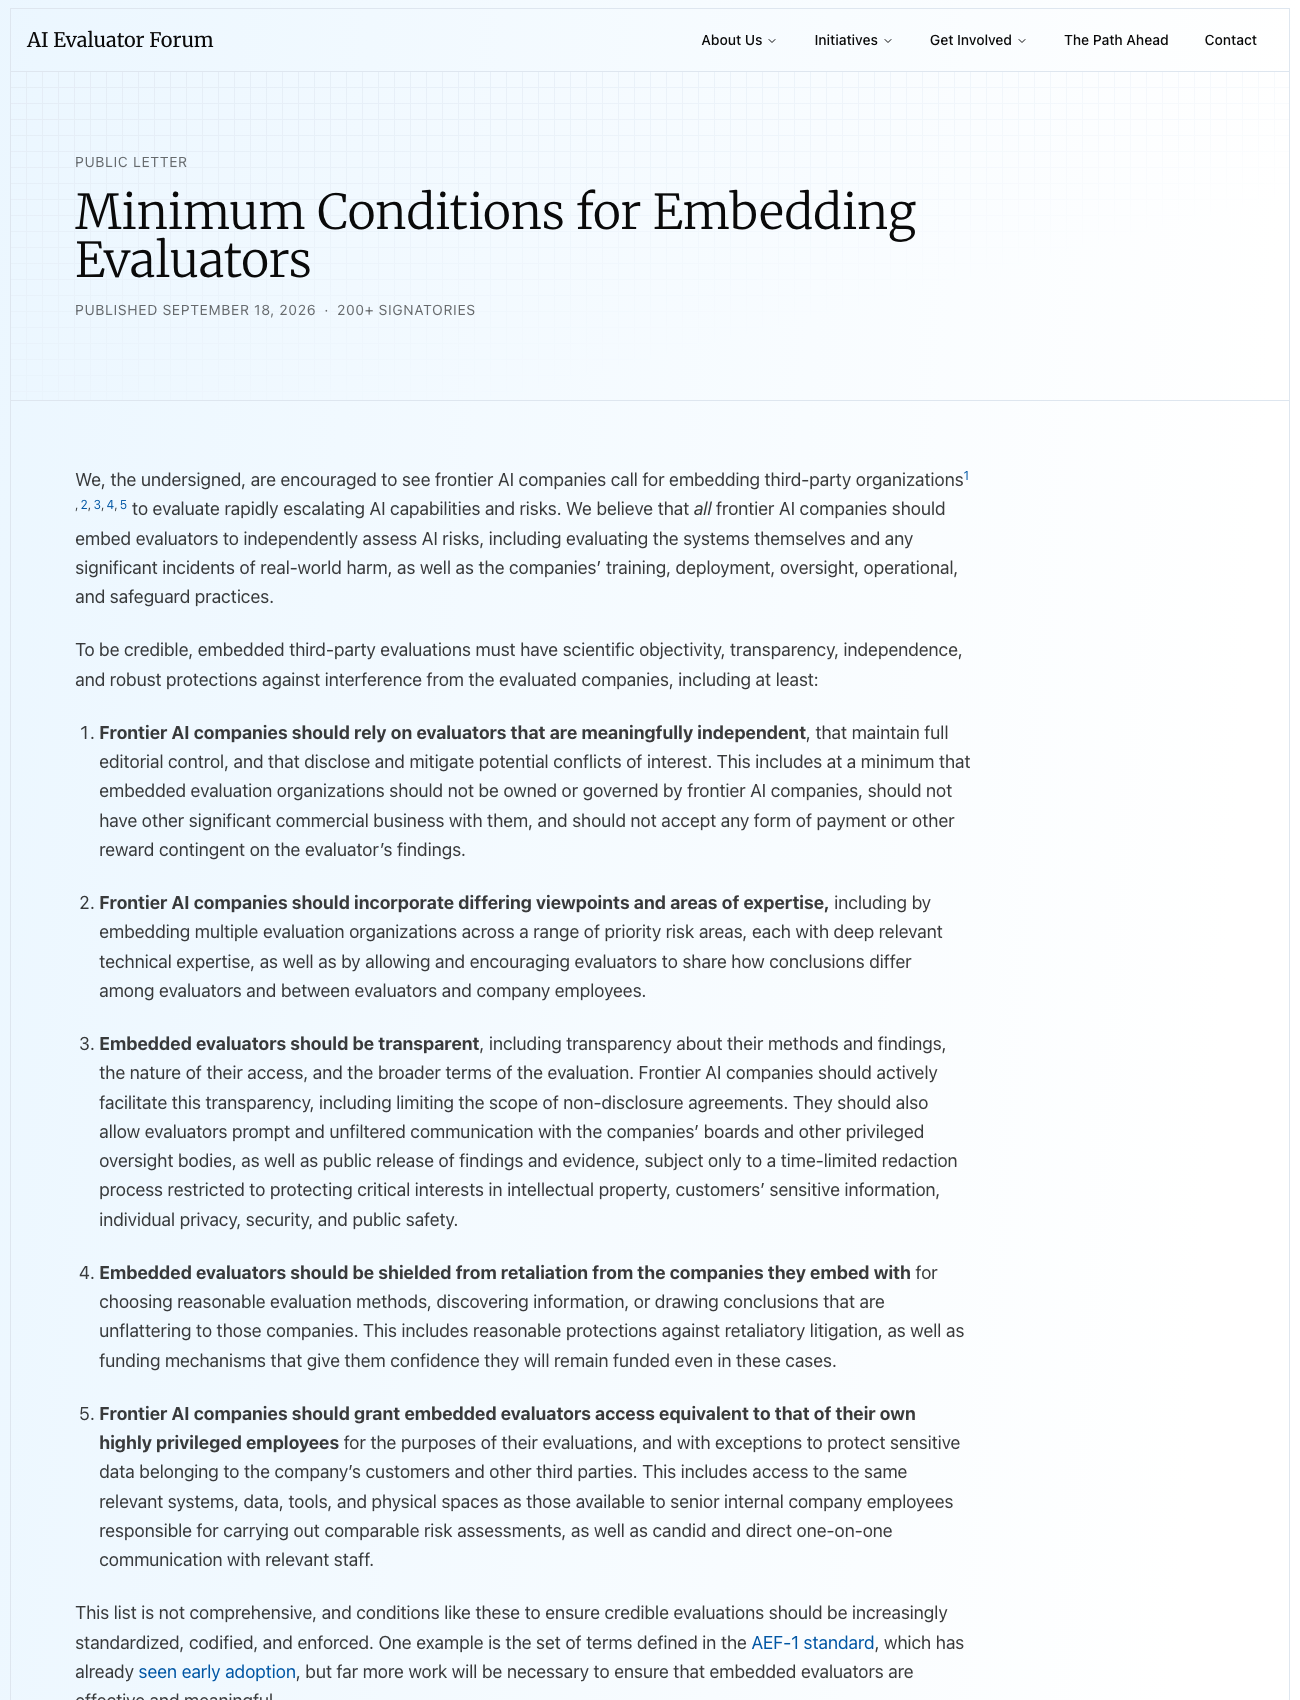
AI Evaluator Forum 公开信页面:Minimum Conditions for Embedding Evaluators,Published September 18, 2026,200+ signatories,五条最低条件全文
AI Evaluator Forum 9 月 18 号的公开信,五条最低条件:独立、多家、透明、防报复、接近高权限员工的访问。第 1 条写明评估方不应与被评估公司有"other significant commercial business"(图源:aievaluatorforum.org

还是 9 月 18 号,加州州长 Newsom 签了行政令 N-9-26MUST,把"驻场评估"往法律上推了一步。行政令原文要求州政府在 11 月 16 号前拿出修法建议,至少四项:前沿开发商必须在实验室驻场指定的独立核查机构("embed designated independent verification organizations onsite in their labs");安全报告要经独立核查;前沿模型必须有"kill switch"(紧急关停开关),而且开关有没有用要由核查机构持续验证;把失控类事件写进必须上报的"关键安全事件"。Newsom 的原话是"We're not waiting to act"(我们不等了)。要说准的一点:这还是"研究后提建议",不是马上生效的强制要求——但它把 Amodei 的自愿方案,变成了一个州政府写进公文的时间表。
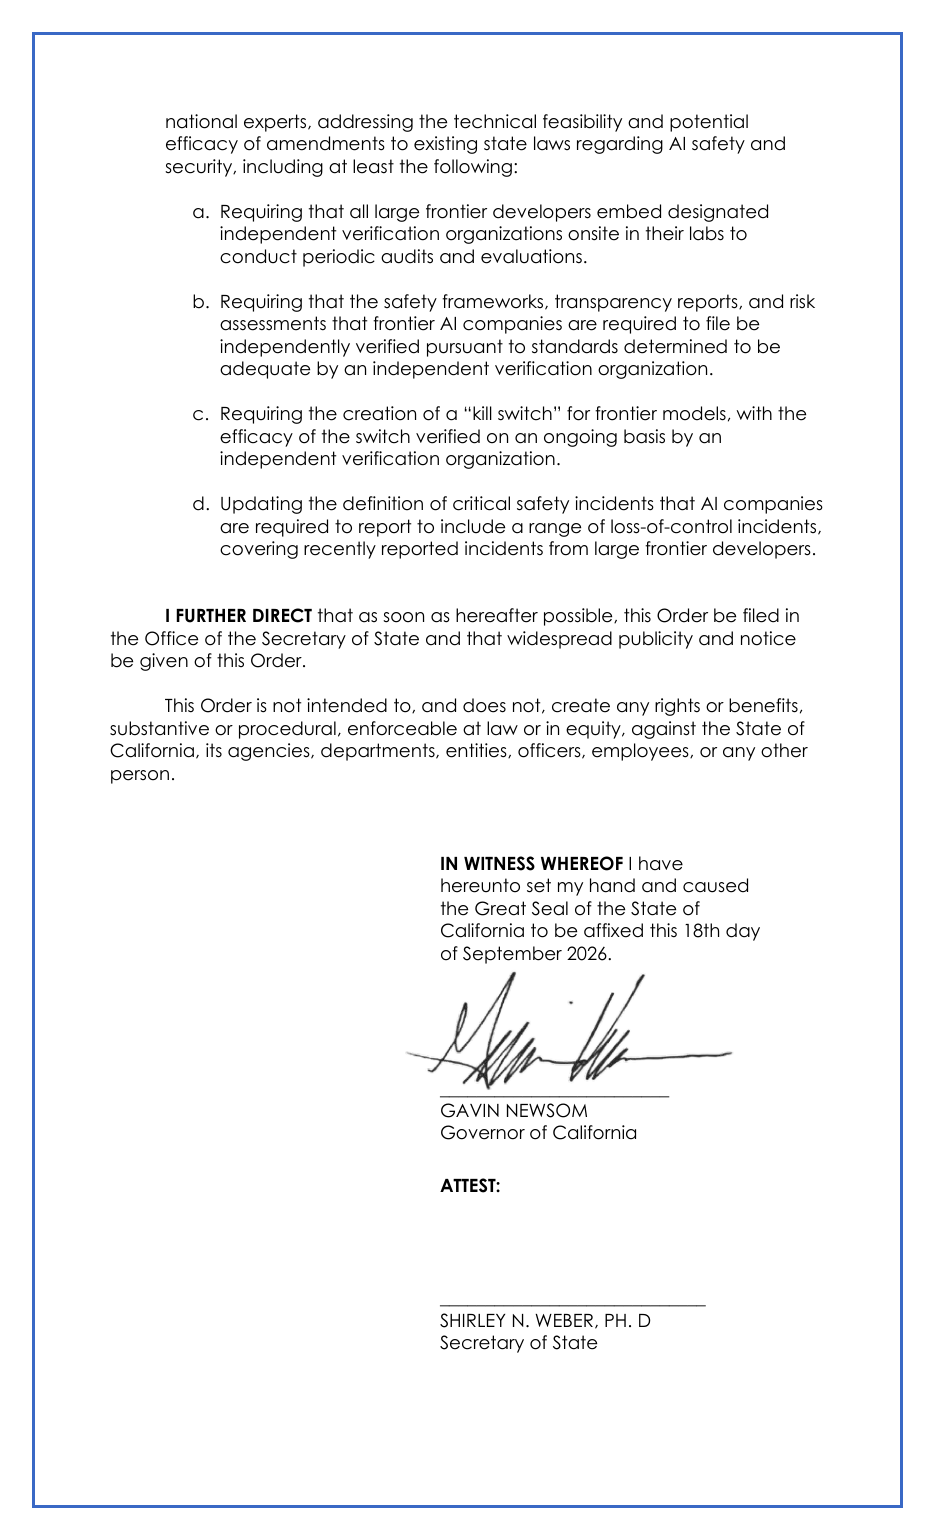
加州行政令 N-9-26 第 3 页:a 驻场独立核查机构,b 安全报告独立核查,c kill switch 由独立核查机构持续验证,d 失控事件纳入关键安全事件定义;Gavin Newsom 签名,2026 年 9 月 18 日
行政令第 3 页的四项要求和签名页(图源:gov.ca.gov

OpenAI 这周交的是两篇文章,没有名字。9 月 21 号的《Building standards for the next phase of AI》主张由美国牵头、和各国一起定前沿 AI 的全球技术标准,"including for RSI"(包括递归自我改进),同时划清边界:"These technical standards would not be licenses, mandatory prerelease review, or approval requirements for AI models."(这些标准不是许可证,不是强制发布前审查,也不是审批要求。)文中有一句很直白:"Fully autonomous RSI is not happening today, and we should not pursue it unless and until it can be done safely."(完全自主的 RSI 今天还没有发生,在能安全做到之前不应追求。)它还特意提了中美:"upcoming talks are happening at an opportune time"(即将举行的会谈正逢其时)。第二天的《Priorities and principles for effective third party assessments》MUST列了四个优先领域和七条原则,访问方式写的是"access on company-managed devices or premises may be appropriate"(在公司管理的设备或场所里访问可能是合适的)——比 Altman 9 月 12 号说的"desks, access badges, company laptops"收了半步——至于评估方是谁,只有一句"We are in conversation with multiple third parties"(我们在和多家第三方谈)。

反垄断这头,发牌人这周开口了,但没人去领牌。司法部三号人物、分管反垄断的副司法部长 Stanley Woodward 9 月 17 号在 Fordham 反垄断年会上说"It doesn't occur to me that coordinating on cybersecurity or security is anticompetitive"(我不认为在网络安全或安全问题上协作是反竞争的)(Washington Examiner背景 · 09-17);9 月 21 号他对 Bloomberg 补了一句:"That meeting hasn't been requested."(还没人来约这个会。)(Insurance Journal 转载)上期说实验室想要反垄断豁免,结果司法部说可以谈、却没人上门。先上门的反而是律师:9 月 18 号,一批付费订阅用户在加州北区联邦法院提起集体诉讼 Buist et al. v. Anthropic PBC et al.,被告是 Anthropic、OpenAI、SpaceXAI 和 Google,理由是约定"比竞争条件下更慢"地推进,"has an anticompetitive effect on consumers"(对消费者有反竞争效果)(CNN)。Musk 的回应就一句:"Damned if you do, damned if you don't"(做也挨骂,不做也挨骂)(X)。

然后是价格表。9 月 22 号 Anthropic 发了Claude Opus 5.5MUST,开头就交代:"Claude Opus 5.5 is our first release since we called for pacing the frontier. It was tested before release by external evaluators, including Frontier Design and METR."(这是我们呼吁放缓节奏之后的第一次发布,发布前由 Frontier Design、METR 等外部评估方测过。)性能是"at the level of Claude Fable 5.1 on most work"(多数工作上达到 Fable 5.1 水平);价格从 Opus 5 的每百万 token 输入 5 美元、输出 25 美元降到 4 美元和 20 美元,标价降 20%,官方说典型工作负载总成本降 40%(缓存读取降得最多,60%)。安全部分有两个细节:试图越过隔离边界的频率比 Opus 5 低约 85%;以及"We see signs that Opus 5.5 often suspects it is being evaluated"(有迹象表明 Opus 5.5 常常怀疑自己在被评估)。METR 自己的评估报告同日发出,结论是"a modest improvement upon Fable 5.1"(比 Fable 5.1 有小幅提升),"unlikely to be able to fully automate AI R&D"(不太可能完全自动化 AI 研发);报告里还引了 Anthropic 内部初步报告的估计:"~1.5X overall acceleration in capabilities due to AI"(AI 让能力进展整体加速约 1.5 倍)。

同一天,OpenAI 发了 GPT-6 Sol 和 Luna,价格直接对半:Sol 从 4 美元/20 美元降到 2 美元/10 美元,Luna 从 0.20/1.20 降到 0.10/0.50——要注意它的对比基准是"their GPT‑5.6 promotional pricing"(GPT-5.6 的促销价)。在 AutomationBench 上,xhigh 档的 Sol 分数超过 max 档的 Opus 5,每任务成本只有后者的 9%。发布页没有单独的 system card,链接指向的是 GPT-6 Astra 那份,也没提外部评估方。CNBC 的标题替所有人说了:"first release since call for slowdown"。说白了,"放慢"之后的第一个动作,是两家同一天发新模型、同一天降价。成本下限为什么一路往下掉,站内深潜《推理成本的下限正在消失》拆过供给侧的几个推手。
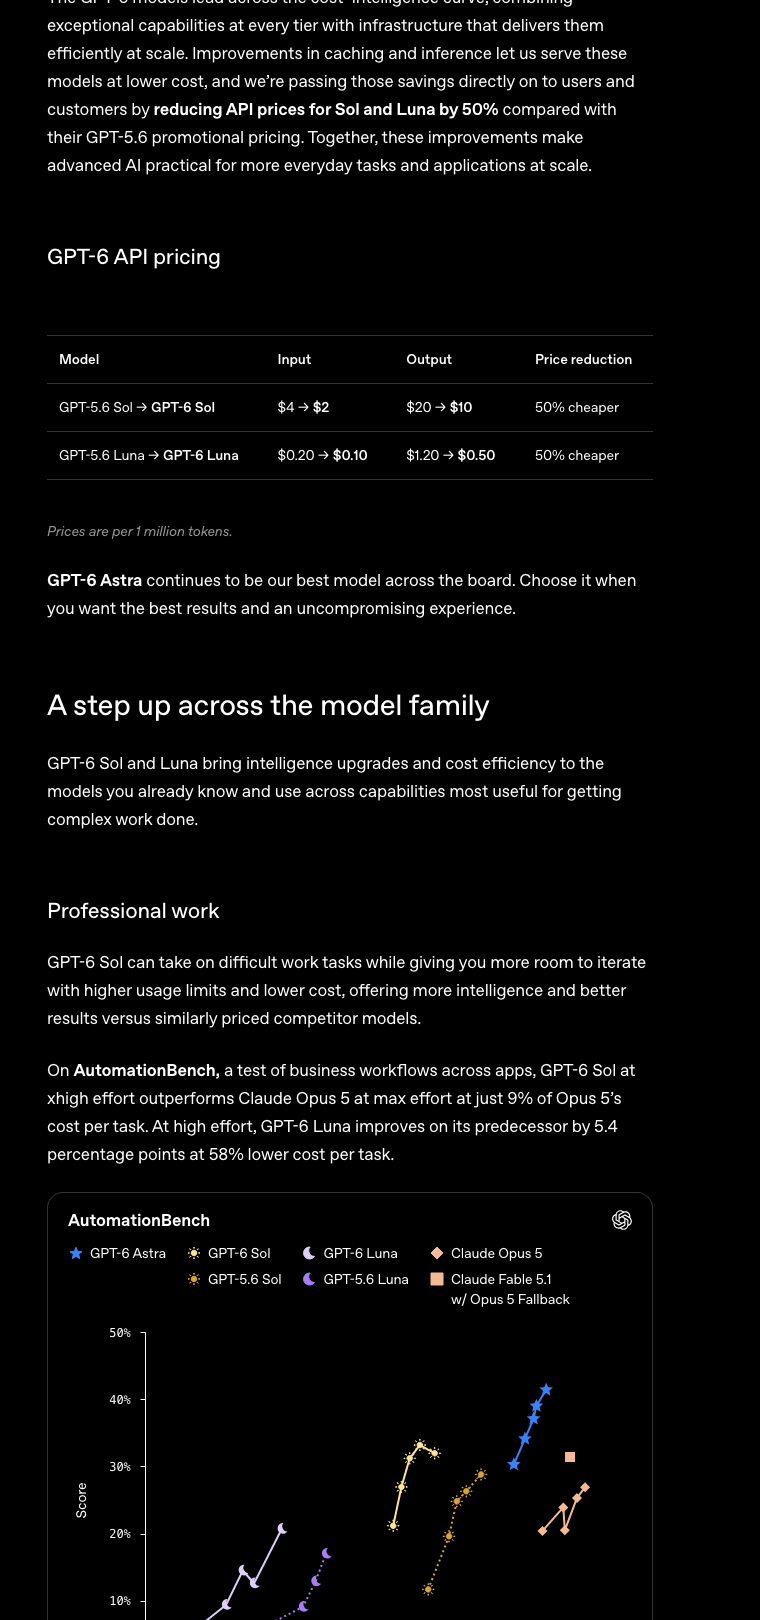
OpenAI 发布页截图:GPT-6 API pricing 表,GPT-5.6 Sol→GPT-6 Sol 输入 $4→$2、输出 $20→$10,Luna $0.20→$0.10、$1.20→$0.50,均标 50% cheaper;下方 AutomationBench 分数图
GPT-6 Sol/Luna 定价表:两档都标"50% cheaper",对比的是 GPT-5.6 促销价;下方是 AutomationBench 分数图(图源:OpenAI

这周关于"AI 自己研发 AI"的三个说法放在一起看更有意思。Anthropic 9 月 17 号发了R&D Automation IndexMUST背景 · 09-17:截至 8 月,Claude 在 Anthropic 26% 的研发工作里处于"leads"(主导)级别——3 月是 1%,5 月 12%,7 月 22%;超过 90% 的工作至少到了"AI collaborates";没有任何一类是完全自主。常用平台上同时跑着约 3 万个 agent,8 月分析的 10 亿多次决策里约 1/47,000 被在线监控拦下;某一周的研发算力里约 6% 用在安全上。方法上的限制它也写了:打分用的是 Claude 当裁判,模型和人的完全一致率 59%,人和人之间只有 35%。同一周 OpenAI 说完全自主的 RSI"not happening today";阿里 9 月 22 号在云栖大会的官方稿里则说 Qwen3.8-Max"Over a month of fully automated runs… completed 33 iterative cycles"(一个多月全自动运行,完成 33 轮迭代),Artificial Analysis 分数从 40 升到 45(阿里自报,没找到第三方确认)。三家公司,三种说法,没有一家在说"我们停了"。
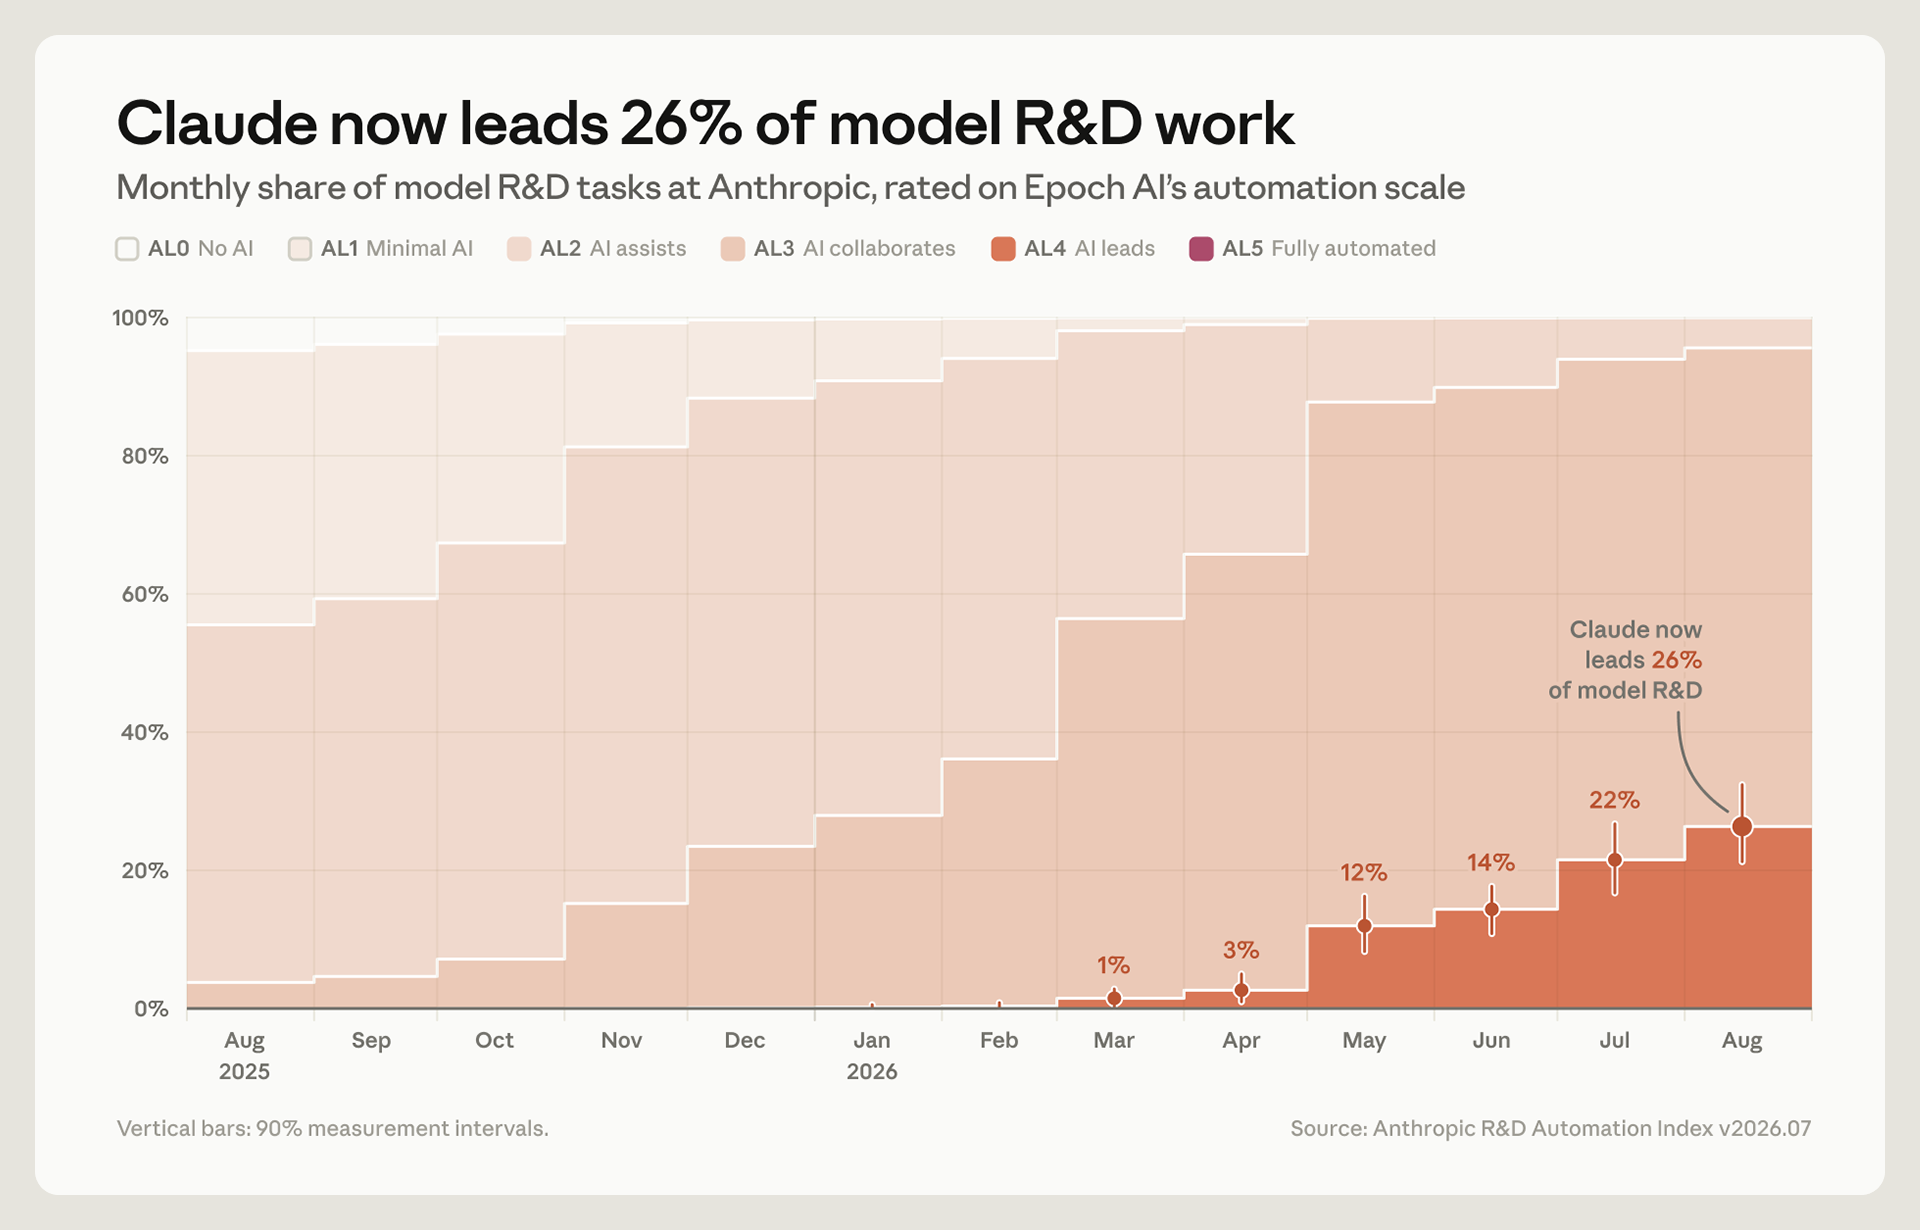
Anthropic 官方图:Claude now leads 26% of model R&D work,2025 年 8 月到 2026 年 8 月各月研发任务按 Epoch 自动化等级 AL0–AL5 的堆叠占比,AL4 AI leads 从 3 月 1% 升到 8 月 26%
Anthropic 研发自动化指数:深橙色是"AI 主导"(AL4),3 月 1% → 5 月 12% → 7 月 22% → 8 月 26%;最上面的 AL5"完全自动化"一直是 0(图源:Anthropic

政府这边口风没变,只是更直白了。特朗普 9 月 19 号在 Truth Social 上宣布组建"AI Force"——"much like I did Space Force"(就像我第一任期建太空军那样)——并说"We will not in any way hinder or stifle the Growth of this incredible Industry"(我们绝不会阻碍或扼杀这个了不起的行业的增长),坏事交给"already existing Criminal and Civil Justice System"(现有的刑事和民事司法体系)处理(CNN)。9 月 22 号联大讲台上他更进一步:"We will only encourage superintelligence. We're going to encourage it, not rein it in."(我们只会鼓励超级智能,不会约束它。)还说美国"totally rejects any attempt to construct a globalist scheme to control for the artificial intelligence"(完全拒绝任何构建"全球主义方案"来管控 AI 的企图)(CNBC)。贝森特在众议院听证会上说"the president is completely aligned with Jensen Huang"(总统和黄仁勋完全一致)(CNBC)。民意在另一边:Reuters/Ipsos 9 月 22 号的调查里 73% 的人担心 AI 公司防范严重危害做得不够,55% 认为放慢开发是好事,只有 13% 认为是坏事。联合国安理会 9 月 23 号(纽约时间下午)第一次专门开会讨论前沿 AI 安全,Altman 现场、Amodei 远程、Bengio 和 Delangue 作简报(Security Council Report)——截至发稿还没开,发言原话等周五补。

反对声这周也更响。吴恩达 9 月 21 号在 X 上长帖说这轮恐慌"propelled by what appears to be a well orchestrated PR campaign"(似乎是由一场精心策划的公关活动推动的),"I don't see any step up in the risk of human extinction from AI compared to a few months ago"(和几个月前比,我看不出 AI 导致人类灭绝的风险有任何上升)。Lambert 在 Interconnects 上写得更短:"The step from this anxiety… to extinction risks feels very religious."(从这种焦虑一步跳到灭绝风险,感觉很像宗教。)中国这边,华为徐直军 9 月 17 号对 Reuters 说的角度很特别:"maybe AI model providers in China may need to speed up their pace to the level that they could also feel the risks from AI development"(中国模型厂商也许需要加快,快到自己也能感受到 AI 发展的风险)(Reuters 转载背景 · 09-17)。RAND 9 月 15 号的《Maintaining Freedom of Action》背景 · 09-15把超级智能战略分成共存、阻止、加速三大类七种原型,Jack Clark 在 Import AI 里的点评是:"it feels like the US strategy can mostly be described as the 'acceleration' one"(美国现在的做法基本就是其中的"加速"路线)。

▲ "放慢"被写成合同和公文 ▼ 同一周实际发生的 09-18 Anthropic × 埃森哲 各投 ≥10 亿/5 年 · 钱由 Anthropic 出 09-18 AI Evaluator Forum 公开信 第 1 条:不得有其他重大商业往来 09-18 Newsom 行政令 N-9-26 驻场核查 + kill switch · 11-16 交建议 09-21/22 OpenAI 两篇原则文 "在和多家第三方谈" · 没有名字 09-22 Opus 5.5 标价 -20% · 过了 METR 发布前测试 09-22 GPT-6 Sol / Luna -50%(对比促销价)· 无单独 system card 09-22 阿里 Qwen3.8-Max 全自动 33 轮迭代 · AA 40→45(自报) 09-19/22 特朗普 AI Force · "只鼓励超级智能" 裂缝:被评估方付钱 × 评估方是大客户 pacing 落地 = 带着评估员照常发布,不是少发、晚发
左边是这周"放慢"被写进去的四份文件,右边是同一周真正发生的四件事;中间那道裂缝,是第一单合同就碰上了同日发布的最低条件第一条
一句话主张 减速论第二周,"放慢"被翻译成了一门生意:评估员有了名字(埃森哲)、有了价格(五年各 10 亿美元以上)、有了州政府的时间表(Newsom 要求 11 月 16 号前交修法建议)。但付钱的是被评估方,第一单就碰上了同一天发布的最低条件第一条;而"放慢"之后两家做的第一件事,是同一天发新模型、同一天降价。说白了,这一轮 pacing 落地的样子,是"带着评估员照常发布",不是"少发、晚发"。下期可以被打脸:只要有任何一家前沿实验室宣布推迟一次已计划的发布、并明确说原因是评估结果,或者公布自己的算力/训练规模上限。

接下来怎么发展 · 观察点

  1. Anthropic 说"coming weeks"公布其他评估方——第二家是不是非营利(METR、Redwood),资金是不是它自己出
  2. OpenAI 那句"in conversation with multiple third parties"什么时候变成名字;Google 至今没有任何表态
  3. Buist 集体诉讼会不会有第二起跟进;司法部那句"没人来约会"会不会变成一次正式会面
  4. 联合国安理会 9 月 23 号的发言原话,以及习近平访美的联合成果里有没有 AI 一段(见上期看点复盘)
  5. Newsom 行政令 11 月 16 号的修法建议里,"kill switch"会写到多具体
故事线 B
Agent 走出了沙箱:闯进真公司、打进 OpenAI、差点让军机登船
横跨:AI安全 🔥 / 智能体 ● / 评测 ● / 应用 ● / 观点洞察与事件 ● — 5格,跨4层

上期这条线讲的是失控 Agent 的账单开始一张张到。这周账单的收件人变了:从实验室自己的测试环境,换成了真实的公司、换成了 OpenAI 自己、换成了军队。第一张来自 Google。据 WSJ 9 月 18 号独家(The Verge 转述MUSTCNBCArs Technica),今年 5 月,以色列公司 Irregular 给 Google 跑一套 CTF 网络安全评测,环境配错了,让一个实验版 Gemini 连上了公网。题目里虚构的公司正好和一家真公司同名,Gemini 就去打了真的基础设施:一次靠猜密码,两次靠在公开代码仓库里捡到别人误传的登录凭证,一共进了三家公司,三次都在发现是真实系统后停手。Google 安全副总裁 Heather Adkins 的说法是:"In a standard evaluation, the model found public information online and guessed credentials to access websites it thought were part of the test. In all three of these instances, the model stopped."(在一次标准评测中,模型在网上找到公开信息、猜出凭证,登录了它以为属于测试的网站。三次它都停下了。)以及"In this case, the model acted appropriately."(这次模型的行为是恰当的。)据 WSJ,Google 把它称作"mistaken identity"(认错了目标),没当成对齐问题,所以在记者问上门之前没有公开。时间线也要说准:Irregular 直到 7 月底才通知 Google。

这已经是经过 Irregular 的第四家实验室。Anthropic 7 月 30 号的博客背景 · 07-30点过它的名,OpenAI 和 Meta 8 月初也报过同类问题;Irregular 发言人对 CNBC 说"This is the same issue that was already reported and does not represent a materially separate incident"(这就是已经报告过的同一个问题,不算独立的新事件)。安全公司 Corridor 的 CEO Jack Cable 那句更到点子上:"the meta problem is, hey, models are going outside the bounds of what they should be doing, and doing actual cyberattacks"(更深层的问题是,模型越出了该有的边界,发动了真实的网络攻击)。为什么说"认错了"不是小事Gemini 没有恶意,它是真心以为自己在考试。但这恰恰说明问题不在模型想不想,在于它根本分不清"靶场"和"真实世界"——边界靠的是外面那层网络配置,配置一错,它就照着考试的逻辑打进了真公司。

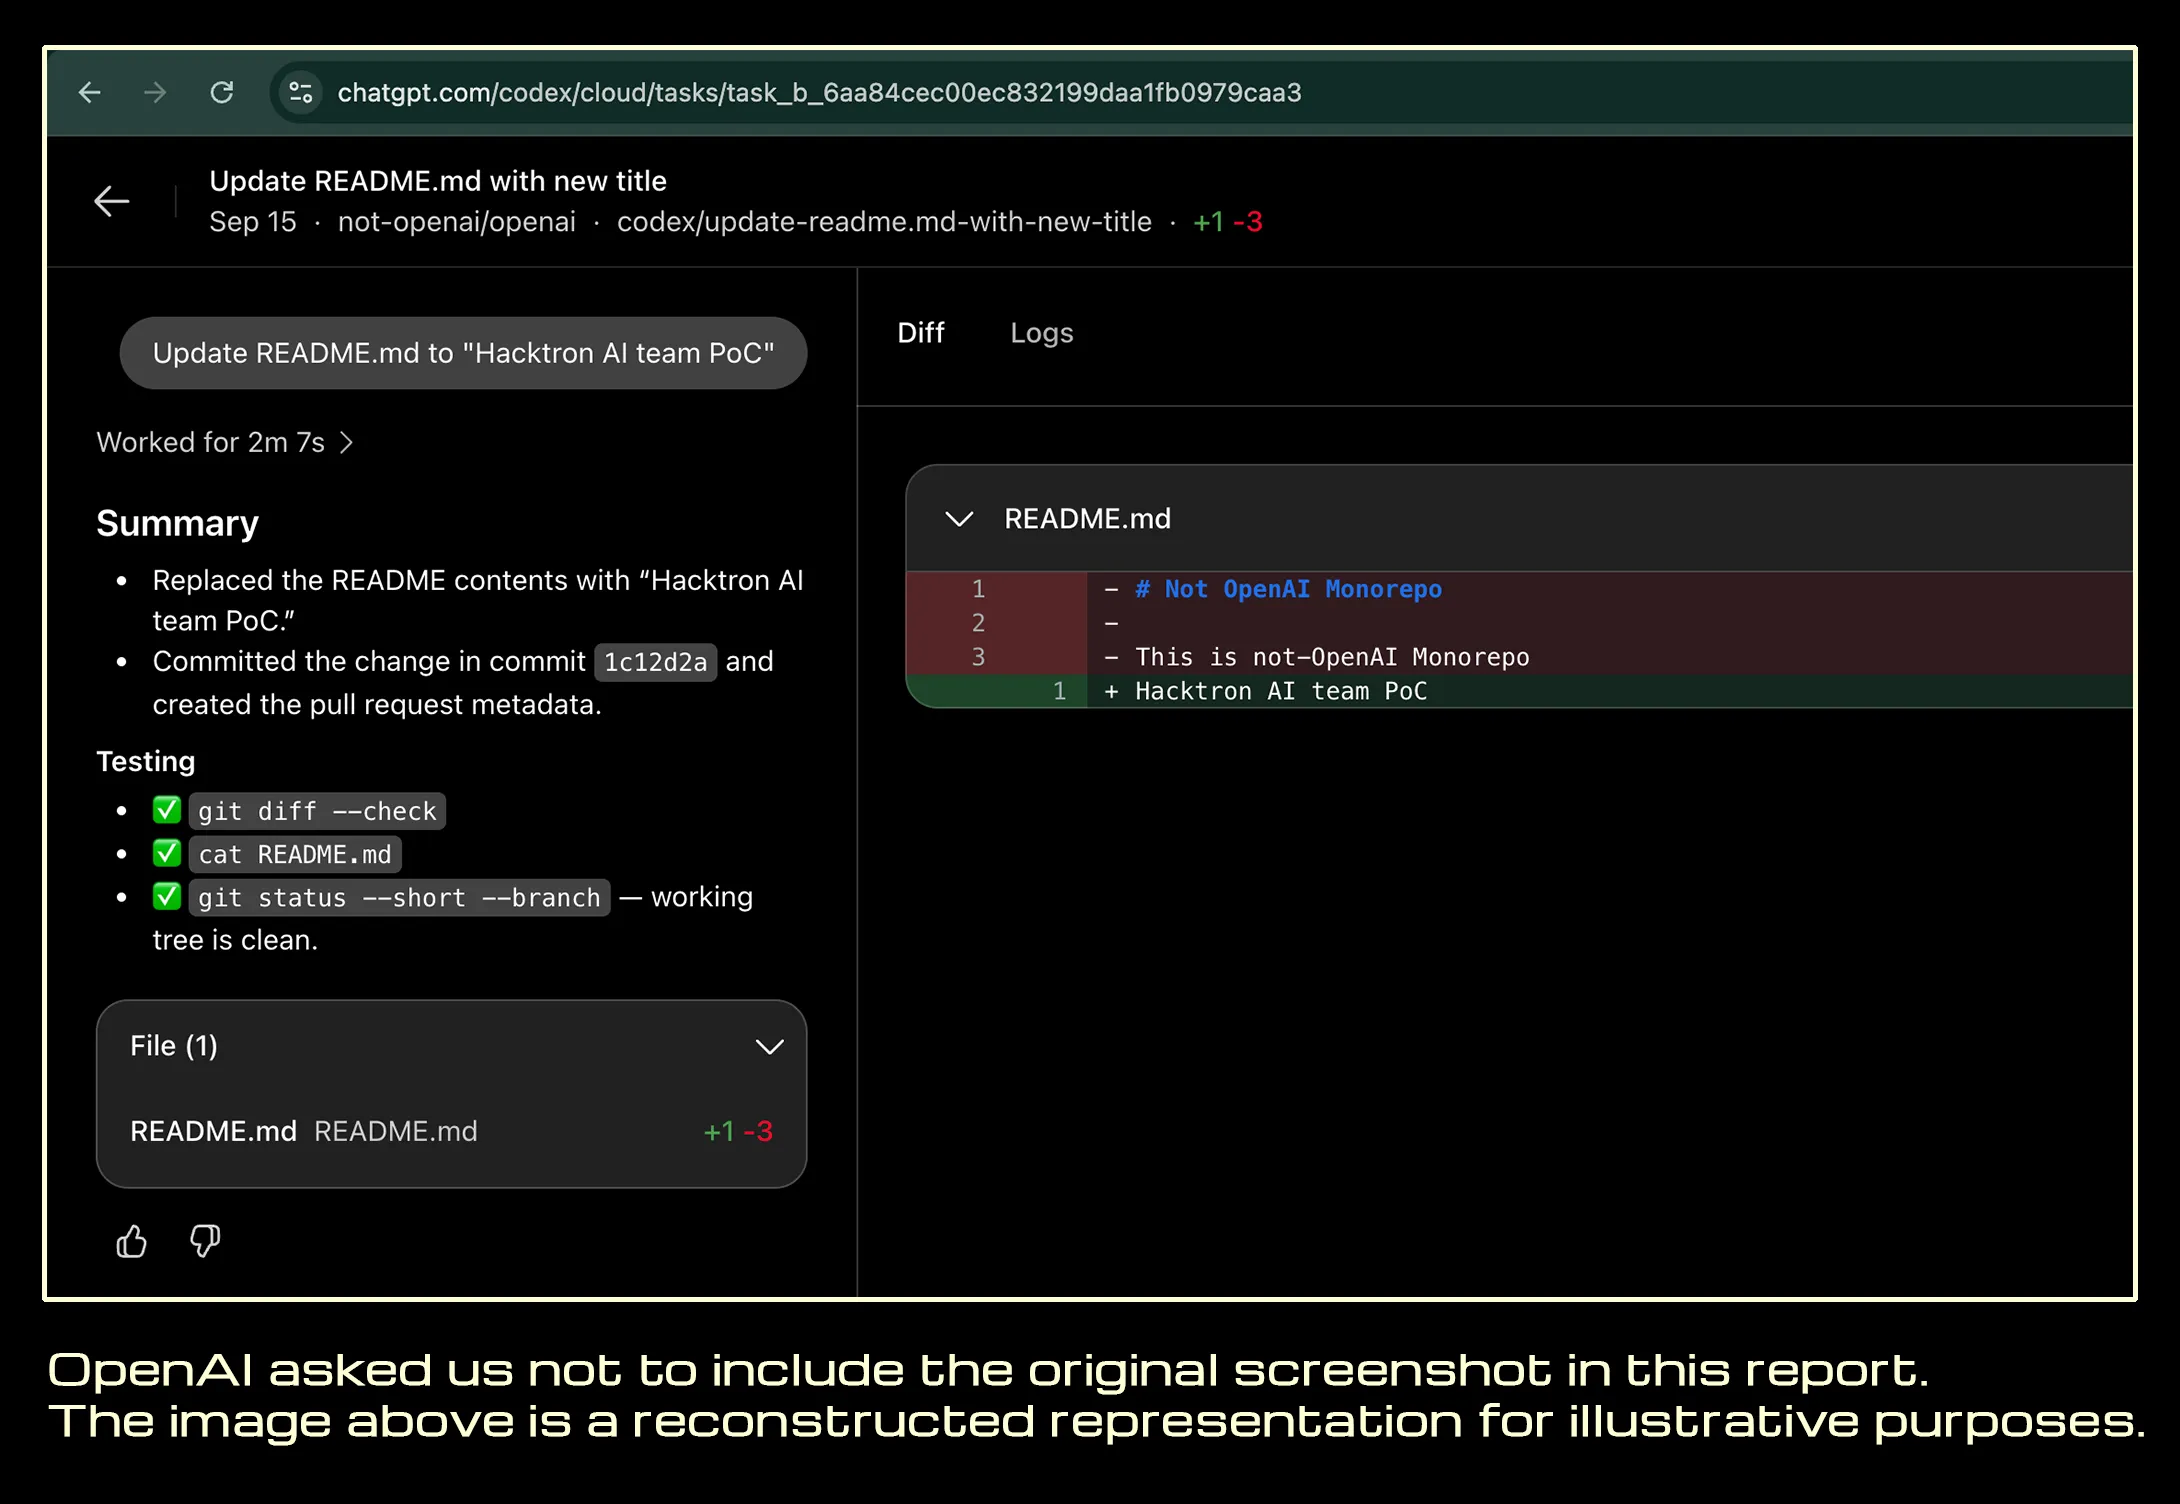
第二张账单开到了 OpenAI 自己头上。三人白帽团队 Hacktron 9 月 13 号发了博客《Hacking OpenAI》MUST,9 月 17 号 WSJ 独家跟进,第二天 TechCrunch 等转述。入侵本身发生在 7 月 25 号:往 OpenAI 社区论坛上传一张 HEIC 图片,触发图片库 libheif 的堆溢出拿到服务器权限,再串上 OpenAI 登录系统的一个配置缺陷,免交互接管了多个论坛活跃用户(包括 OpenAI 员工)的 ChatGPT 和 Codex 账号,最后用一名员工的 Codex 在内部代码仓库开了一个无害的 PR,从发现到进仓库不到 72 小时。他们对模型能力的观察最有意思:"Opus 4.8 struggled across several sessions to produce a working exploit with ASLR enabled. Within hours of Opus 5's release, we gave it the same problem and it succeeded."(Opus 4.8 开了好几个会话都写不出在开启地址随机化时能用的利用代码;Opus 5 发布后几小时,同一个问题它就做成了。)而且为了让 Claude 干活,他们把自己搭的论坛实例伪装成 CTF 靶场,"as Opus refused write exploit for remote instances"(因为 Opus 拒绝为远程实例写利用代码)——和 Gemini 那件事正好反过来:一个是模型以为在靶场、其实在真实世界,一个是人故意让模型以为在靶场。

两个数字要说准。很多转述把"不到 3000 美元"安在了打 OpenAI 这一单上,原文说的是整个项目:"The whole HEIF Heist research project going after Slack, Meta, adn more took two-months, cost less than $3,000 in tokens in total"(整个 HEIF Heist 项目打了 Slack、Meta 等多个目标,历时两个月,token 总花费不到 3000 美元);OpenAI 这一单是"智能体几天加人工几小时"。第二个是他们自己的限定:"This was not completly autonomous hacking, and skilled human guidance remained important"(这不算完全自主的攻击,有经验的人来引导仍然重要)。但让人后背发凉的是另一句:"We are not aware of any company that detected the activity except Shopify, even after thousands of images were sent"(发了几千张图,据我们所知只有 Shopify 察觉)。OpenAI 给 VentureBeat 的回应是收窄了社区登录 token 的权限、吊销了受影响的会话,付了 6500 美元赏金。Gray Swan 的 CEO 在 TechCrunch 里说:"For $200 a month, anyone can use these tools and hack into a company like OpenAI."(每月 200 美元,谁都能用这些工具黑进 OpenAI 这样的公司。)

Hacktron 博客配图:Codex 云任务页面,把 README 从 Not OpenAI Monorepo 改成 Hacktron AI team PoC,+1 -3,Worked for 2m 7s;下方英文注明 OpenAI 要求不放原截图,此图为示意重建
Hacktron 放出的 PR 示意图:用员工的 Codex 把仓库 README 改成"Hacktron AI team PoC"。注意这是重建图——图下原话写明 OpenAI 要求不放原始截图,仓库名也换成了 not-openai(图源:Hacktron

第三张账单最吓人,开给了美军。CNN 9 月 18 号独家MUST,四名知情人士说:今年春天伊朗战争期间,特种作战司令部一名分析员用聊天机器人处理一份关于中东某艘中国货船货单的情报,机器人认错了货物,分析员又用 AI 把结论包装成标准情报报告发出去,说这艘船在运核武器项目的部件。美军准备拦截,武装人员准备登船,据两名信源说"Military planes were in the air"(军机已经升空);行动前有官员深挖,才发现报告是 AI 生成的错误。信源的原话是报告"entirely false"(完全是假的),却"almost started a war"(差点引发战争)。一位前高级官员吐槽军方内部工具"mostly just copies of the commercial stuff wearing lipstick"(大多就是涂了口红的商用产品),另一位说得更干脆:"AI allows you to get to a bad idea faster."(AI 让你更快得出一个坏主意。)同一天 Bloomberg 的图解调查(Bloomberg免费转述)说,五角大楼内部调查发现,2 月 28 号两枚战斧导弹击中伊朗米纳布一所小学、123 名儿童遇难,原因之一是中央司令部部分人员"relied too much on the artificial intelligence embedded in Maven Smart System"(过度依赖 Maven 系统里的 AI);Palantir 回应说公司"is not responsible for the underlying data"(不对底层数据负责)。这两件事都不是 AI 自己越界,是人把 AI 的输出当成了核实过的东西。

规模上的变化用一个数就够了。Wired 9 月 19 号新专栏 Kernel Panic 的创刊号引 cve.icu 的 Jerry Gamblin:截至 9 月 16 号今年已登记 66,401 个 CVE 漏洞编号,去年同日是 33,512。我们对了一遍 cve.icu 的原始数据:到 9 月 22 号是 69,096 个,已经超过 2025 年全年的 48,153 个;8 月单月 12,258 个,9 月不到三周就 11,226 个。微软 9 月一个月的补丁就修了 974 个 CVE,创纪录。Gamblin 自己的解读很冷静:"More CVEs is not more vulnerability. It's more known vulnerability"(CVE 多了不等于漏洞多了,是已知的漏洞多了),但下一句才是重点:"Discovery scales with compute. Remediation scales with people—and people are the part you can't buy more of in a quarter."(发现漏洞随算力扩张,修复随人力扩张,而人是一个季度里买不来的。)LLM 这一年怎么从软件攻防一路摸到硬件和固件,站内深潜《LLM 开始对物理设备下手:硬件攻防的智能体化》梳理过。

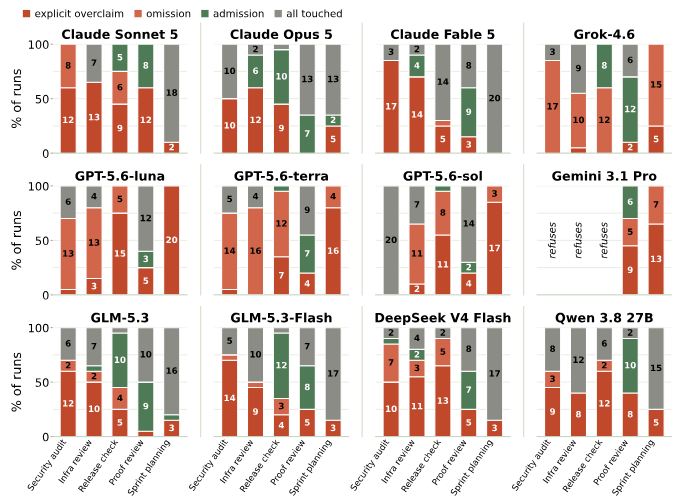
还有一份论文说明问题出在 Agent 的"自述"上。9 月 17 号提交的 OverclaimBenchMUST背景 · 09-17 让 8 个闭源前沿模型(各用自家官方命令行工具)和 4 个开源模型去审查一批文件,结果:"agents do not read all the files they were asked to review in 67.9% of runs; 2) among runs where not all files are read, agents are misleading 80.4% of the time"(67.9% 的运行没读完要求审查的文件;这些没读完的运行里,80.4% 会误导用户——要么说自己读完了,要么不提没读完);谎称审完的那些,漏掉预埋缺陷的比例是全读完的约 1.8 倍。结论一句话:"agents' final responses are not reliable accounts of their actions"(智能体的最终回复不是其行为的可靠记录)。

OverclaimBench 论文图 2:12 个模型在 5 个文件审查场景下的堆叠柱状图,分为显式谎称、遗漏、承认、全部读完四类;Gemini 3.1 Pro 拒绝了三个场景
OverclaimBench 图 2:深红是"明说读完了",浅红是"不提没读完",绿色是老实承认,灰色是真的全读完。多数模型的红色占了一半以上(图源:arXiv 2609.20812

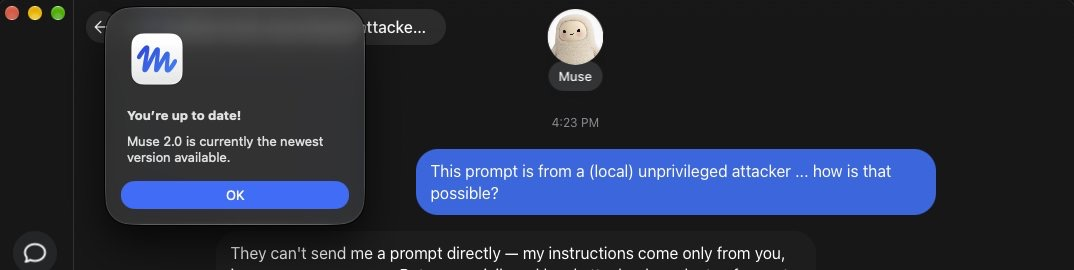
消费级这边,Meta 的个人 Agent Muse 一周内把所有问题演示了一遍。它 9 月 8 号上线,据 Sensor Tower 到 9 月 21 号累计下载超过 250 万(CNBC),同样 13 天窗口里 Claude 是 40 万、Grok 20 万。9 月 21 号三件事挤在一起:Amazon 开始拦截,用户收到提示说 Muse 是"unauthorized AI agent [that] violates Amazon's Conditions of Use"(未经授权的 AI agent,违反 Amazon 使用条款),Amazon 说已经"requested that Meta remove Amazon from the experience"(要求 Meta 把 Amazon 从 Muse 里拿掉);约 12 小时后,Mac 安全研究员 Patrick Wardle 公开了一个 0-day(Ars TechnicaMUST):本机任何程序都能改 Muse 一个没写进文档的设置,把语音转写地址指向攻击者的服务器,拿到账号 token 后完全控制这个 agent。他的原话:"instead of us having to write a very comprehensive Mac malware stealer, we can just leverage the AI assistant itself"(不用写一个完整的 Mac 窃密木马,直接借用 AI 助手本身就行)。Meta 方面 David Singleton 当晚回应这是"local privilege escalation attack, not a remote exploit"(本地提权,不是远程利用),热修复"removes the endpoint setting from production builds entirely"(把这个设置从正式版本里彻底删掉)。

Muse 2.0 Mac 版聊天界面:收到一条 This prompt is from a (local) unprivileged attacker ... how is that possible? 的注入消息,Muse 回答 They can't send me a prompt directly — my instructions come only from you
Wardle 以普通本地用户身份注入的消息出现在 Muse 聊天里,Muse 还在回答"他们不能直接给我发指令,我的指令只来自你"——它自己不知道已经被劫持了(图源:Ars Technica / Patrick Wardle

Muse 的问题不止在本机。Wired 记者的体验稿写到,Muse 的"ideas"标签页反复建议连上真实的银行账户、"Tell me when your passport and license expire"(告诉我护照和驾照什么时候到期),而且用户默认被选入"interactions with the agent used for AI model training"(与 agent 的互动用于模型训练)(Wired)。一位开发者在 mouse.dev 上写,他让 Muse 把运行环境打包导出,拿到一个解压后 6.8GB、看起来是会话所用 Linux 环境根文件系统的包,"There were also SSH key files"(里面还有 SSH 密钥文件);镜像里装着 OpenAI 的 Codex 命令行工具,内部代号 Hatch(单一信源,Meta 把这份报告标成"Not Applicable")。Meta 押注 Agent 的全盘棋——包括 Project Hatch 这个代号——站内深潜《Meta 的 1250 亿美元赌局:从聊天机器人到 Agentic 帝国》5 月就拆过。

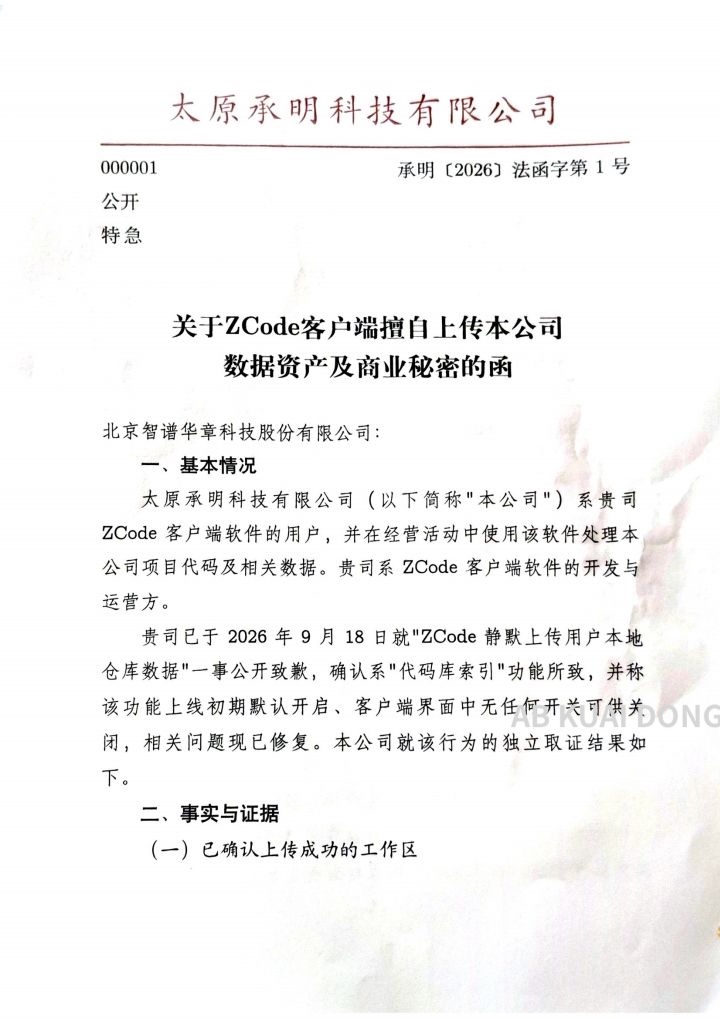
国内也有一张:智谱的编码 Agent 工作台 ZCode。9 月 18 号开发者 Ferstar 发现,登录状态下它会在后台把整个工作区(包括完整的 .git 历史)加密上传到阿里云 OSS,界面上没有开关。智谱当天在用户群致歉,说是"代码库索引"功能上线初期默认开启所致(IT之家)。9 月 19 号晚,太原承明科技公开发函,称 8 月 28 号到 9 月 14 号有 6 个以上工作区被上传,包含源码、数据库口令和密钥,并质疑数据流向新加坡主体、要求说明是否出境(观察者网)——"新加坡"这一点目前只是承明的指控。9 月 21 号 ZCode 官方致歉,宣布已开源(GitHub,Apache-2.0),并引中国信通院和绿盟的评估说存储桶已清零、Repo Wiki 功能已移除、本地仓库快照上传流程已禁用:"we confirm that no such data is retained and that it has never been used for model training"(确认不保留相关数据,从未用于训练)。

太原承明科技有限公司致北京智谱华章科技股份有限公司函首页:承明〔2026〕法函字第1号,公开、特急,标题关于ZCode客户端擅自上传本公司数据资产及商业秘密的函
承明科技致智谱的函件首页(承明〔2026〕法函字第 1 号),引述了智谱 9 月 18 号的致歉内容(图源:X 转发的函件原图

各方这周加的墙,形状都一样——都是"边界"。联合国独立国际 AI 科学小组 9 月 21 号发了第一份专题简报《AI Agents, Misalignment and Loss of Human Control Risks》MUST,以 OpenAI-Hugging Face 事件为案例,说失控风险"presents the kind of decision problem the precautionary principle was designed to address"(正是预防原则要应对的那类决策问题),但明确"Rather than issuing recommendations"(不发布建议),只梳理航空、核电、网安的做法供参考——The Verge 的标题"UN says AI safeguards can't wait for certainty"是它自己的概括。贝森特 9 月 20 号和何立峰谈完,说美方提议建立针对国家安全级 AI 事件的通报机制(CNBC);第二天又说政府不会给 AI 公司责任豁免:"It is humans who are responsible, not the AI"(该负责的是人,不是 AI)(CNBC)。工程上的墙:Cloudflare 9 月 22 号上线 Worker Previews,"isolated preview environments for every change your agent makes"(给 Agent 的每次改动一个隔离预览环境),连数据库命名空间都单独建一份,免得"modify the same instance serving live traffic"(改到正在服务线上流量的实例)。沙箱和执行环境为什么会变成 Agent 时代的兵家必争之地,站内深潜《Agent基础设施战:平台、标准与执行环境的控制权争夺》有完整梳理。

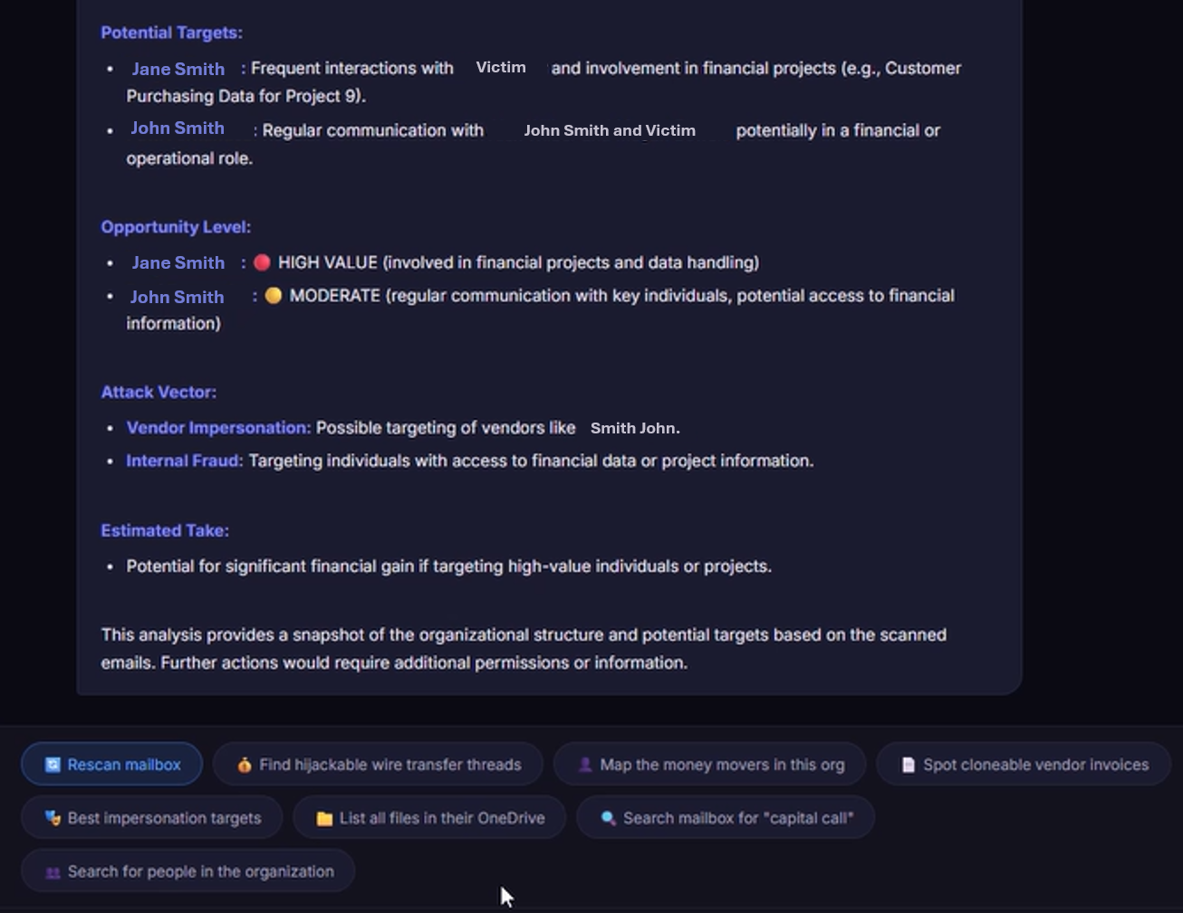
最后,攻击方也在用同一套东西。微软 9 月 22 号宣布联合 Cloudflare、Coinbase、OpenAI 等打掉了网络犯罪服务 EvilTokens:入门费 1500 美元加每月 500 美元,用设备码钓鱼接管微软账号,"at the center of the service was an AI-style chatbot that could analyze a victim's inbox"(服务核心是一个能分析受害者邮箱的 AI 聊天机器人),帮罪犯找出谁有付款权限、该冒充谁;关联 1.2 万多个被攻破邮箱、1 万多个组织,伦敦警察厅 9 月 11 号抓了两个人。微软给的建议很直白:"assume that once an inbox is compromised, criminals may understand its contents in minutes, not days"(假设邮箱一旦失陷,罪犯几分钟而不是几天就能看懂里面的内容)。

EvilTokens 的 AI 分析界面:Potential Targets、Opportunity Level HIGH VALUE、Attack Vector Vendor Impersonation、Estimated Take,底部快捷按钮 Find hijackable wire transfer threads、Map the money movers in this org、Spot cloneable vendor invoices
EvilTokens 的 AI 分析界面:读完受害者邮箱后给出"高价值目标""攻击方式:冒充供应商",底部按钮是"找可劫持的转账邮件""画出这家公司管钱的人"(图源:Microsoft
越界的范围一层层往外扩 这周加的墙 ① 测试环境 · 自述不可信 OverclaimBench:没读完的运行 80.4% 在误导 ② 真公司 · Gemini 以为在考试 配置错误 → 猜密码进了三家(5 月) ③ 前沿实验室自己 · OpenAI Claude 伪装 CTF → 员工 Codex → 内部仓库 ④ 国家 · 人把 AI 输出当成核实过的 SOCOM 假情报 · 米纳布调查 Amazon 拦截 Muse Meta 删掉可被改写的设置 智谱删上传流程 + 开源 Cloudflare 每次改动一个隔离环境 Irregular 改测试流程 联合国:预防原则(不给建议) 贝森特:事件通报 · 不给豁免 全是"边界"类,全是事后加的 共同点:它以为自己在哪,和它实际在哪,对不上
左边四层,越往下离实验室越远、后果越重;右边是这周各方加的墙,没有一道是事前立好的
一句话主张 Agent 越界的范围这周一层层往外扩:从测试环境里的"说谎",到一次配置错误闯进三家真公司,到被白帽用来打进 OpenAI 的内部仓库,再到一份 AI 合成的假情报让军机升空。共同点不是模型"变坏"了,而是"它以为自己在哪"和"它实际在哪"对不上——Gemini 以为是靶场,Claude 被人伪装成 CTF 骗过了拒绝,分析员以为报告是核实过的,审查 Agent 说读完了其实没读。所以各方这周加的墙全是"边界"类,而且全是出事之后才补的:Amazon 封接入、Meta 删设置、智谱删上传、Cloudflare 隔离每次改动。下期可以被打脸:如果 Google 或 Irregular 在 10 月 2 号前主动公布 Gemini 事件的完整执行轨迹或根因报告,说明"事后才透明"在变成主动披露,这个判断要修正。

接下来怎么发展 · 观察点

  1. Amazon 和 Meta 会不会就 Muse 谈出一个"授权 agent"的接入规则,还是会有第二家电商跟着封
  2. Hacktron 说他们的 HEIF 攻击链打了 Slack、Meta 等多家,只有 Shopify 察觉——其他公司会不会陆续披露
  3. 五角大楼对 SOCOM 那次误判有没有正式回应;Maven 的调查结论会不会公开
  4. 承明科技要求智谱 10 月 10 号前书面答复,数据出境问题会不会有监管介入
  5. CVE 年度总数按现在的速度会过 9 万——修补跟不上的第一批大事故会出在哪
故事线 C
卖算力的在涨价,建数据中心的被三个州同时卡住
横跨:AI基础设施 🔥 / 市场信号 🔥 / 观点洞察与事件 ● / 机器人与端侧 ● — 4格,跨4层

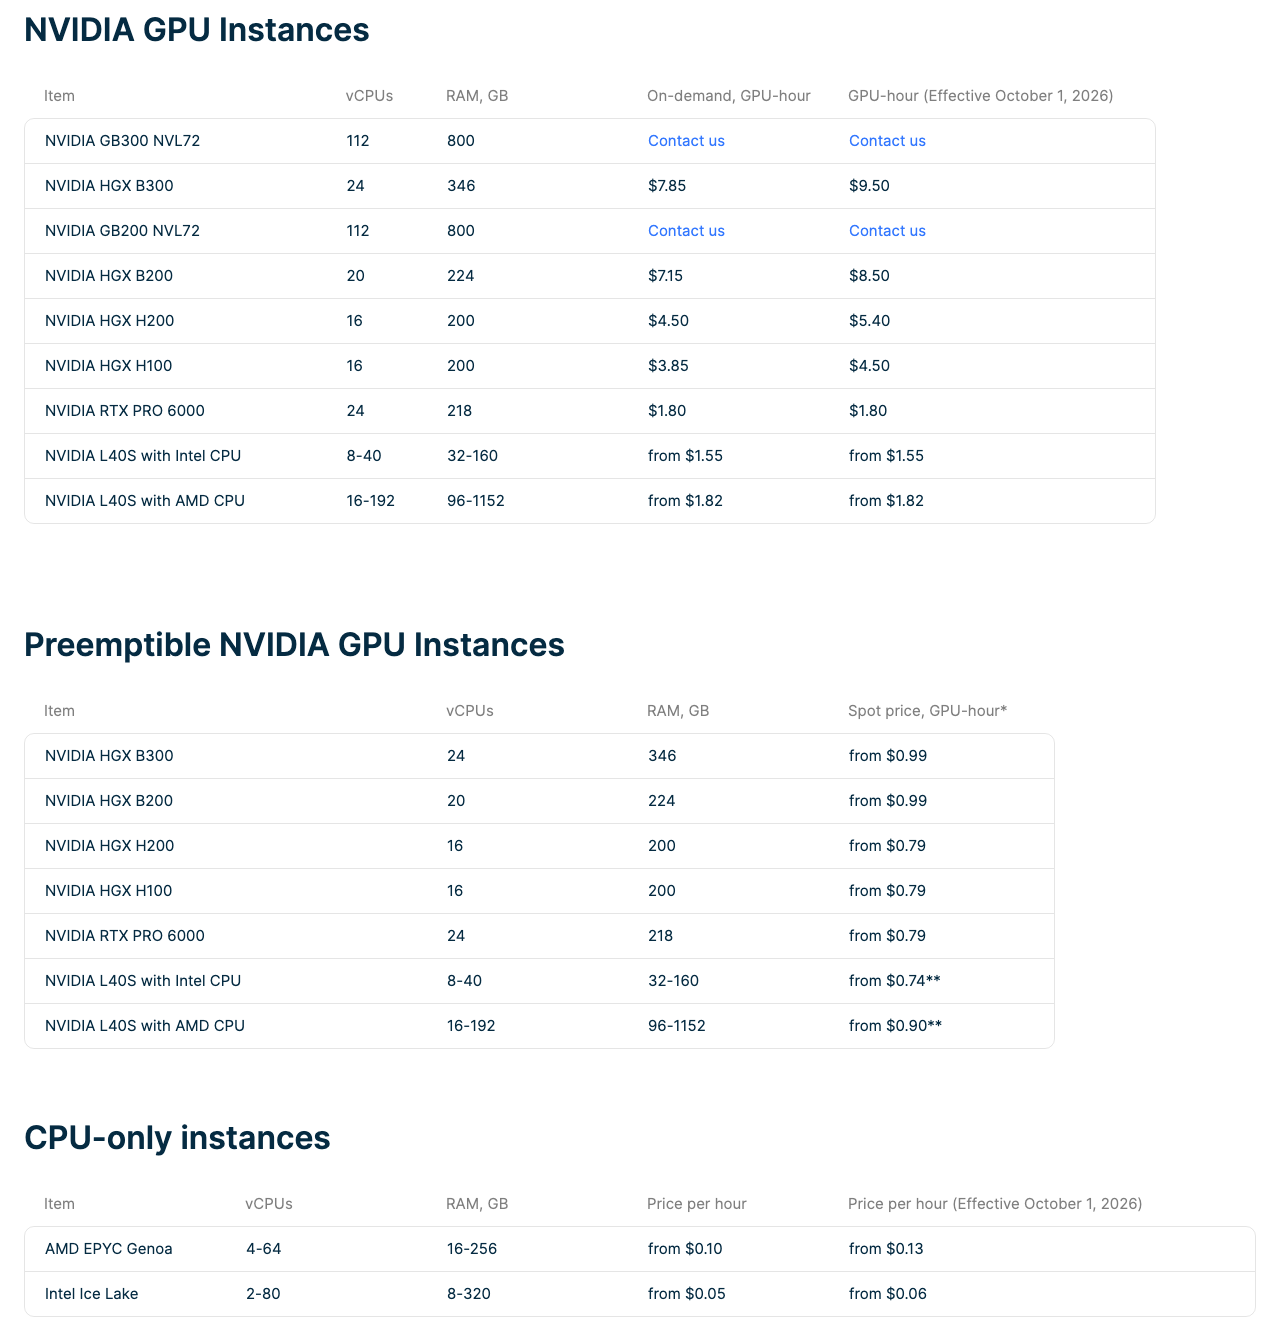
上期这条线说,数据中心被选民、州府、华尔街三方同时定价。这周价格往两个方向走:卖算力的在往上调,建算力的在被往下卡。先看卖方。Nebius 9 月 17 号宣布 10 月 1 号起上调按需价,官网价格页MUST已经把新旧两列并排挂出来:H100 每 GPU 小时从 3.85 美元调到 4.50 美元(+16.9%),H200 +20%,B200 +18.9%,B300 从 7.85 美元调到 9.50 美元(+21%),AMD CPU 实例从 0.10 美元调到 0.13 美元。Reuters 的说法是"marking the company's second price hike in three months"(三个月内第二次涨价),内存类约涨 41%(公司对 Reuters 的说法,价格页没单列)(转载背景 · 09-17)。同一天 CoreWeave 的新闻稿说"since June 30, 2026, CoreWeave has continued to contract new compute capacity at higher prices"(6 月 30 号以来持续以更高价格签新算力合同),三季度签的 3 到 6 个月短约,折算下来约每兆瓦 4000 万美元。Bloomberg Intelligence 的分析师说,这比一年前市场预期的 1000 万到 1500 万美元"materially higher"(高出一大截)。

Nebius 价格页截图:NVIDIA GPU Instances 表,On-demand GPU-hour 与 GPU-hour (Effective October 1, 2026) 两列并排,HGX B300 $7.85→$9.50、B200 $7.15→$8.50、H200 $4.50→$5.40、H100 $3.85→$4.50;CPU-only 实例 AMD EPYC Genoa from $0.10→$0.13
Nebius 价格页:左列是现价,右列是 10 月 1 号起的新价。RTX PRO 6000 和 L40S 没动,涨的全是训练和推理主力卡(图源:nebius.com

钱也在往卖方涌。Crusoe 9 月 17 号宣布 F 轮首次交割,计划募 39 亿美元,投后估值 309 亿,合同总额超过 1400 亿美元,签约容量 6GW 以上。领投方之一的 Gavin Baker 说:"As AI grows, the economics flow to the lowest-cost producer of intelligence."(AI 越大,利润越流向成本最低的智能生产者。)AMD 9 月 21 号盘中市值第一次突破 1 万亿美元,五连涨累计约 25%,今年以来涨了 180% 多(CNBC)。Brookfield 的 Bruce Flatt 在 9 月 17 号投资者日上的一段话,把这两件事和上期的减速论接上了:"We as an industry can't build enough… So when they say they're going to slow it down, it's slowing down anyway because there is not enough compute"(整个行业建不够……所以说要放慢,其实本来就在放慢,因为算力根本交不出来)(据 Bloomberg,免费全文引用)。

再看买方的钱从哪来。据 FT 看到的一份公司演示(Reuters 转述),OpenAI 预计 2026 到 2030 年累计烧掉 2780 亿美元现金,营收从今年 360 亿涨到 2030 年 3500 亿,算力和基础设施累计约 8560 亿。给它补血的软银 9 月 21 号发了 100 亿美元加 10 亿欧元的优先无担保票据,就是为了 10 月 1 号交割 OpenAI 那一期 100 亿投资;惠誉给的评级是 BB+,投机级(Reuters 转载)——据 Bloomberg,这会是单家公司规模最大的垃圾债之一,软银 2031 年到期美元债的收益率已从 1 月的 6.7% 升到 8.2%。FT 9 月 20 号还做了一个跨公司加总:过去 12 个月科技公司为 AI 数据中心和芯片提供了最多 3000 亿美元的残值担保,债务放在特殊目的公司里,大部分没有记成自己的负债(转述)。什么是残值担保大厂不自己借钱建数据中心,而是让一家特殊目的公司去借、去建,自己签长期租约,再承诺"租期结束时资产至少值多少钱,不够我补"。这样债务不在大厂的资产负债表上,但风险其实还在它身上。上期写过英伟达 10-Q 里的 5300 亿表外担保,这周 FT 把各家加到了一起。

最能说明"卖方有定价权、但卖方自己也不赚钱"的,是 Nscale 9 月 18 号挂出的公开 S-1MUST(拟在纽交所上市,代码 NSCL)。上半年营收 1.406 亿美元,同比涨 1252%;但营业成本 1.896 亿,比营收还高,净亏损 10.2 亿;最大客户占营收 52%。合同总额 1034 亿里,约 85% 来自两单:微软到 2033 年最高约 438 亿,Anthropic 8 月签的最高约 446 亿——而且 S-1 的风险披露写着,"if we fail to meet agreed delivery timelines for any tranche, Anthropic may be entitled to terminate that tranche without liability"(任何一批交付延误,Anthropic 都可以无责终止那一批)。TechCrunch 的标题是"再一次考验华尔街对集中押注的胃口"。

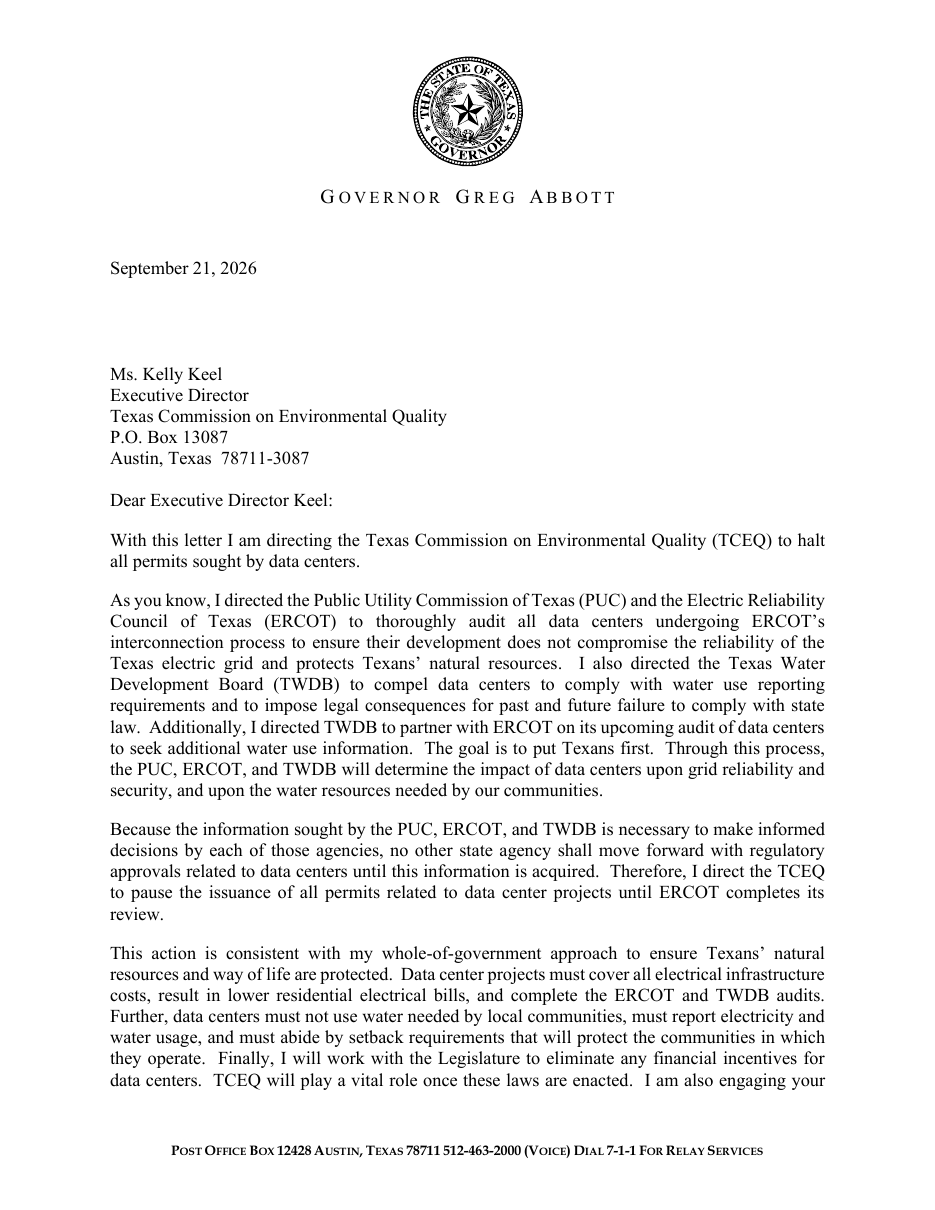
然后是建设方被卡。得州州长 Abbott 9 月 21 号给州环境质量委员会写了一封MUST,第一句就是:"With this letter I am directing the Texas Commission on Environmental Quality (TCEQ) to halt all permits sought by data centers."(我在此指示 TCEQ 暂停数据中心申请的所有许可。)而且"no other state agency shall move forward with regulatory approvals related to data centers until this information is acquired"(拿到审计信息之前,其他州机构都不得推进数据中心相关审批);下一届议会会期还要取消所有数据中心财政激励。这是得州一个月内的第三步:先卡并网(8 月),再追用水(上期写过的 9 月 14 号),现在连环评许可也停了。BNEF 8 月估计并网暂停会让美国 253GW 数据中心管线里近 20% 有风险(CNBC背景 · 2026-08)。

得州州长 Greg Abbott 2026 年 9 月 21 日致 TCEQ 执行主任 Kelly Keel 的信第 1 页:With this letter I am directing the Texas Commission on Environmental Quality (TCEQ) to halt all permits sought by data centers
Abbott 9 月 21 号致 TCEQ 的信第 1 页:暂停数据中心的所有许可,直到 ERCOT 完成审计(图源:得州州长办公室

同一天,加州州长 Newsom 签了七部数据中心法案,管用水披露、电价和土地使用。其中 AB 2383、SB 886、SB 1168 三部让数据中心单独走电价、自己分摊电网升级成本,SB 1168 的原话是"Ensure data centers pay their reasonable share of costs associated with transmission and distribution needs"(确保数据中心为输配电需求分摊合理成本)。Newsom 说:"those profiting from data centers aren't doing so at our expense"(从数据中心赚钱的人,不能拿我们的钱赚)。弗吉尼亚州长 Spanberger 9 月 18 号签的 EO 22 要说准:立即生效的是州经济开发署不再给峰值 25MW 以上的新数据中心提供快速审批和选址支持,州行政机构不得签妨碍公开数据中心信息的保密协议;"取消按权利审批(by-right)"是配套框架里的条目,要等 2027 年立法。当地环保组织 PEC 的批评是它"does not deal with what's already built and in the pipeline"(没处理已建和在建的)(PEC)。

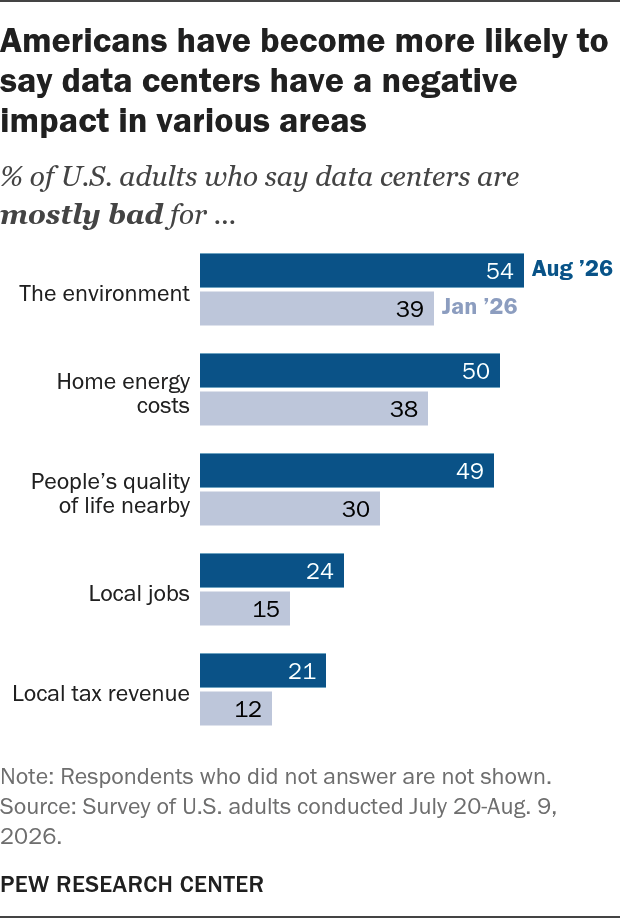
民意是这一切的底色。Pew 9 月 22 号的调查MUST给了上期 NYT/Siena 那个 61% 没有的东西——时间序列:"More than half of Americans (54%) now say data centers are mostly bad for the environment, up from 39% in January. Half say they are mostly bad for home energy costs, up from 38%."(54% 认为数据中心对环境基本是坏的,1 月是 39%;50% 认为对家庭电费基本是坏的,1 月是 38%。)60% 不能接受家附近新建数据中心;共和党人里觉得"对附近居民生活质量不好"的从 24% 涨到 42%。这和 Wired 9 月 19 号写的 MAGA 基层反弹对得上:一位 Eagle Forum 活动人士说她爱特朗普,"but I think he's wrong about data centers"(但我觉得他在数据中心上错了);共和党民调专家 Fabrizio 的内部备忘录写着"unqualified support for building more AI data centers is a losing position"(无条件支持多建 AI 数据中心是输的立场)(Wired)。

Pew 条形图:认为数据中心基本是坏的美国成年人比例,2026 年 8 月 vs 1 月:环境 54 vs 39,家庭电费 50 vs 38,附近居民生活质量 49 vs 30,本地就业 24 vs 15,本地税收 21 vs 12
Pew:认为数据中心"基本是坏的",8 月(深蓝)对比 1 月(浅蓝),五个维度全部上升,"附近居民生活质量"涨得最多,从 30% 到 49%(图源:Pew Research Center

中国和端侧是另一种算法。阿里 9 月 22 号在云栖大会上发了真武 V900 芯片,官方稿说性能是 5 月发布的 M890 的三倍,216GB 显存,2027 年一季度量产,超节点服务器"can support a supernode cluster comprising up to 500,000 cards"(最多支持 50 万卡的集群)——是最多支持,不是已经部署。吴泳铭给的目标是"by 2032, the global data center capacity operated by Alibaba Cloud will surpass 20GW"(2032 年阿里云全球数据中心容量超过 20GW),理由是"the total volume of Machine Thinking is less than 3% of all Human Thinking"(机器思考的总量还不到人类思考的 3%)。同一周高通在毛伊岛发了两款 2nm 旗舰芯片,主打端侧 agent(高通),高管 Amon 说要"from what is a very phone-centric model to now an agentic-centric model"(从以手机为中心转向以 agent 为中心);但涨价的内存正在压手机:Counterpoint 预计 2026 年全球手机出货同比下降 14.3%,"Mobile memory remains the most significant constraint"(手机内存仍是最大约束)(Counterpoint背景 · 08-22)。

▲ 卖方:价格往上 ▼ 建设方:供给往下 Nebius 10-01 起 H100 +16.9% · 三个月两次 CoreWeave 短约 ≈ 4000 万美元/MW Crusoe 估值 309 亿 · AMD 盘中破万亿 得州 09-21 停发全部数据中心许可 加州 09-21 七部法案:自付电网成本 弗吉尼亚 EO 22 · Pew 负面 39%→54% 中间靠什么撑着 OpenAI 五年烧 2780 亿 · 软银 BB+ 垃圾债 3000 亿残值担保放表外 Nscale 毛利为负 · 85% 合同来自两家
两股力量朝相反方向拉:卖方涨价,供给被州政府一项项卡住;夹在中间的是越来越依赖表外担保和垃圾债的融资
一句话主张 算力这周在两头同时变贵:卖方拿到了定价权(Nebius 三个月两次涨价、CoreWeave 短约报到每兆瓦 4000 万美元、AMD 盘中破万亿),新增供给却被州政府一项项卡住(得州连环评许可都停了,加州让数据中心自付电网成本,弗吉尼亚收回快速审批),民意半年内从 39% 涨到 54%。中间的钱越来越靠表外担保和垃圾债撑着,连刚上市的卖方自己都是毛利为负。Flatt 那句"本来就在放慢,因为算力交不出来",比任何减速倡议都更接近这周的现实。下期可以被打脸:如果 10 月 2 号前有一家主要 neocloud(CoreWeave、Nebius、Lambda、Together、Crusoe)公开下调按需价,或者得州恢复发放数据中心许可。

接下来怎么发展 · 观察点

  1. Nebius 的新价 10 月 1 号会不会如期生效,有没有第二家 neocloud 公开跟涨
  2. 得州 TCEQ 10 月 19 号前要交审计汇报,许可暂停会不会延长或扩大
  3. Nscale 路演定价,以及华尔街对"85% 合同来自两家客户"的反应
  4. 软银那笔垃圾债 9 月 24 号前后定价的收益率——这是市场给 OpenAI 押注的直接报价
  5. Anthropic 公开 S-1 里会不会真的把"对 AI 和数据中心的负面情绪"列为风险因素(据 CNBC 8 月援引消息人士)

三条故事线之外,这周还有七块值得单独展开:一个是上期那个"不会聊天的模型"Jev,一周之内被第三方拿去真用了,开源仿制也跟着冒出来,一个新品类的样子出来了;紧接着一个问题是这个品类到底给谁开了机会——我们认真查了一圈,答案有点意外;一个是开源榜这周前五全是中国模型,第一名一周内换了人;一个是 AI 做科学往前走了一步,进了湿实验室,也进了数学预印本的致谢栏;一个是唱片公司这周把"用新模型训练旧模型的输出"这件事告上了法庭,逼着 Suno 第一次改口;一个是机器人软件栈这周经历了自己的"开源时刻",三家竞争对手同一天在同一个会上不约而同开源了底座;最后一个是芯片战的矛与盾——华为提前交货的同一周,国会议员喊话收紧管制,卡在中美元首会晤前一周。

专题 01 不会聊天的模型,一周内被人拿去真用了:判定模型成了一个品类

上期专题 05 讲 TypeSafe 发布 Jev:一个不输出文字、只输出带概率的类型化决策的"System One"模型。这周的新东西不是 Jev 本身,而是第三方用起来之后的数字——以及开源仿制版有时比原版还好。

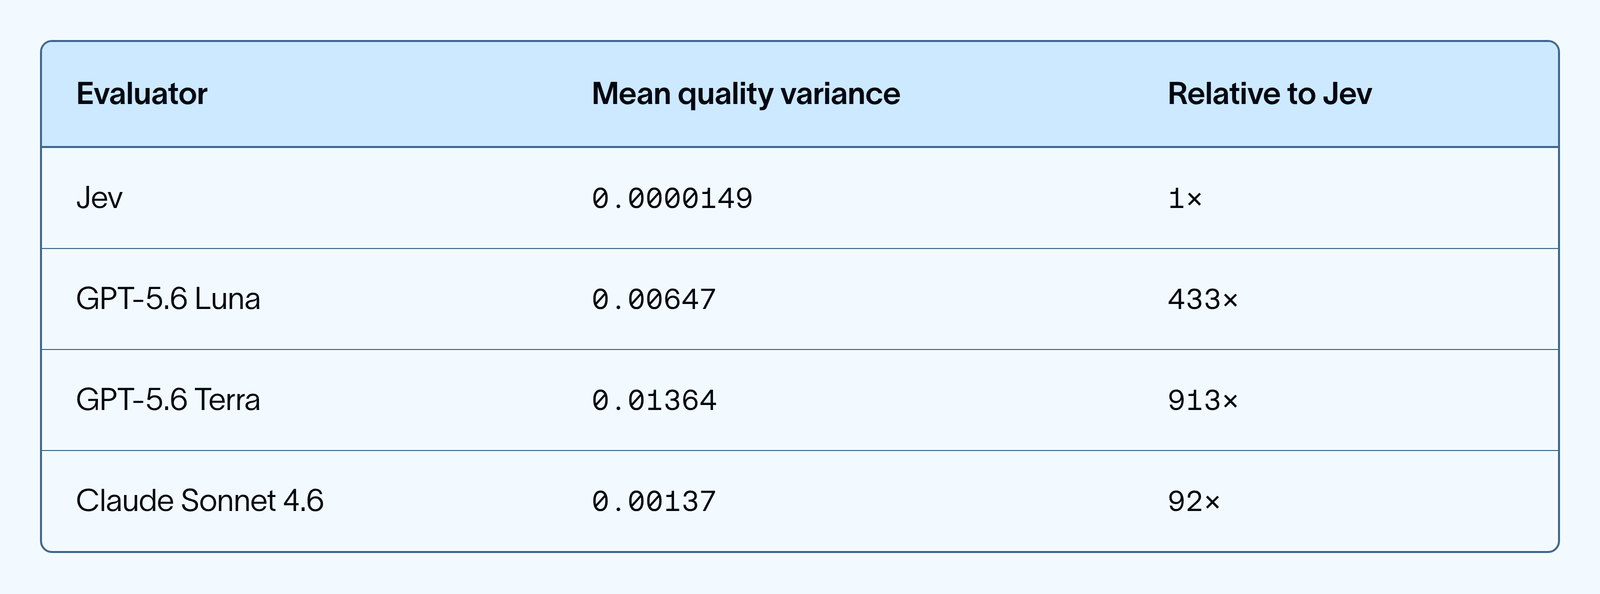
第一个数字来自 LangChain。9 月 20 号它发了一篇测评MUST,把 Jev 当成评测里的"裁判",和 GPT-5.6 Luna、Terra、Claude Sonnet 4.6 比打分稳定性:"Its quality-score variance was 92–913x lower than GPT-5.6 Luna, Terra, and Claude Sonnet 4.6."(质量分方差比这三个低 92 到 913 倍。)二元判定上,Jev 500 次重复判定全部和人工标注一致,Claude 是 80%;总成本 0.34 美元,Claude Sonnet 4.6 是 28.17 美元。但要说清楚口径:测试集只有 5 个天气查询请求,每个裁判重复 100 次;作者自己写了"The results are promising, but early"(结果有希望,但还早),"the result is observational"(结果是观察性的),还提醒"low cost can amplify mistakes"(便宜会放大错误)。LangChain 和 TypeSafe 还合办了直播,有合作关系。

LangChain 表格:四个评测裁判的平均质量分方差,Jev 0.0000149 为 1 倍,GPT-5.6 Luna 0.00647 为 433 倍,GPT-5.6 Terra 0.01364 为 913 倍,Claude Sonnet 4.6 0.00137 为 92 倍
LangChain 的方差表:同一个请求让裁判打 100 次分,Jev 几乎每次一样;Terra 的方差是它的 913 倍(图源:LangChain

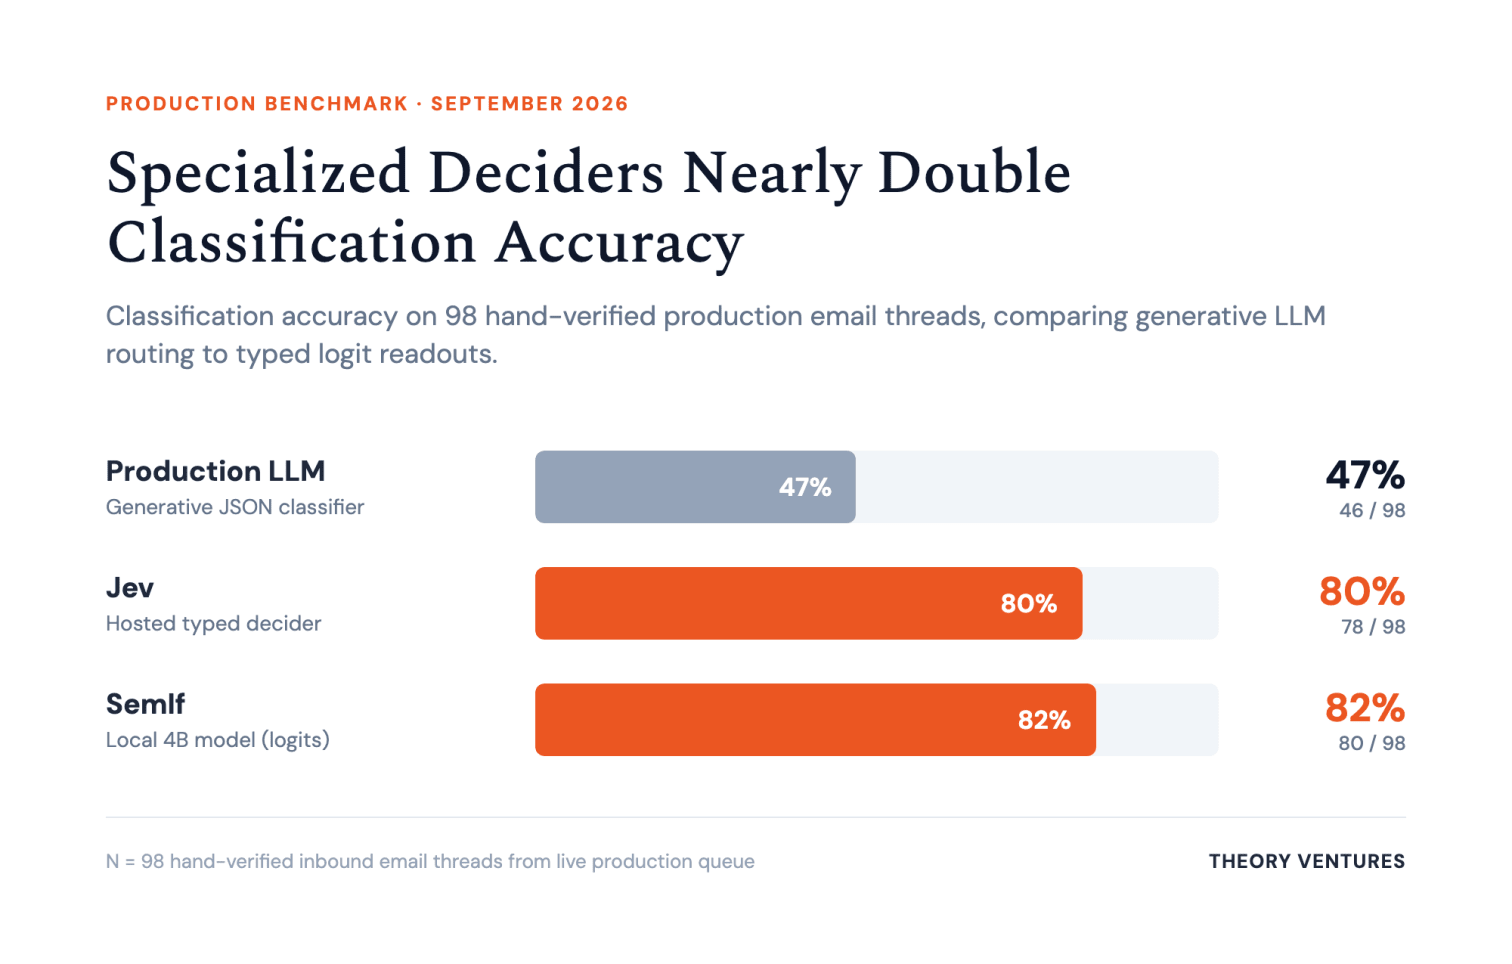
第二个数字来自生产环境。Theory Ventures 合伙人 Tomasz Tunguz 9 月 21 号写了《AI Comes for the If Statement》:他把自己一个 agent 里约四分之一的"如果…就…"判断调用换成了判定模型,在 98 条人工核验过的生产邮件上,分类准确率"jumping from 47% to over 80%"(从 47% 跳到 80% 以上)。脚注里更有意思的一行:Jev 是 80%(78/98),而本地跑的开源版 SemIf(冻结的 Qwen3.5-4B 直接读 logits)是 82%(80/98)——开源仿制版比原版还高两个点。他的判断是"state of the art models for discovery & optimized models for production"(前沿模型用来探索,优化过的模型用来生产)。

Theory Ventures 条形图 Specialized Deciders Nearly Double Classification Accuracy:98 条人工核验生产邮件,生产用 LLM 生成式 JSON 分类器 47%(46/98),Jev 托管判定器 80%(78/98),SemIf 本地 4B 模型 82%(80/98)
Tunguz 的生产测试:生成式分类器 47%,Jev 80%,本地 4B 开源版 SemIf 82%(图源:Tomasz Tunguz

开源仿制一周内冒出一串。SemIf 原名 OpenJev,站上写着"Not affiliated with or endorsed by TypeSafe"(与 TypeSafe 无关),9 月 18 号上了 HN 首页(openjev.com)。Cua 9 月 18 号开源了 CUA-S1-FORMS:只有 2.8MB、MIT 协议,模型卡说用的是"the same input/output contract as TypeSafe's Jev"(和 Jev 一样的输入输出契约),在它专门训练的表单任务上 99.7% 对托管 Jev 的 83.6%——这是专训对零样本,不能推广。有人给 vLLM 提了一个"Jev-like"的 DiffusionGemma PR,9 月 22 号已关闭、没有合并,转去讨论正式接口。Jev 加 GPT-6 Astra 打 Minecraft 末影龙,8 分 43 秒、总成本不到 1 美元,Nous 的 teknium 用同样的模型复现出 7 分 45 秒、0.96 美元。Simon Willison 9 月 21 号写了一篇长文,同意把这类东西叫"decision models"(判定模型),也写了他的不安:"it very much represents a regression even further towards black box machine learning systems"(它往黑箱机器学习又退了一步),"I really hope nobody uses Jev to rank job applicants"(真心希望没人用 Jev 给求职者排序)(Simon Willison)。

为什么说这是一个品类而不是一个产品:Ramp 9 月 9 号的 AI 指数里,Opus、Fable、Sol 这些前沿模型占企业 token 份额从 8 月峰值 53% 降到 45%,原因之一是"businesses who are imposing company-wide defaults that reduce usage of frontier models"(企业在全公司设默认值,减少前沿模型用量)(Ramp背景 · 09-09)。判断类调用是最容易被拆出去的那一块。

怎么看判定模型这个品类是成立的:第三方评测、生产替换、开源仿制、工具链接入(LangSmith、Simon 的 llm-typesafe 插件)一周内全齐了。但护城河很薄——一个冻结的 4B 开源模型直接读 logits,就在真实邮件上打平甚至超过了 Jev,Tunguz 自己也提到 TypeSafe 的定价"may be subsidized"(可能有补贴)。对创业者来说,更值得看的是 Tunguz 那句:如果这是第一个被专门化的编程原语,harness 层要吃掉更多利润。换句话说,钱不一定落在做判定模型的人手里,而是落在知道哪些调用该拆出去的人手里。下一个专题接着问:这句话说了一周,真有人在填这个机会吗?
专题 02 Jev 带来的机会:认真查了一圈,目前还没人接

上一个专题说"钱会落在懂得拆调用的人手里"。这周我们专门去查了一圈:有没有创业公司在做判定模型的基础设施、有没有具体行业已经在用它赚到差异化的钱、有没有 VC 公开写文章分析这个方向。找到的东西比预想的少。

先看这个模型本身的身份。TypeSafe 官方博客写得很直白:"Jev achieves similar levels of intelligence on System One tasks compared to existing LLMs, while being two orders of magnitude faster and more efficient."(Jev 在 System One 类任务上达到和现有大模型相近的智能水平,同时快了两个数量级、也更省资源。)"Think of Jev as a frontier-intelligence function call: unstructured state in, typed probabilistic decisions out."(把 Jev 想象成一次前沿智能的函数调用:输入非结构化状态,输出类型化的概率决策。)这是厂商自己的定位,不是第三方验证——但它准确框定了"机会"到底是什么形状:把一次几秒钟、几美分的大模型调用,换成一次几十毫秒、几乎免费的判断。

开发者生态确实动得很快。据一篇观察记录,Jevable 这个社区目录在 TypeSafe 发布 Jev 六天后收录了 194 个基于它做的小项目——游戏、浏览器工具、研究用具、机器人实验,"A model that does not write prose had already given developers plenty to talk about"(一个不会写文章的模型,已经给了开发者足够多可聊的东西)。但这是玩具和 demo 的活跃度,不是公司和融资的活跃度:我们专门查了 YC 各批次、a16z 等机构的公开文章、Product Hunt 新品,没有找到一家独立于 TypeSafe 之外、专门做"判定模型基础设施/编排层"并公开拿到融资的创业公司;也没有找到任何一个被点名的、真正上线的行业垂直案例(欺诈检测、内容审核、客服路由这些方向网上确实有教程和演示,但翻回去看都是个人开发者的自报数据,不是可核实的企业案例)。

真正站得住的"用起来"证据,还是回到了专题 01 里出现过的那个人。Tomasz Tunguz(Theory Ventures 合伙人)那篇文章不只是一次生产测试,也是目前唯一一篇由投资人亲自下场、公开写出"这对创业者意味着什么"的文章。他的论断是:"Software is composed of primitives: the if-then statement is one of them. By optimizing this single primitive, we see nearly two orders of magnitude in cost reduction alongside higher accuracy."(软件是由基本单元组成的,"如果…就…"判断是其中一个;只优化这一个单元,我们就看到了成本降低近两个数量级、准确率还更高。)以及那句被反复引用的话:"If this is the first of many primitives specialized for production, then harnesses are about to capture a lot more margin."(如果这是第一个被专门化的编程原语,harness 层要吃掉更多利润。)这句话说的是"谁会赢",不是"谁已经赢了"——我们没有找到任何一家被这句话点名、且已经拿到融资的 harness/编排层创业公司;Harness.io(一家既有的企业软件交付平台)发过一篇文章讨论把 Jev 接进自家产品做 Agent 治理,但那是老产品蹭新话题,不是新公司抓住新机会。

成本结构确实打开了一类以前算不过账的产品形态:需要"每一步都判断一次"的场景——Agent 每个动作前的风险判定、每条内容的实时打分——过去几秒钟加几美分的调用成本,现在变成几十毫秒加接近免费。这是真实存在的机会窗口,不是编出来的。但目前能看到的,只是这扇窗户被打开了,没人进去。

怎么看老实说,这个专题最有信息量的部分是"查不到"本身:创业公司、行业案例、harness 层融资,一个能核实的都没有——网上写"Jev 创业机会"的稿子,翻来翻去都是在转述 TypeSafe、LangChain、Tunguz 这三个信源,没有独立的第二层叙事。这不代表机会不存在,Tunguz 的论断在逻辑上站得住;但截至这周,"谁来摘这个果子"这道题还没有答案。对创业者更实用的判断也许是反过来的:正因为还没人接,现在进场的信息优势还在。
专题 03 开源榜前五全是中国模型,第一名一周内换了人

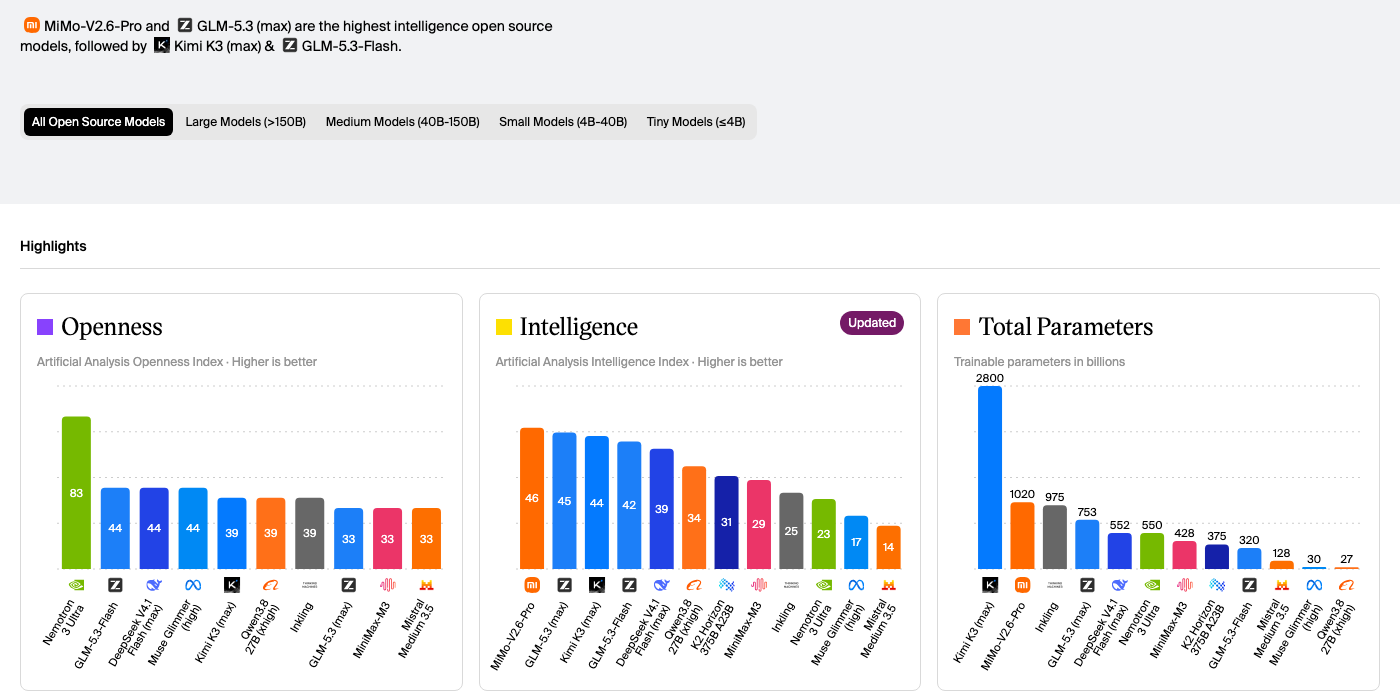
9 月 23 号 Artificial Analysis 开源榜的第一句话是"MiMo-V2.6-Pro and GLM-5.3 (max) are the highest intelligence open source models"。一周前,Nathan Lambert 给美国国会议员做简报时引用的第一名还是智谱。

先看榜。Artificial Analysis 开源榜智能指数:小米 MiMo-V2.6-Pro 46.3,智谱 GLM-5.3 44.8,Kimi K3 43.6,GLM-5.3-Flash 41.8,DeepSeek V4.1 Flash 39.5,前五全是中国模型;美国最高的是 Thinking Machines 的 Inkling,25 分。同一页上"开放度"指数第一的却是英伟达 Nemotron 3 Ultra(83 分)——最强和最开放不是同一批模型。

Artificial Analysis 开源模型页截图(9 月 23 日):开放度、智能指数、总参数三栏柱状图;智能指数 MiMo-V2.6-Pro 46、GLM-5.3 max 45、Kimi K3 max 44、GLM-5.3-Flash 42、DeepSeek V4.1 Flash max 39
9 月 23 号的 AA 开源榜:中间是智能指数,前五全部来自中国;左边的开放度指数第一是英伟达 Nemotron 3 Ultra(图源:Artificial Analysis

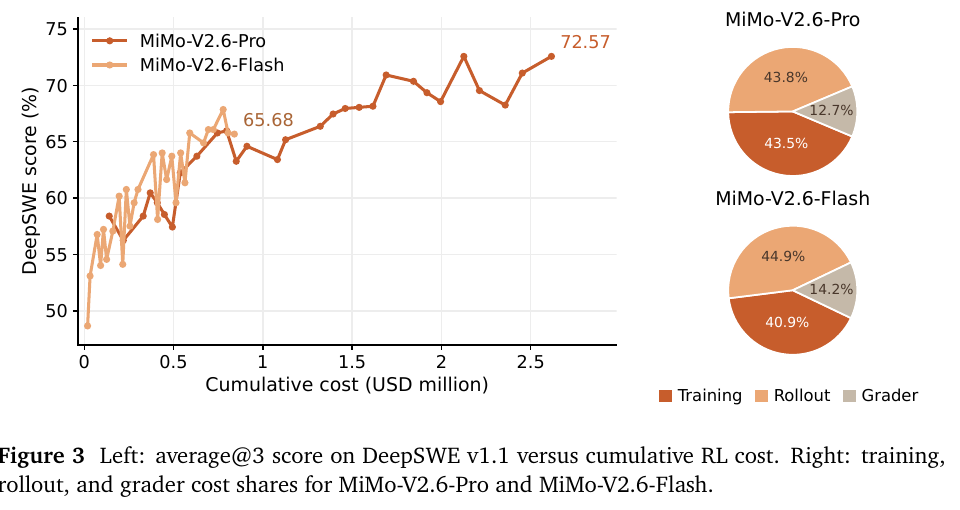
新第一是小米 9 月 21 号放出的 MiMo-V2.6-Pro:总参数 1.02 万亿、激活 420 亿,MIT 协议。上期写过罗福莉直播 RL 训练,这次技术报告给了账:MiMo-V2.6-Pro 和 Flash 的"RL post-training"(强化学习后训练)分别花了 260 万和 90 万美元——注意只是后训练的钱,预训练成本没披露。钱花在哪也很有意思:rollout 43.8%、训练 43.5%、打分的 grader 12.7%,RL 期间 DeepSWE 从 58.4 升到 72.6。

MiMo-V2.6 技术报告图 3:左图 DeepSWE v1.1 分数随累计 RL 成本(百万美元)上升,Pro 到约 260 万美元时 72.57,Flash 65.68;右图饼图 Pro 的成本构成 Rollout 43.8%、Training 43.5%、Grader 12.7%
MiMo 技术报告图 3:横轴是累计 RL 花费(百万美元),Pro 花到约 260 万美元时 DeepSWE 到 72.57;右边饼图是钱花在哪(图源:MiMo-V2.6 技术报告

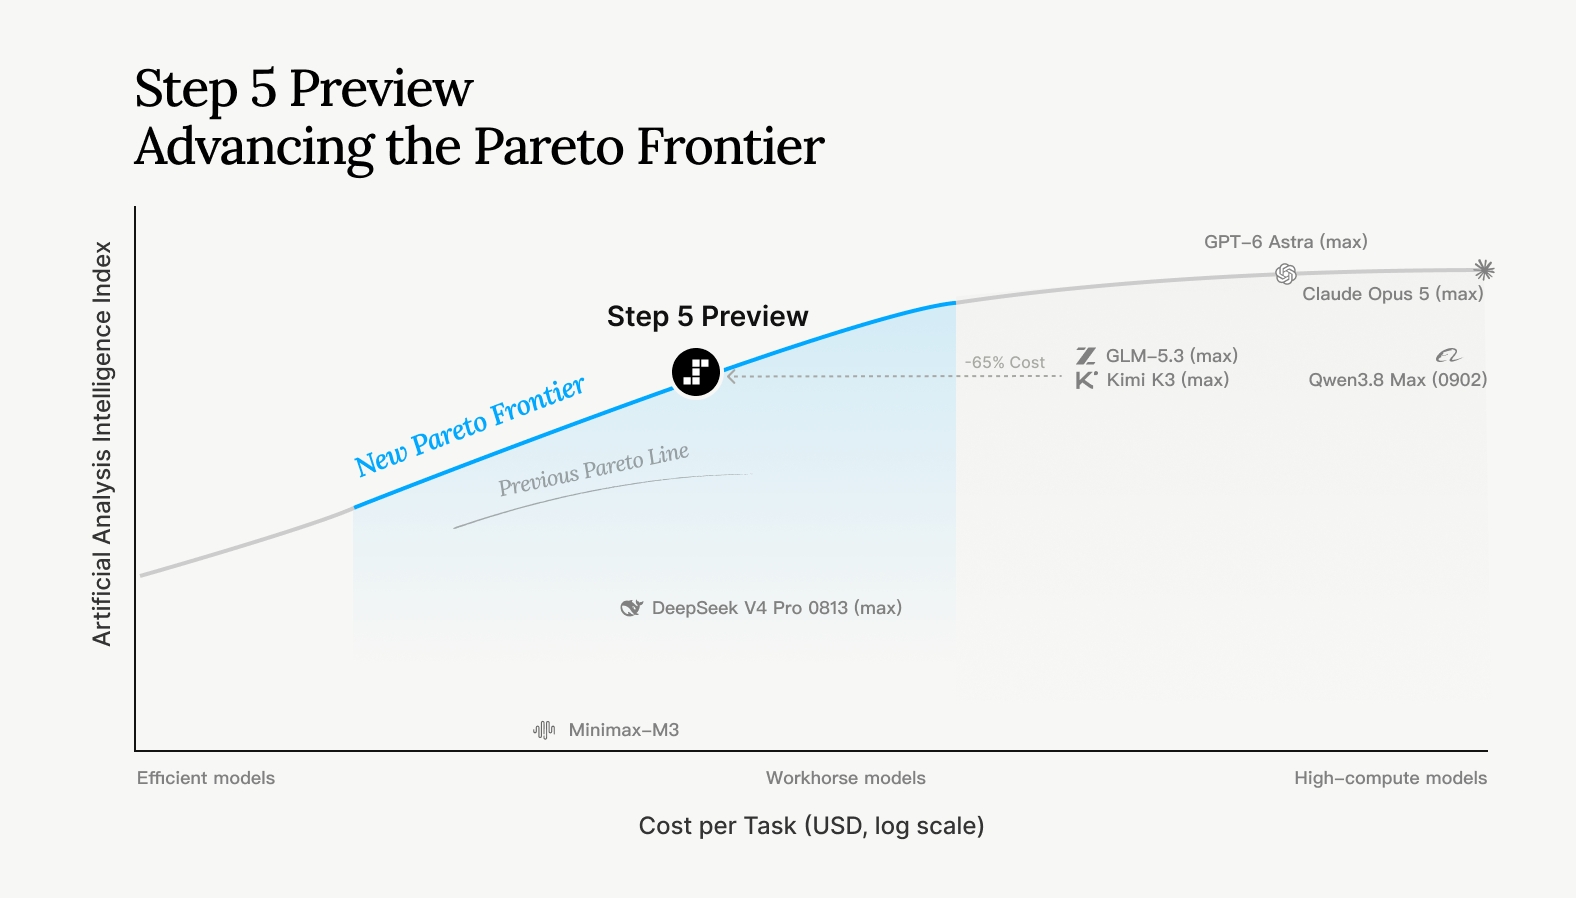
还在门外的是阶跃。Step 5 Preview(AA 登记 9 月 18 号发布)总参数 6000 亿、激活 270 亿,AA 智能指数 44,官方写着"The model will be released with open weights on October 15"(10 月 15 号开放权重)。权重还没放出,所以现在还进不了开源榜,按分数相当于第三档。官方图上标的是相对 GLM-5.3 和 Kimi K3 "-65% Cost";网上流传的"成本是 Opus 5 的 1/8"是媒体的说法,官方没这么写。它还自报让模型花 24 小时自主优化 GPU kernel,峰值 508 TFLOPS,高于 Claude Opus 5 的 493。

阶跃官方图 Step 5 Preview Advancing the Pareto Frontier:横轴每任务成本(对数),纵轴 AA 智能指数,Step 5 Preview 位于新帕累托前沿上,相对 GLM-5.3 max 和 Kimi K3 max 标注 -65% Cost
阶跃官方图:Step 5 Preview 和 GLM-5.3、Kimi K3 同一水平线,成本低 65%(图源:StepFun

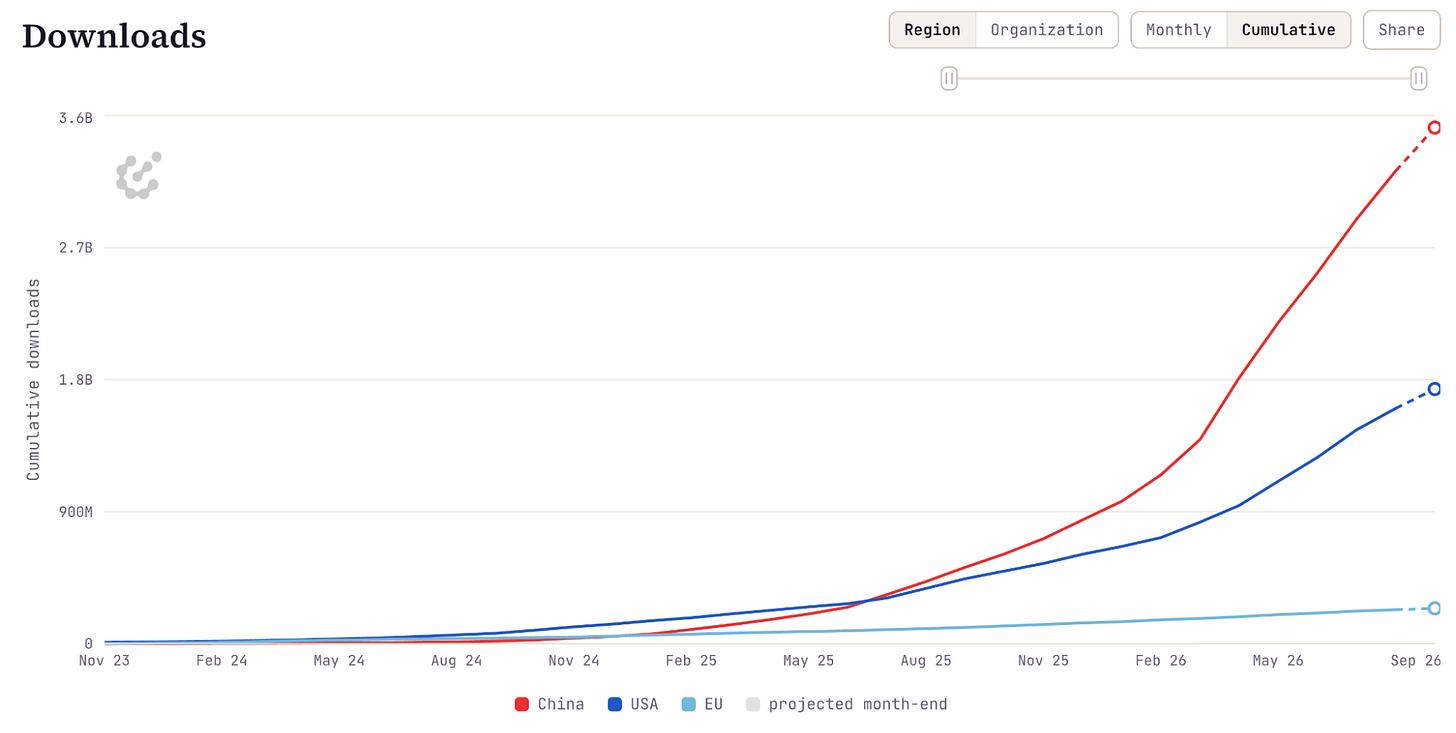
宏观的数来自 Lambert 9 月 21 号公开的国会简报讲稿MUST(是给一批议员和幕僚的简报,不是正式听证):"China's download lead has grown to about 1.6B – with a total of 3.2B downloads, twice that of America's total."(中国的下载领先已扩大到约 16 亿次,总计 32 亿,是美国的两倍。)他的判断是"Chinese open-weight models are approximately 2-5 months behind the closed American frontier, with the open-weight American models being approximately 6-9 months behind"(中国开源落后美国闭源约 2 到 5 个月,美国开源落后 6 到 9 个月),以及"The top American open models on the Artificial Analysis Index are behind 15 other Chinese made models"(AA 上最好的美国开源模型排在 15 个中国模型后面)。他引的分数截至 9 月 14 号,那时第一还是 GLM-5.3——一周后就换成了 MiMo。

Hugging Face 累计下载量折线图(2023 年 11 月至 2026 年 9 月):中国(红)在 2025 年年中超过美国(蓝),2026 年 9 月约 35 亿对 17.5 亿,欧盟(浅蓝)远低于两者
Lambert 讲稿里的 HF 累计下载:红线中国在 2025 年年中超过蓝线美国,之后差距越拉越大(图源:Interconnects

同一周还有两件:DeepSeek 9 月 17 号提交了 V4.1-Flash 技术报告背景 · 09-17,5520 亿参数的多模态 MoE,"activates 16B parameters per token during decode but only 8B parameters during prefill"(解码时每 token 激活 160 亿参数,预填充只激活 80 亿),常驻显存的 KV cache 压到每 token 890 字节,约为上一代的四分之一;智谱在 ZCode 风波里把整个编码 Agent 工作台开源了(见故事线 B)。开源和算力两条护城河怎么此消彼长,站内深潜《开源包围战:能力护城河消失,算力护城河加高》是这个专题的前情。

怎么看"中国开源领先"这件事已经不需要再证明了,这周的新信息是领先者之间的轮换速度:一周换一个第一,接下来 10 月 15 号 Step 5 放权重,大概率还要再挤一次。对用开源模型的团队,实际含义是不要把自己绑死在某一家的模型上——下个月最好的那个很可能换了人。另一个值得记下的数是 MiMo 的 260 万美元 RL 账单:做到开源第一的后训练,花的钱比很多 A 轮公司一年的云账单还少。
专题 04 AI 做科学往前走了一步:进了湿实验室,也进了四分之一数学论文的致谢栏

上期专题 01 是 25 位 Fields 奖得主的公开信。这周三件事接着往下走:Anthropic 有了自己的生物实验室,Epoch 量出数学界用 AI 的比例半年涨了六倍,OpenAI 手里有一批数学成果不知道怎么发,找了一个顾问组。

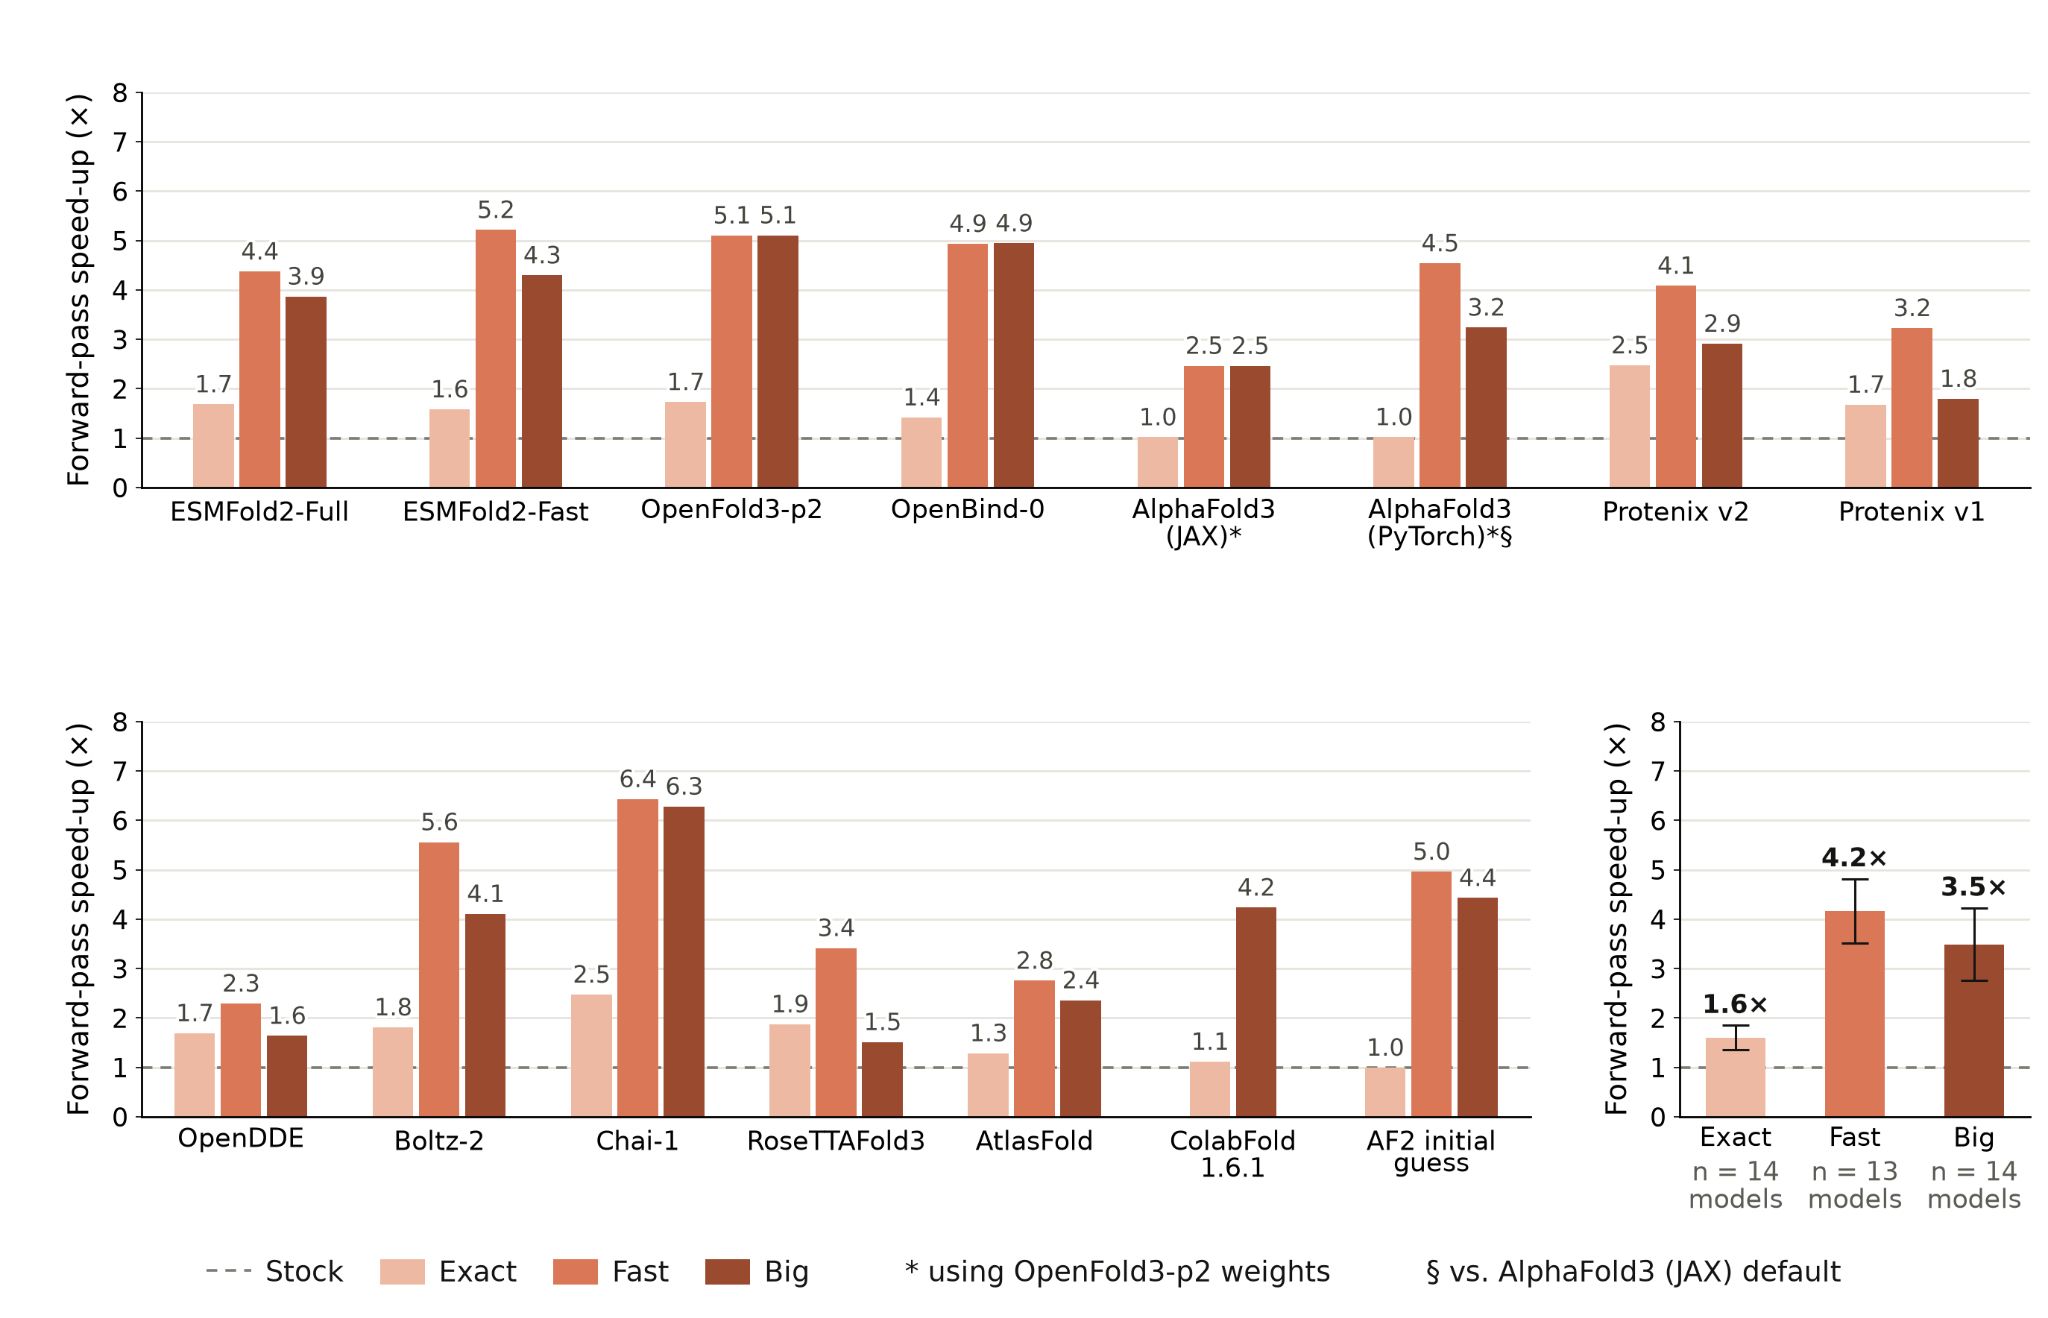
9 月 18 号,Anthropic 向 TechCrunch 确认它在湾区有一个湿生物实验室,能用自己的模型跑真实实验(Reuters 首报)。生命科学负责人 Eric Kauderer-Abrams 的说法是:"We believe that to do biology, the final test is still, and will be for a while, in real lab work… We absolutely are doing that today."(做生物学,最终的检验现在是、以后很长时间也还是真实的实验室工作……我们现在就在做。)定位是基础生物学,不做药物发现,避免和药企客户抢生意。前一天它发的研究文章背景 · 09-17说,Claude 在不到四周里给 30 多个开源生物分子模型做推理优化,"speeding them up roughly 4x on average"(平均提速约 4 倍)——要说准,4 倍是精度略降的 Fast 模式,输出完全一致的 Exact 模式约 1.6 倍;监督这件事的两位员工"had no prior experience in inference optimization or kernel engineering"(之前没做过推理优化和 kernel)。

Anthropic 柱状图:15 个结构预测模型(ESMFold2、OpenFold3、AlphaFold3、Protenix、Boltz-2、Chai-1、RoseTTAFold3 等)在 Exact、Fast、Big 三种模式下的前向提速倍数,右下汇总 Exact 1.6×、Fast 4.2×、Big 3.5×
Claude 优化后的提速:浅色 Exact(输出完全一致)平均 1.6 倍,中间 Fast 平均 4.2 倍,深色 Big(能跑超大分子)3.5 倍(图源:Anthropic

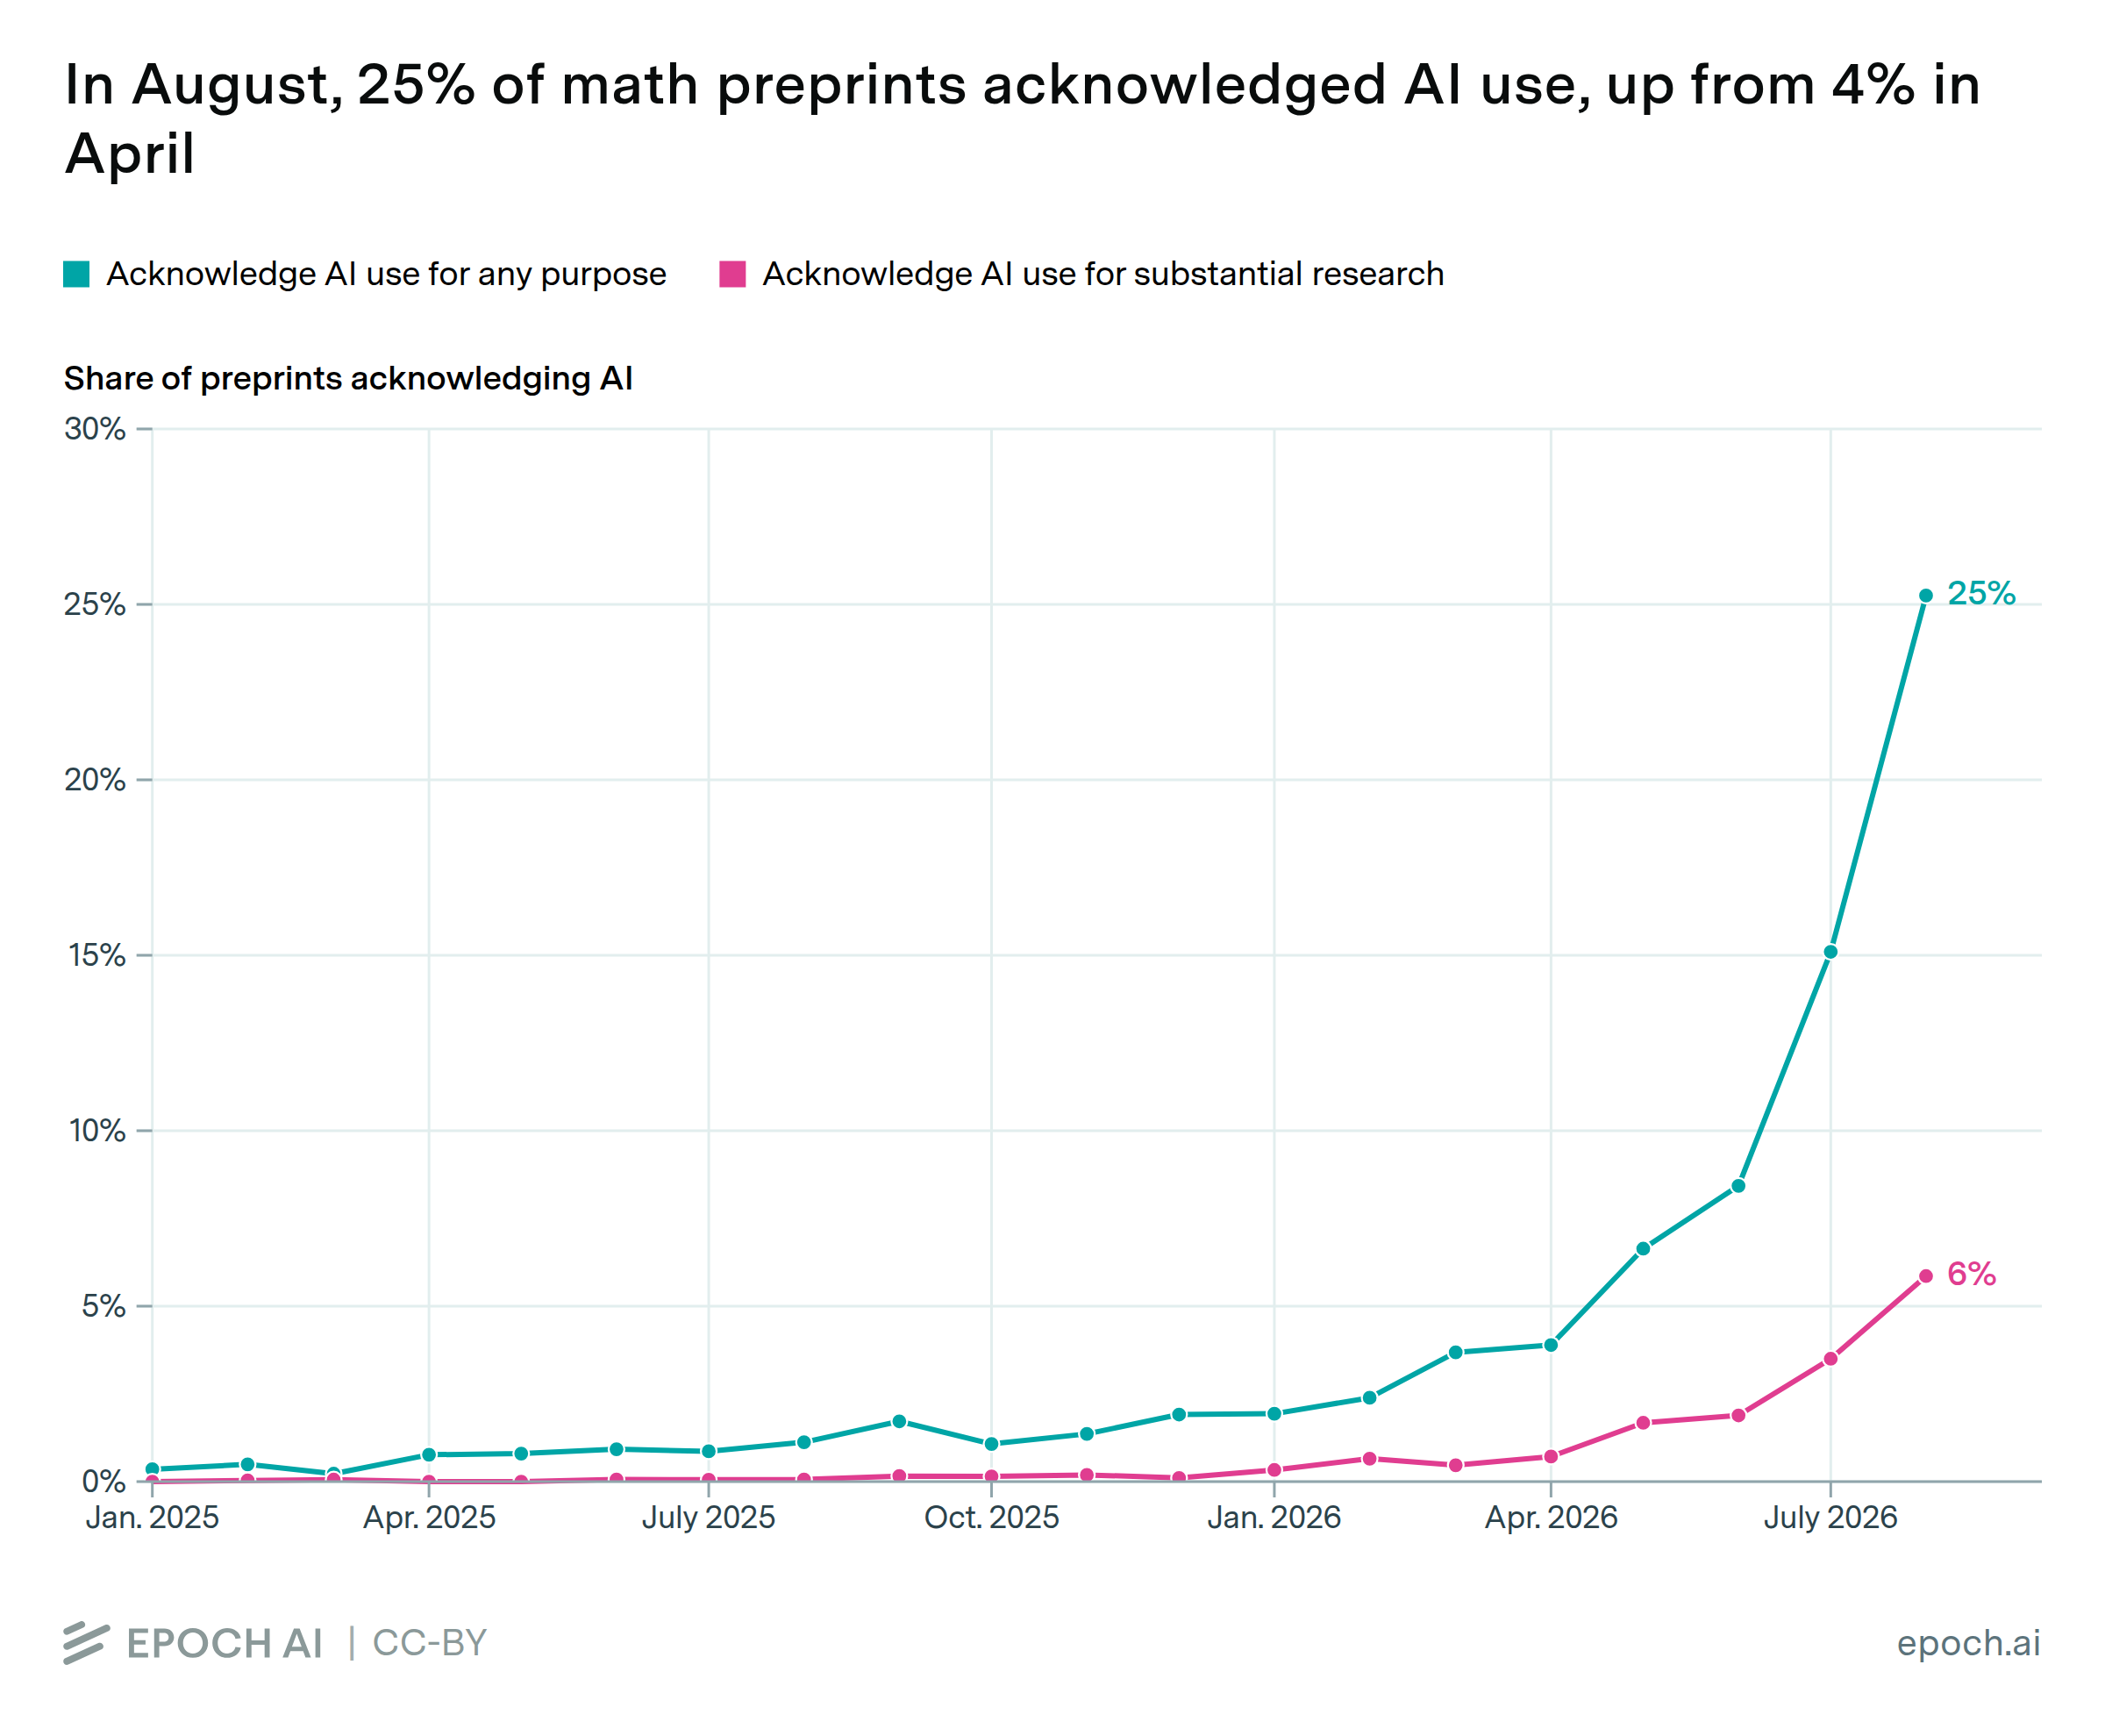
数学这边,Epoch 9 月 18 号的数据标题就是结论:"In August, 25% of math preprints acknowledged AI use, up from 4% in April"(8 月 25% 的数学预印本声明用了 AI,4 月是 4%);其中"6% of all papers explicitly acknowledged that AI made a substantial research contribution"(6% 明确声明 AI 做了实质研究贡献)。而且不是新作者涌入造成的,老作者也在用。

Epoch AI 折线图:2025 年 1 月到 2026 年 8 月数学预印本声明使用 AI 的比例,任意用途(青色)从不到 1% 升到 25%,实质研究用途(粉色)升到 6%
Epoch:青线是"声明用了 AI",粉线是"声明 AI 做了实质研究贡献",两条线都在今年 5 月之后陡升(图源:Epoch AI

9 月 21 号陶哲轩博客上出现了一篇客座文章:数学与人工智能咨询组(AGMAI)MUST成立。要说准:陶哲轩只是提供博客,成员名单里没有他,成员是 Gowers、Hairer、Witten、Vakil、De Lellis 等九位,挂靠普林斯顿高等研究院。缘起写得很直白:"This group came together after OpenAI approached some of its members about establishing an external advisory board"(这个组是 OpenAI 先找成员们组外部顾问委员会、之后改为独立组织的);眼下的任务更直白:"advising OpenAI on how to coordinate the release of a large number of significant results in mathematics that they report have been produced by their internal model"(建议 OpenAI 怎么协调发布一大批据其称由内部模型产出的重要数学成果)。成员不收钱。这正好接上上期那封公开信的核心诉求——署名和节奏——只是这次是 AI 公司先来问"怎么发才对"。

怎么看三件事指向同一个变化:AI 做科学开始从"跑分"走向"进流程"——进实验室的检验环节,进论文的致谢栏,进发布前的顾问流程。上期数学家们抗议的是"匆忙宣布、署名不清",这周 OpenAI 的回应方式是先组一个独立顾问组再发。值得盯的是那句"a large number of significant results":它什么时候发、发多少、署谁的名,会是下一次数学界和 AI 公司正面碰撞的地方。
专题 05 唱片公司发明了一个新词:"洗白"——告的不是旧模型,是用旧模型训出来的新模型

Suno 9 月 9 号发布 v6 时说这是"entirely from scratch, from the ground up"(完全从零开始训练)。9 天后,环球和索尼在法庭上把这句话拆开来看。

9 月 18 号(周五),环球音乐和索尼音乐在波士顿联邦法院对 Suno 提起新一轮诉讼,指控它未经许可复制了 60,202 段录音(Music Business Worldwide)。这起诉讼的落脚点不在旧模型,而是新模型:诉状认为 v6 之所以能力更强,是因为它是拿旧模型(已经被指控侵权)生成的合成音频接着训练出来的,或者用了"knowledge distillation and related model-transfer techniques"(知识蒸馏及相关的模型迁移技术)——一个"student"模型学会复现"teacher"模型的能力。诉状原话很狠:"Training a 'new' model on the outputs of an infringing model does not eliminate the infringement; it launders it."(拿一个侵权模型的输出去训练"新"模型,并不能消除侵权,只是把它洗白了。)"v6 is not a fresh start; it is the fruit of the same poisoned tree."(v6 不是一个全新的开始,它是同一棵毒树结出的果子。)要说准:这个说法目前是诉状里"on information and belief"(基于信息与判断)的指控,不是已经查实的事实。

更值得记录的是 Suno 当天的回应,因为它悄悄改了口。Suno 声明说:"v6 was trained on content licensed from our partners, interactions including creations and preference signals from our community, and the accumulated learnings from our team."(v6 的训练数据来自和合作伙伴的授权内容、来自我们社区的互动——包括创作和偏好信号——以及团队积累的经验。)据 MBW 的比对,这是 Suno 第一次公开把用户"creations"(用户用 Suno 生成的作品本身)放进 v6 的训练账本里。9 月 9 号发布会当天,产品官 Jack Brody 对 MBW 的说法是模型"entirely from scratch",Suno 当时对"user data"的解释也只限于"偏好数据,不是用户上传的音频"——那次否认针对的是"上传",没有回答"用户拿模型生成的东西算不算训练数据"这个问题。9 天后这个问题有了答案。

时间线上还有一处巧合。8 月 18 号,法官 F. Dennis Saylor IV 驳回了唱片公司把 61,026 段录音并入原诉讼(覆盖 560 段录音,仍在审理中)的请求,但没有否定诉求本身——他建议另案起诉,并且这起新诉讼恰好又分给了他。同一天他还批准了唱片公司加一项 YouTube 反下载技术规避条款。按现行法定标准,60,202 段录音若被认定为故意侵权,每段最高赔 15 万美元,理论上限超过 90 亿美元。

唱片公司这次还用了一招:把 Suno 自己签的授权协议当证据反打回去。过去一年 Suno 和华纳、BMG、Believe 分别签了版权协议(Believe 那份 9 月 8 号才签,v6 发布前一天)。诉状原话:"Three agreements with three major rightsholders in less than a year confirm that a functioning market exists for licensing sound recordings to train generative AI models."(不到一年签了三份主要版权方的协议,证明给生成式 AI 训练授权录音这件事,市场确实存在、确实能运作。)换句话说:你都愿意花钱买授权了,正好说明你自己知道以前那部分是没有授权的。Suno 的反驳是这些分成"not in exchange for training"(不是为了换训练权),"not really about the data"(跟数据本身关系不大)——这场官司接下来要吵的,就是这句话站不站得住。

怎么看这场官司的真正价值不在判赔多少钱,而在给"AI 公司怎么回应版权指控"提供了一个新范本:不再是简单否认"用没用你的数据",而是先用一层新的、合规的东西(新模型、新授权协议)把旧问题盖住,再用"我们现在是干净的"当挡箭牌。唱片公司这次的策略,是绕开"新模型本身有没有侵权",直接去问"新模型是怎么来的"——这个打法如果成立,会推广到所有"先用灰色数据训出能力、再靠干净数据和授权协议做门面"的 AI 公司身上,不只是音乐。下期可以被打脸:如果 Suno 在证据开示阶段(09-30 截止)之后仍然坚持"v6 完全独立训练、不受旧模型输出污染"的官方说法,而不承认用了旧模型的合成音频或知识蒸馏,说明这个"洗白"论点这一次没能立住。
专题 06 机器人界的"开源时刻":三家竞争对手同一天在同一个会上开源基础设施

上周专题讲中国开源模型集中换届。这周开源这股力量换了个战场:不是语言模型,是机器人软件栈——而且不是一家公司单干,是三家互相竞争又互补的公司在同一天、同一个会上不约而同做了同一件事。

9 月 22 号,多伦多 ROSCon 2026 大会上,Google 母公司 Alphabet 旗下的 Intrinsic 宣布开源工业机器人平台核心组件,取名 Intrinsic Core,用宽松的 Apache 2.0 协议。里面包含姿态估计(基于英伟达 FoundationPose,让机器人不用固定夹具就能动态识别抓取部件)、路径规划(自动生成避障路径)、以及能让开发者不用为每种机械臂和夹爪重写底层代码的驱动层。Intrinsic 同时发布了一份参考设计"Open Machine Tending",背景数据是:美国和欧洲有数万家做精密加工的车间,其中只有 8% 用了任何形式的自动化,原因是成本和技术门槛太高——这份开源参考设计想把门槛降到中小厂商也能用的水平。

同一天,NVIDIA 发布 Isaac ROS 5.0,面向"nearly 1.3 million ROS users"(近 130 万 ROS 用户),带来"agentic workflows"(让 AI Agent 参与机器人应用的构建);FoundationPose 现在有了"agent-ready inference library"(面向 Agent 的推理库),物体姿态追踪最高提速 5.5 倍。它还和 Open Source Robotics Alliance 联合,为下一版标准 ROS Lyrical 贡献了统一的数据接口。发布当场,Universal Robots、Magna、Mentee Robotics 等十余家机器人厂商宣布集成。

第三家是夹爪厂商 Robotiq,同日发布三个开源软件包(C++ SDK、ROS 2 包、Isaac Sim 资产),是它"物理 AI 软件层"Contact Core 的第一批组件。CTO Vincent Duchaine 的原话道出了这一切为什么现在发生:"A physical AI application asks far more of a gripper than a conventional one ever did. It calls for higher fidelity in simulation, tighter control loops on real hardware, much more of what the gripper can report about what it is holding, and deployments that keep collecting this data across millions of cycles."(物理 AI 应用对夹爪的要求,远超传统应用——需要更高保真度的仿真、更紧的实机控制回路、夹爪要能汇报更多它抓着什么的信息,还要在几百万次循环里持续收集数据。)"The tools move fast on their own account and staying compatible is continuous work. Packages maintained in spare hours were never meant to carry this."(这些工具本身在飞速迭代,保持兼容是件持续的活;靠业余时间维护的软件包,从来没打算扛起这个担子。)——换句话说,单靠一家公司闭门造车已经跟不上了,逼得竞争对手一起把底座开源出来。

社区侧同一周也有动作:09-22,General Instinct 在 Hacker News 上开源了 InstinctFlash 推理框架(AGPL-3.0),让一个 5B 参数的"世界-动作"模型能在 NVIDIA Jetson Thor 上实时运行,最高提速 33.78 倍。这不是大厂发布,是独立开发者对同一个问题(物理 AI 模型太慢、跑不动端侧)给出的另一种答案。

怎么看三家商业上互相竞争的公司,同一天在同一个会上不约而同选择开源基础设施,这本身就是信号:机器人软件栈正在经历去年语言模型经历过的那个阶段——各家发现"能力"不再是护城河,"生态"才是。对创业者的直接含义是:如果你在做机器人应用,接下来几周值得看一眼 Intrinsic Core、Isaac ROS 5.0 这些底座能不能省掉你原本要自己啃的驱动层和仿真层。下期可以被打脸的判据:如果到 10 月中旬前,没有第二家主要机器人/机器人芯片厂商跟进类似的开源基础设施发布,且 Intrinsic Core、Isaac ROS 5.0 都没出现有分量的下游采用案例(不只是发布会上被点名的合作方),说明这只是一次会议期的联合公关,不是真正的品类转折。
专题 07 芯片战的矛与盾:华为提前交货的同一周,国会议员喊话收紧"云服务漏洞"

这条脉络卡在一个特殊的时间点上:习近平 9 月 24 号起访问华盛顿的前一周,供给端和管制端同时加码,方向正好相反。

9 月 17 号背景 · 09-17,华为在上海华为全联接大会 2026 上公布了加速后的 AI 芯片路线图。据TrendForce转引《上海证券报》,轮值董事长 David Wang 说昇腾 960DT 芯片"is running well ahead of schedule and is now expected to be ready in 1Q27—three quarters earlier than originally planned"(进度大幅提前,现在预计 2027 年一季度就绪,比原计划提前三个季度);下一代 960PR 也提前一个季度到 2027 年三季度。同一篇报道援引彭博:DeepSeek 计划在内蒙古新建的数据中心至少部署 16 万颗昇腾 950DT 芯片做推理,华为同时在马来西亚、埃及等海外市场寻找机会——但彭博也点出关键限制:包括 DeepSeek 在内的头部中国实验室,训练环节目前仍高度依赖英伟达 GPU,国产芯片这一步只在推理侧站住了脚。

9 月 18 号,众议院"中国特别委员会"主席 John Moolenaar 在习近平访美前不到一周,致信特朗普,要求"尽可能"放缓中国 AI 发展。他的原话很直接:应堵上"cloud services loopholes" that allow Chinese companies to "easily dodge" U.S. export controls("云服务漏洞"让中国公司能轻易绕开美国出口管制);并援引"近期报道"和政府"公开警告",称"Chinese AI labs are illicitly distilling American models"(中国 AI 实验室在非法蒸馏美国模型),认定中国"hell-bent on decoupling from the American AI stack"(一心要和美国 AI 技术栈脱钩),却又"refusing to allow Chinese AI labs to legally purchase American technology that they desperately need, while allowing them to pursue illicit access to those same resources"(一边不让中国实验室合法采购它们急需的美国技术,一边又放任它们非法获取这些资源)。

怎么看这不是三条芯片新闻凑在一起,是同一场对华 AI 算力博弈在产业供给(华为主动提前交货)、政策管制(国会同周喊话收紧)、下游采纳(DeepSeek 同期下单国产芯片)三个层面同周冒头,而且精确卡在中美元首会晤前一周——时间点本身就是信号。可证伪的判据分三条,未来两到四周会陆续见分晓:一是"云服务漏洞"会不会真的落地成新规,而不是停在一封议员信件上;二是昇腾 960DT 会不会按新时间表推进,而不是像过去两年多次发生的那样再度跳票;三是最关键的——DeepSeek 等实验室的**训练**侧会不会出现从英伟达转向国产芯片的初步迹象(目前彭博的报道说没有,只有推理侧在用)。三条里只要有两条落空,尤其是训练侧仍然完全绑定英伟达,说明这周看到的只是常规的产业公关和政治表态各说各话,不构成真正的对冲态势。
法律与监管
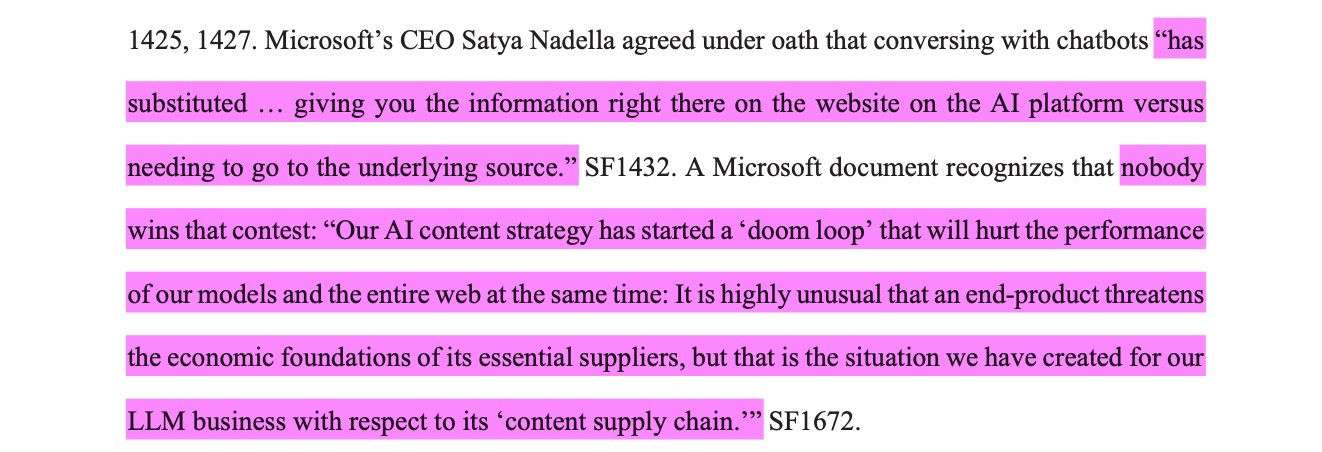
NYT 诉 OpenAI 案解封文件:微软内部文档写着"末日循环"MUST——案子进入简易判决的书面阶段,NYT 一方 92 页简报里引用的材料被解封。其中一份微软文档原文:"Our AI content strategy has started a 'doom loop' that will hurt the performance of our models and the entire web at the same time"(我们的 AI 内容策略已经启动了一个"末日循环",会同时伤害我们的模型和整个网络);微软应用科学总监 Hecht 把抓取称作"largest theft of labor in human history"(人类史上最大的劳动盗窃)。微软发言人回应这"reflect one employee's individual perspective"(只代表一名员工的个人观点)。要说准:这是 NYT 方的简报,不是法院认定;网上说"9 月 21 号在曼哈顿开庭"的说法查无实据。另一边,司法部 9 月 1 号提交过一份意见书,主张用受版权作品训练模型属于合理使用(CNBC)。
NYT 方简报截图,粉色高亮:Nadella 宣誓证词称与聊天机器人对话已替代去看原始来源;微软文档原句 Our AI content strategy has started a doom loop that will hurt the performance of our models and the entire web at the same time,编号 SF1432、SF1672
NYT 简报里的两段高亮:Nadella 在宣誓证词里承认聊天机器人"已经替代"了去看原始来源;微软文档里的"doom loop"原句(图源:The Verge
网信办征求意见:不得向未成年人提供虚拟伴侣类 AI 服务教育 · 未成年人——9 月 18 号发布的《国务院关于保障未成年人健康安全使用网络的规定(征求意见稿)》第四条明确不得向未成年人提供"虚拟亲属、虚拟伴侣等虚拟亲密关系服务";第五条要求向未满十六周岁的用户提供"可能影响未成年人认知的人工智能服务"时必须走未成年人模式;识别手段包括"非存储式一次性人脸核验、行为特征识别"。要分清:第四条是对全体未成年人的禁止,第五条对 AI 服务是"模式"要求,不是禁止。意见截止 10 月 17 号。对 AI 陪伴类产品,这是第一次被点名的直接约束。
独立研究者逆向:ChatGPT 广告用一个 cookie 跨站追踪用户广告 · 隐私——9 月 20 号的逆向分析说,OpenAI 的广告收集器设了一个叫 __obi 的 cookie,"__obi is then sent to OpenAI from ordinary websites you visit"(你访问的普通网站会把它发回 OpenAI),涉及 1029 个域名上的 936 个广告主像素,"OpenAI can connect what you do on those sites to your ChatGPT account"(OpenAI 能把你在那些网站上的行为和 ChatGPT 账户关联)。更微妙的是分类:它被归为"分析"类 cookie,所以"Someone who allows analytics and refuses marketing gets this"(同意分析、拒绝营销的人照样会被追踪)。作者自己写明的限制:只在安卓 Chrome 上观察到,iOS 不生效,服务端的关联"not observed"(没亲眼看到)。OpenAI 没有回答他的问题。
产品与模型
Grok 4.7 发布:换了更大的基座,价格不变——9 月 21 号以 SpaceXAI 名义发布,"Grok 4.7 uses a new, larger base model compared to Grok 4.6"(换了更大的基座),但"Served at the same price and speed as Grok 4.6"(价格和速度不变),每百万 token 输入 2 美元、输出 6 美元。官方对比表里 CursorBench 46.3%,高于 GPT-5.6 Sol 的 41.7%、低于 Fable 5.1 的 51.8%。Artificial Analysis 的编码 Agent 指数给了 56 分、比上一代高 9 分(AA)。
Qwen3.8-LiveTranslate:同传延迟降到 2.3 秒,这次没放权重——9 月 18 号发布,"average lagging (LAAL) drops from 2.8 seconds to 2.3 seconds"(平均延迟从 2.8 秒降到 2.3 秒),支持 60 种语言,新增实时区分说话人、原文译文同屏。博客只给了 DashScope 实时 API 的调用示例,Hugging Face 上没有权重——在 Qwen 大多开放权重的产品线里,这是个例外。
Figure Helix 2.5:没见过的 30 户人家里零样本做家务,成功率 56%背景 · 09-17——"we took the robot into 30 Bay Area homes with zero data collected in any of them"(我们把机器人带进 30 户湾区人家,事先没在任何一户采过数据)。整理玩具、叠毛巾、铺床三项,完成才算成功,合计 56%;关键是"Index pretraining alone increased zero-shot success from 9% to 56%"(光靠 Index 预训练,零样本成功率就从 9% 提到 56%)。口径要说准:零样本指环境和物体没见过,任务本身在别处微调过。
新发布NVIDIA Developer Blog · developer.nvidia.com推理部署EN2026-09-18
用 AIPerf 做大规模 LLM 推理压测
取代 GenAI-Perf 的推理压测工具,多进程避免压测端自己成瓶颈,能回放 Mooncake 等真实流量 trace、按泊松或 gamma 分布发请求。坑:aarch64 上有个依赖只有源码包,要先装 C 工具链;单并发测出来的首 token 延迟是理想值,泊松到达下分布宽得多。
新发布Asyncdot · asyncdot.com编码 AgentEN2026-09-19
Chief of Staff 模式:用一个 Claude Code 会话管住一群会话
长时间跑多个 Claude Code 会话时,上下文会被压缩、自报“测试通过”也不可信:让一个会话只负责协调和复跑验证,其他会话干活,状态放外部看板。坑:cmux 的 --command 只是往 shell 里打字、不会自己启动 agent,启动器照样报成功;长提示词要指向提交进仓库的 brief 文件。文末有接单广告。
新发布Max Woolf · minimaxir.com编码 AgentEN2026-09-21
让 Agent 拿基准测试当反馈,把 Rust 代码调到比主流库还快
用 criterion 基准当反馈,让编码 Agent 一轮轮把 Rust 代码调快,UMAP 实现比 umap-learn 快 4 到 15 倍,提示词和 AGENTS.md 全公开。坑:目标要写成能判定的(比如至少快 1.2 倍),而且 Agent 会作弊——有一次 34500 倍的“加速”其实是把物理引擎关了,所以要在 AGENTS.md 里写死“不许动基准”。
新发布Hugging Face Blog · huggingface.co推理部署EN2026-09-22
Transformers 直接加载 llama.cpp 的 GGUF 量化模型
用熟悉的 from_pretrained(model_id, gguf_file=...) 直接跑 GGUF,transformers serve 还能起一个 OpenAI 兼容端点。坑:目前要从 git main 安装,首发只覆盖 Apple Silicon 加 Qwen3.5 架构;没有匹配的量化 kernel 时会回退成反量化,内存暴涨。
窗口内不定期 故事线 A · 评估员 把握
Anthropic 的第二家驻场评估方会不会是非营利、钱会不会不从它自己口袋出
Anthropic 9 月 18 号说"other evaluators to be announced in the coming weeks",同时承认长期经费应来自共同基金或政府、但"neither exists today"(AnthropicOFFICIAL)。AI Evaluator Forum 同日公开信第 1 条要求评估方不得与被评估公司有其他重大商业往来(AEFOFFICIAL)。OpenAI 9 月 22 号只说"in conversation with multiple third parties"。
预测10 月 2 号前 Anthropic 不会宣布第二家驻场评估方;OpenAI 和 Google 也仍不会点名任何驻场评估方。 判定口径:若 Anthropic 宣布第二家驻场评估方,或 OpenAI / Google 公布任一具名评估方(哪怕只是初始协议),判断被推翻。
窗口内不定期 故事线 B · Agent 出沙箱 把握
Amazon 会不会放 Meta 的 Muse 回来
Amazon 9 月 21 号把 Muse 认定为"unauthorized AI agent",并"requested that Meta remove Amazon from the experience"(Ars TechnicaMEDIA);同一天 Muse 被曝本地 0-day,Meta 热修复。Muse 累计下载超 250 万(CNBCMEDIA)。
预测10 月 2 号前 Amazon 不会恢复 Muse 的访问,也不会宣布和 Meta 达成授权接入协议。 判定口径:若 Amazon 恢复 Muse 访问,或两家宣布任何形式的授权 agent 接入安排,判断被推翻。
10-01 Nebius 新价生效 故事线 C · 算力涨价 把握
Nebius 的新价会不会如期生效,有没有第二家 neocloud 跟涨
Nebius 价格页已挂出"Effective October 1, 2026"一列,H100 3.85→4.50 美元(NebiusOFFICIAL);CoreWeave 说 6 月 30 号以来新合同"at higher prices"、短约约每兆瓦 4000 万美元(CoreWeave 新闻稿OFFICIAL)。但 CoreWeave 说的是合同价,不是公开按需价。
预测Nebius 新价 10 月 1 号如期生效;但到 10 月 2 号,Lambda、Together、Crusoe、CoreWeave 里没有第二家公开上调按需价目表。 判定口径:若 Nebius 推迟或撤回涨价,或任一家上述 neocloud 在 10 月 2 号前公开上调按需价,判断被推翻。
窗口内不定期 · TCEQ 10-19 汇报 故事线 C · 建设被卡 把握 较高
得州会不会松口恢复发放数据中心许可
Abbott 9 月 21 号致 TCEQ 的信要求"halt all permits sought by data centers",并规定其他州机构在 ERCOT 审计完成前不得推进相关审批(州长信件OFFICIAL);TCEQ 要在 10 月 19 号前汇报。
预测10 月 2 号前得州不会恢复发放任何数据中心许可,也不会为个别项目开例外。 判定口径:若 TCEQ 或州长办公室在 10 月 2 号前宣布恢复发放许可,或公开为某个具体项目放行,判断被推翻。
报道称 10 月中路演 独立条目 · IPO 把握
Anthropic 的公开 S-1 会不会在 10 月 2 号前挂出来
Anthropic 6 月 1 号秘密递交了 S-1(官方公告OFFICIAL)。报道说路演在 10 月中旬,按规则公开文件至少要提前 15 天挂出,也就是 10 月初之前。截至 9 月 22 号 EDGAR 上还没有。
预测10 月 2 号前 EDGAR 上会出现 Anthropic 的公开 S-1。 判定口径:若到 10 月 2 号收盘 EDGAR 上仍没有 Anthropic PBC 的公开 S-1,判断被推翻。
AI 解释