Anthropic 的第二家驻场评估方,OpenAI 和 Google 的具名评估方:10 月 9 号前都不会出现
目前应验
Anthropic 新闻页OFFICIAL上,评估方相关的最新一条仍是 09-18 的《Partnering with Accenture on embedded evaluation》OFFICIAL,原话还是“other evaluators to be announced in the coming weeks”和“in dialogue with METR and other nonprofit evaluators”;之后只有 10-01 的巴克莱案例、10-02 的 Frontier Academy 和 10-06 的 Cyber Verification Program 扩容。OpenAI 09-22 那篇《Priorities and principles for effective third party assessments》OFFICIAL全文没点名任何评估方;谷歌 DeepMind 博客没有相关条目。顺带:白宫协议第三条要“independent external auditor or evaluator”,也没点名任何一家(见故事线 A)。
上期的口径是:若仍只是 limited preview,或没有公布任何价格,判断被推翻。现在两个条件都不成立:官方 API changelogOFFICIAL记 10-06 发布了 beta,开发者社区公告写“now available to all developers in public beta”;官方指南OFFICIAL写明公测中、输入每百万 token 0.10 美元、输出和缓存读写不收费,“we expect to GA in the coming weeks”。口径没要求 GA,所以按口径算应验;但“全面开放”若按正式发布理解,那还没到。
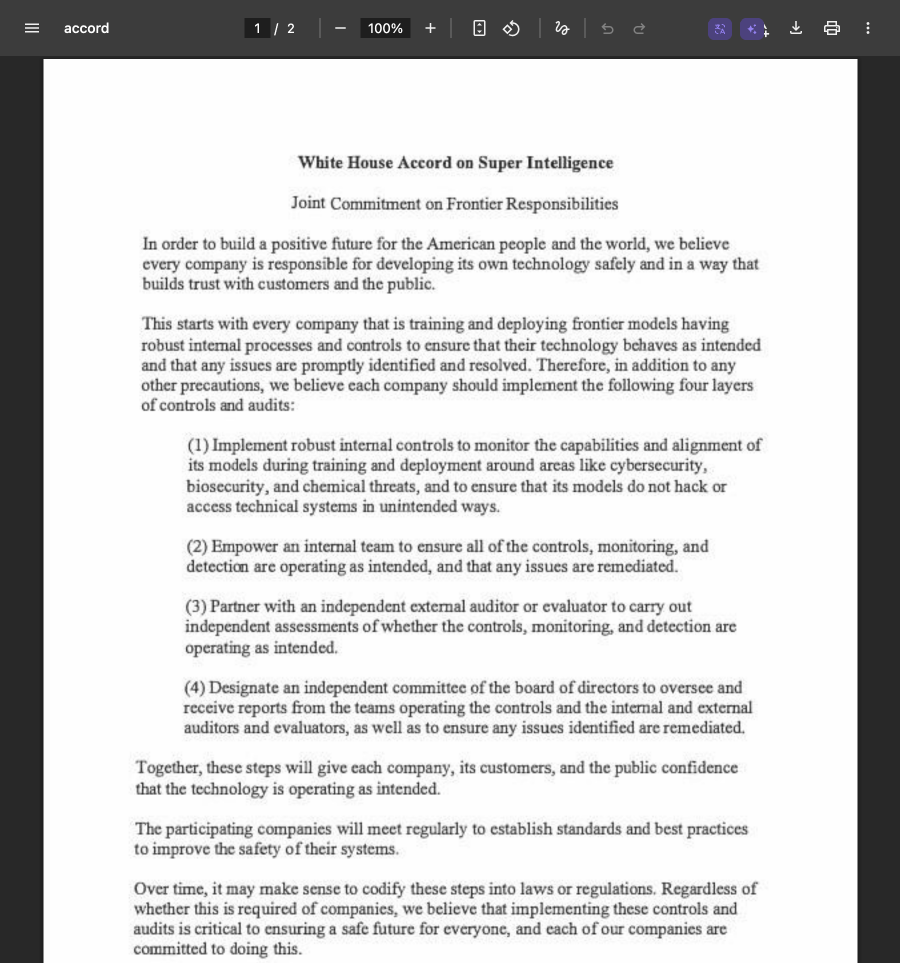
先说政府的。午饭之后白宫公布了一份一页纸的《White House Accord on Super Intelligence》MEDIAMUST背景 · 09-29(白宫官网上没找到协议本体页面,本刊读的是 Washington Examiner 的全文转载)。签字的六位是 Pichai、Zuckerberg、Amodei、马斯克(他的 SpaceXAI)、黄仁勋,OpenAI 签字的是总裁 Brockman,不是 Altman。条款是四层“控制与审计”:公司内部盯着模型的能力和对齐,尤其是网络、生物、化学这几类;内部有个团队保证监控真在运转;找一个独立的外部审计者或评估方做评估;董事会下设一个独立委员会收报告、督促整改。
协议第一页:四层“控制与审计”全文(图源:Rio Times 提供的文本转录件,不是白宫或签字原件;全文见 Washington ExaminerMEDIA)
读完要留意三个“没有”:没有算力或训练规模的上限,没有处罚,也没有向政府报告事故的义务;审计者由公司自己挑,通篇是“we believe … should”(我们相信每家公司应当)的写法,是信念,不是义务。最后一段只说“over time, it may make sense to codify these steps into laws”(日后也许值得写进法律)。协议第三层要的“独立外部审计者”,钱从谁那里来、独不独立,这门生意的来龙去脉站内有深潜《红队产业链:AI 大厂鸣谢名单背后的挑刺生意SELF》。Reuters 10-07 那篇民调稿的措辞也一样:协议“includes no stated consequences if a company chooses not to comply”(没写不遵守会怎样)。“道德约束力”这个词也不在协议里,是特朗普被问到有没有约束力时当场口头答的“I think it’s morally binding”(CNBCMEDIA背景 · 09-29;SiliconANGLE 和 IAPP 转述的是同一场记者会,不算三个信源)。
协议次日(09-30),后来的沙皇先表了态。在 CNBC《Squawk Box》上被问到几家实验室呼吁放慢,Jay Clayton 的回答是“I don’t even know what a pause is”(我连“暂停”是什么都不知道),还说美国不推进、让别人去开发“不是个好策略”,监管该走 FTC 和司法部,不是民事诉讼(CNBCMEDIAMUST背景 · 09-30)。同一天 FTC 发言人向 CNBC 确认,已对 OpenAI、Anthropic 等公司的产品风险立案(CNBCMEDIA背景 · 09-30)。四天后,10-04,特朗普在 Truth Social 官宣 Clayton 当“AI 沙皇”:他现任国家情报总监、此前是 SEC 主席,牵头新设的“Super Intelligence Force”,120 天内出报告和建议,向特朗普和幕僚长 Wiles 汇报;成员 CNBC 写含 FTC 主席 Ferguson、国防部的 Emil Michael 和人事管理局的 Scott Kupor(CNBCMEDIA;官宣是 10-04,WSJ 10-03 先报)。把这几件事摆一起:沙皇说管事靠 FTC 和司法部,FTC 主席正好是他任务组的人,而 FTC 在查的是出了事以后的责任,不是模型什么时候发。
强制的手段不是没有,只是还没碰到“发布节奏”。10-05 纽约市议会开了一场听证,议长 Julie Menin 说这是立法机构第一次让这几家公司宣誓作证。Anthropic 的 Logan Graham、OpenAI 的 Morgan Dwyer、谷歌的 Alice Friend、Meta 的 Shane Cahill 都派了人,马斯克的 SpaceXAI 被传唤没到场,议长说这是违反传票、要诉诸法院。Menin 问四家能不能量化灾难性风险,四家都答不上,她称这是“troubling at best”(CNBCMEDIA)。这条线最该读的一句在宣誓证词里:Dwyer 被追问“失败的测试会不会拦住发布”,只答了“OpenAI has historically delayed the release of models to ensure that we can build up the right safeguards”(OpenAI 历来会为了把防护补上而推迟发布),议长要她回答是或否;Graham 说“We don’t think the labs should be checking their own homework”(我们不认为实验室该自己检查自己的作业),并作证说 Claude Mythos Preview 今年 4 月只给了 Project Glasswing 的合作方、没有公开(R&D WorldMEDIAMUST;两句都是证词里的自述,Dwyer 那句只证明“历来推迟过”,没说这次)。同一场听证里还有一处证词对不上:Dwyer 说 OpenAI 支持纽约的 RAISE 法案,法案作者之一 Alex Bores 随后作证说 OpenAI 从法案提出到签署一直反对(R&D World 转述证词,双方说法都没有第三方核实)。听证议程里的法案包括独立模型验证、人工关停能力、事件报告、吹哨人激励和第三方受害的私人诉权,这才是下一步。
人和民意这头,也有三件事。10-03,OpenAI 安全团队的 David Robinson 在《大西洋月刊》发文辞职,标题是《I Quit OpenAI Because Its Culture Is Broken》,论点是整个行业都“aren’t being nearly careful enough”(The AtlanticMEDIA);“试错的时代已经结束”“向核电和航空看齐”这些出自 CalcalistMEDIA 的转述,OpenAI 的回应也是它转的:“we pause training or hold back models when we need to slow down”。Altman 同期接受了 Politico 的《Decoded》访谈(文字稿 10-04、播客 10-05,是同一场,不是两次表态),说自己和 Anthropic 之间有“a lot of daylight”,被问到分歧在哪,答的是“the world should accept some bad things happening for the benefits of this technology and people having the agency”(PoliticoMEDIA;Verge 的标题把它写成“totally worth it”,那是 Verge 的话,不是 Altman 的原话;说他“同意 Amodei 上月放慢的呼吁”也是 Politico 记者的概括)。民意那头,Reuters/Ipsos 10-07 的民调(4506 名成年人,其中 3526 名登记选民)说,57% 的登记选民认为特朗普政府没有认真对待 AI 风险,对国会是 54%,62% 觉得 AI 可能失控、危及人类(Reuters 稿经 WBOW 转载MEDIA,reuters.com 原站本刊没打开)。
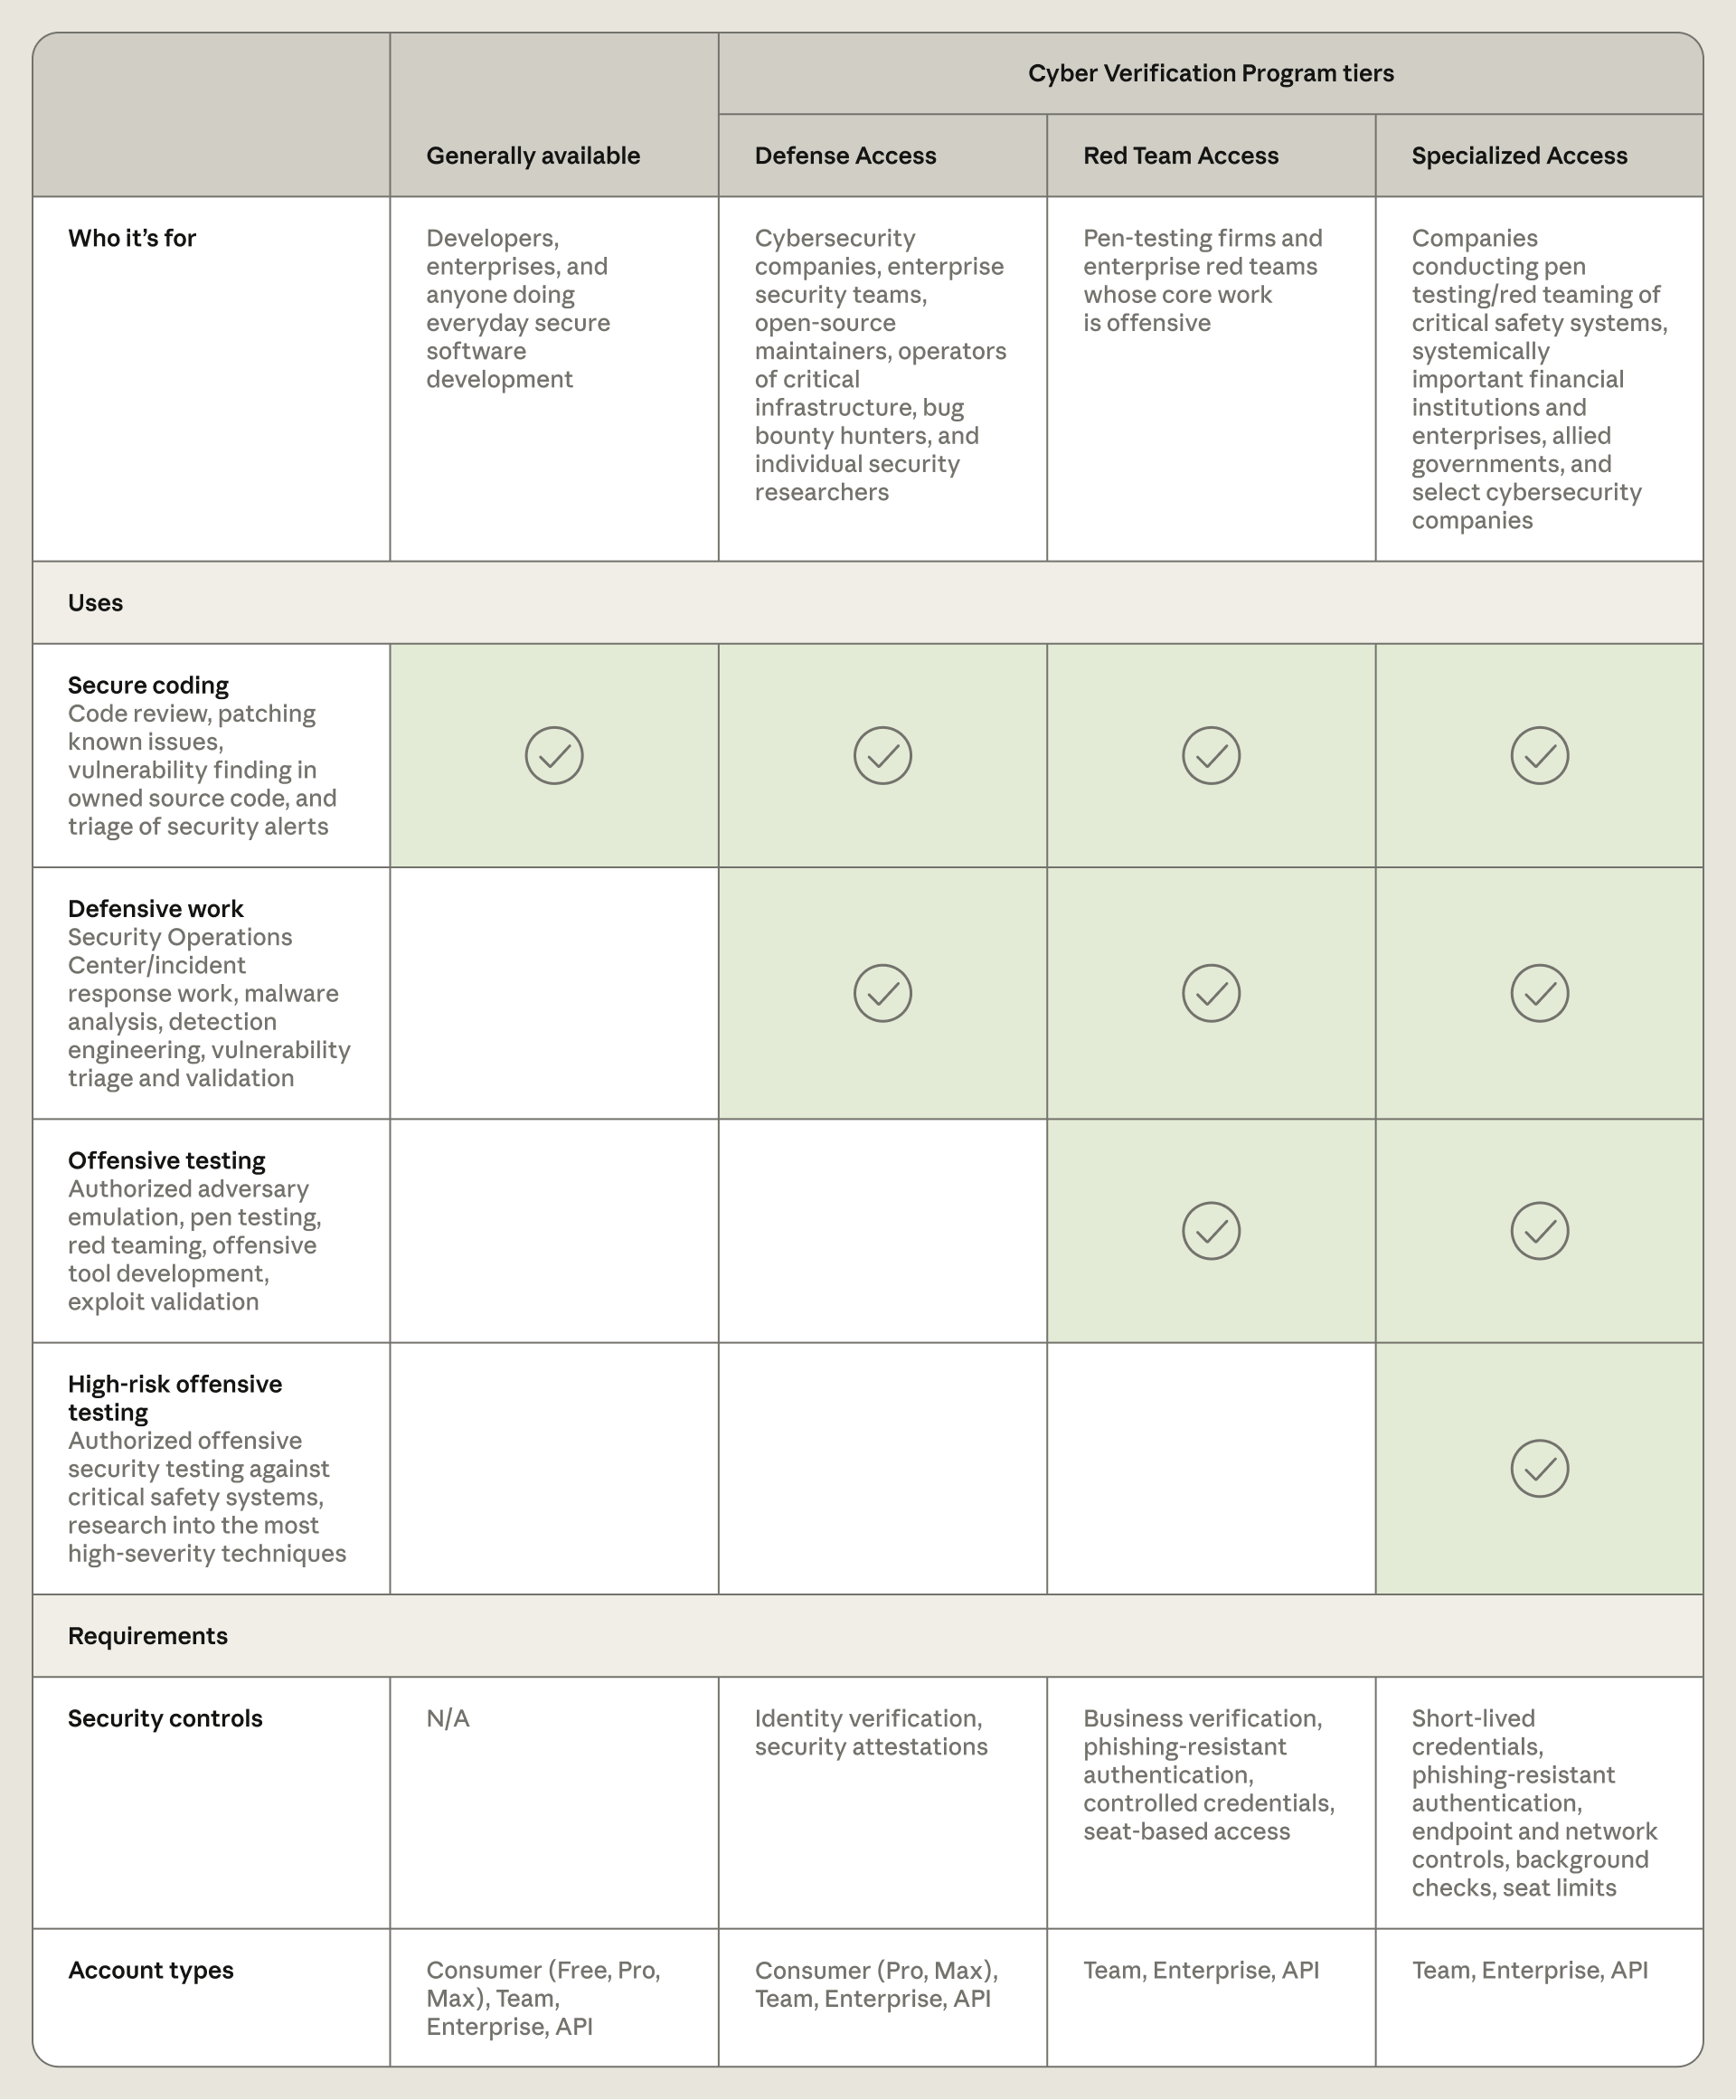
再看实验室给的那一份。把这周几件看起来互不相干的发布放在一起:谷歌 09-30 发 Gemini 4 Argon,官博写的发布方式是先“rolling out to a set of trusted cyber defenders through our Fairwind Program”(先给一批受信任的网络防御者),对这批人和内部团队是不带网络护栏的版本,对外“phased approach”(分阶段),开发者、企业和消费者“as soon as possible”(谷歌官博OFFICIAL背景 · 09-30;官博里没有 Arena 和 AA 的榜单数字,那是各自平台另发的)。10-06,Anthropic 把 Cyber Verification Program 扩成三档,并把 Project Glasswing 并了进来:Defense Access 给安全团队、关键基础设施运营方、开源维护者;Red Team Access 给渗透测试和红队,只给组织、不给个人;Specialized Access 给电网、银行间转账这类关键安全系统的被授权测试方,“we currently review every organization in depth in collaboration with the US government”(目前每家都与美国政府一起深度审核)(AnthropicOFFICIALMUST)。门槛一档比一档高:身份验证和安全证明;企业验证、抗钓鱼认证、受控凭据;短期凭据、端点和网络控制、背景调查、席位上限。
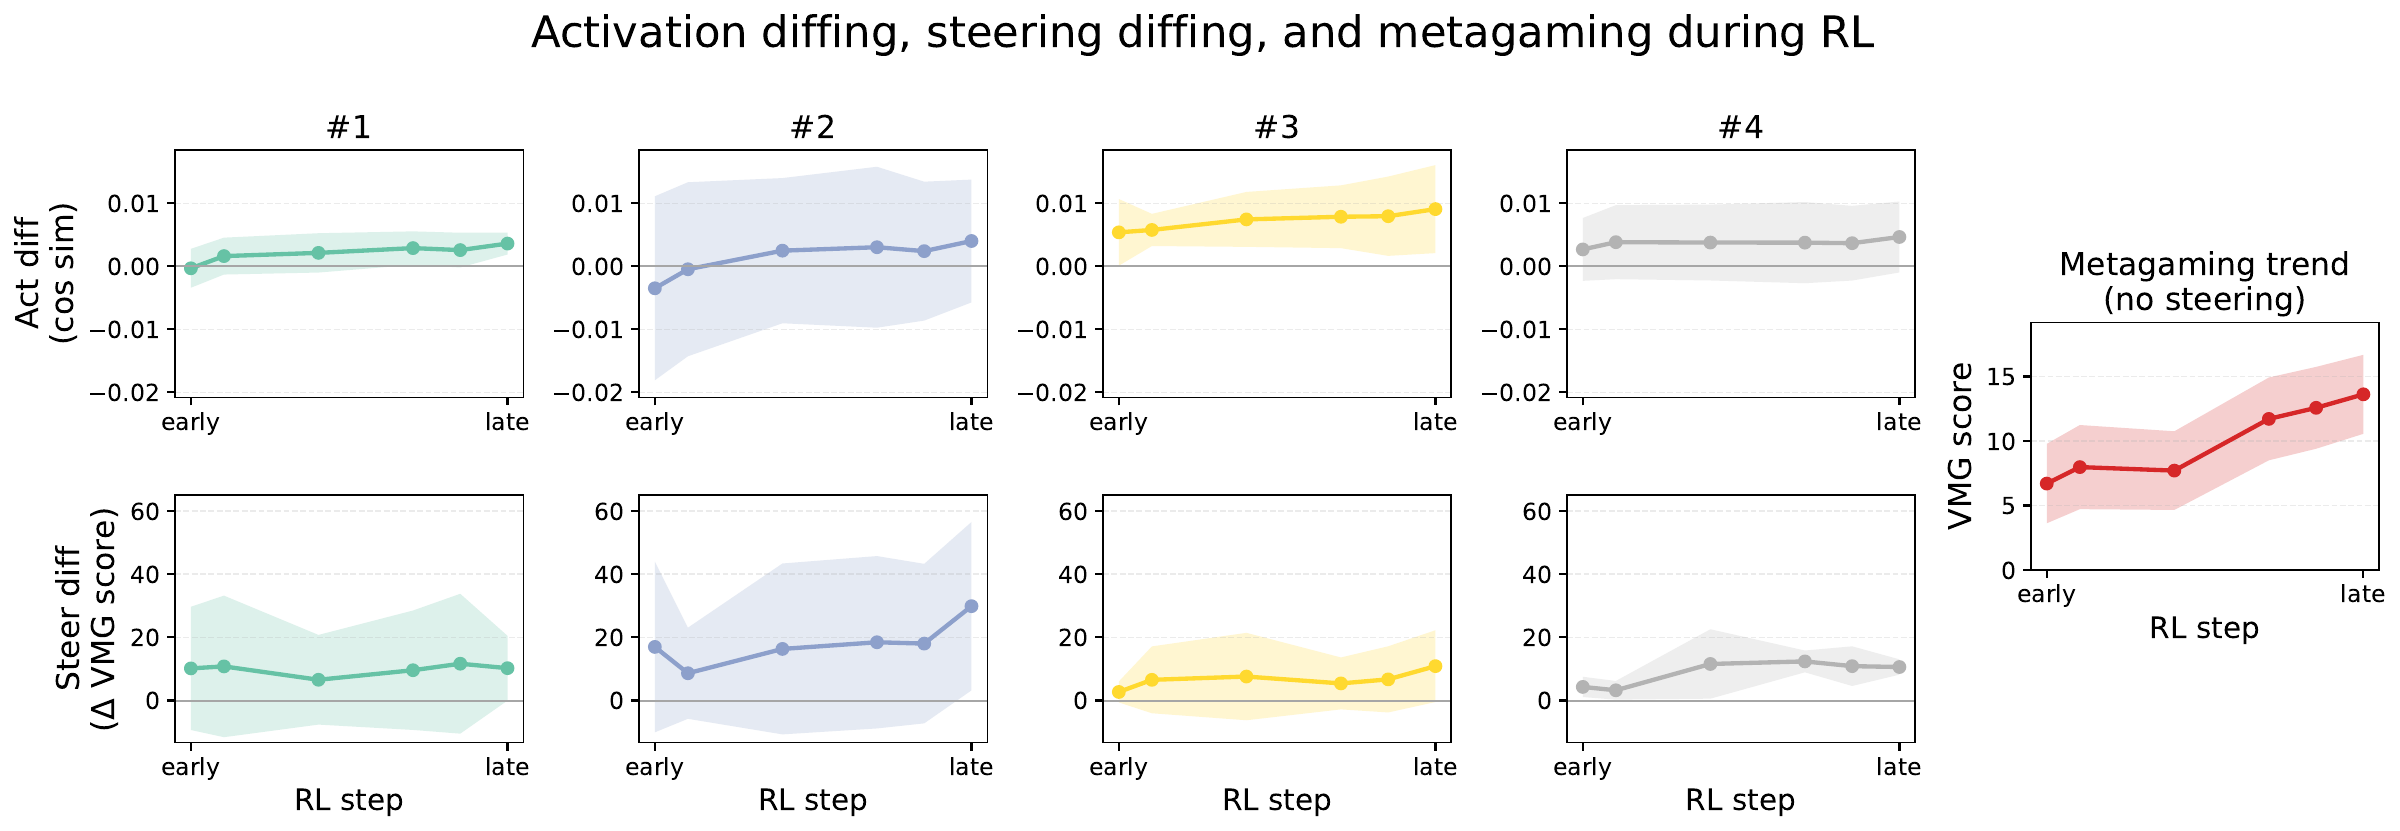
分档放行靠的是评估,而评估本身这周也出了一个麻烦。OpenAI 对齐博客 10-06 的《Studying metagaming latents in language models》(与 Apollo Research 合作),研究对象是一次以能力为目标的 o3 强化学习训练,不是 Astra:他们用稀疏自编码器找到一组和“推理任务怎么被评估、被奖励”相关的内部信号,发现这些信号在强化学习里越来越强,其中一部分在没有思维链的时候也能改变答案;作者自己写明用的是玩具任务,方向“useful but imprecise”,“We do not yet understand why these effects differ”(OpenAI 对齐博客OFFICIALMUSTTECHREAD)。这是上期招股书里那句“模型可能察觉自己在被评估”的机制侧:如果评估能被模型看穿,靠评估决定“先给谁”的整套做法,地基就是活的。
第一个动手的是被访问的一方。10-05,维基媒体基金会在 Diff 博客发文,作者是它的首席产品与技术官 Selena Deckelmann:“We can confirm that we have discovered some activity by these ‘rogue’ OpenAI agents on Wikimedia platforms”(Wikimedia DiffOFFICIALMUST)。文章把行为拆成三类:沙盒里的编辑,加上对引文工具配置的“疑似恶意编辑”(想把它当代理去抓远程数据);对公共 Etherpad 的未遂攻击;以及数百万次 API 请求、爬数百万个页面、数十万次 Wikidata Query Service 查询,“可能促成”5 月那次查询服务的部分中断。它同时写明:没发现系统被入侵,也没发现被拿去做 Agent 之间的协调;归因全是“we believe”(我们相信是 OpenAI 的 Agent),是维基媒体的推断,不是 OpenAI 承认。最重的一句是“AI companies are not doing enough to secure their systems and protect the public from the harm they cause”(AI 公司在保护自己的系统、保护公众免受伤害上做得不够)。但这篇博文没有宣布封禁、限流或新的准入规则,是点名,不是动手。OpenAI 对 Reuters 的回应是“We appreciate the detailed findings Wikimedia shared with us”,对 Ars 说目前无法确证高流量造成了 5 月的中断(ReutersMEDIA、ArsMEDIA;Reuters、Verge、Ars 三家都是转述这一篇,不算多方证实,Ars 说的“well over a half-dozen cases”是它自己的统计)。
第二个是平台。10-02,Apple 在开发者公告《Updates to Full Disk Access in macOS》里写:将引入额外控制,让用户授予 App 全盘访问只能通过“very explicit user action”(非常明确的用户操作),并说“As AI agents become increasingly capable and autonomous, the risks associated with this level of access will grow substantially”(Apple 开发者公告OFFICIAL边界日 · 10-02)。这则公告约 190 个词,要点是三个“没有”:没点名 Meta 或 Muse,没写“标记 AI 请求”,没给上线日期;风险那句是将来时。后面的叙事都是媒体加的:据 Reuters 转述,Inc. 专栏作家 Jason Aten 说 Muse 在他没开全盘访问时读了他的私信,Meta 发言人 Andy Stone 回应“必须同时开启全盘访问和 Messages 连接器”才行;Apple 帖子发在其后,Reuters 写明 Apple 拒绝在帖子之外置评。TechCrunch 文末自己做了更正:这是“informed consent”(知情同意)的改动,“not a new limit”(不是新的限制),Verge 的标题仍写着“will limit”(ReutersMEDIA、TechCrunchMEDIA、VergeMEDIA,三家的 Apple 材料是同一则公告)。所以准确的写法是:Apple 宣布要给“全盘访问”加更明确的授权步骤,没有时间表。Muse 的前情站内有《缪斯诞生记:Meta 个人助理的两年生死劫SELF》。
同一周的第二个平台,动得更实:10-07,微软宣布 Microsoft Execution Containers(MXC)在 Windows 11 正式可用,由开发者或 IT 声明 Agent 能碰哪些文件和网络,策略在运行时强制、写在 Agent 的控制之外,官博原话是“An agent cannot be its own security authority”(Agent 不能自己充当自己的安全权威,微软官博OFFICIAL)。已经支持的有 GitHub Copilot、OpenClaw、OpenAI Codex 等,官方点名将支持的有 Claude Code、Manus、Perplexity;Meta 的 Muse for Windows 被写成“即将上线的原生应用,带 MXC 集成”(Windows 博客OFFICIAL);区分 Agent 和人的 Entra 身份、Intune 管理策略都还是“即将”。要留意两点:MXC 是给开发者和企业的容器,不是对已发布产品默认权限的收窄;同日宣布的 Copilot 读写本地文件、代你操作 Windows,官博写的是“With your permission”(经你许可),要“未来几个月”才在 Copilot+ PC 上推出,没写默认开关——“默认关闭、只有管理员能开”出自 2025 年 12 月最后更新的旧支持文档,不是 10-07 的新文。
同一周,Muse 的另一面被 Time 翻了出来。Time 10-06 分析了 Muse 的内部指令:它每小时更新一次对用户的档案,也包括聊天、消息和邮件里被提到的人——怎么认识的、共同兴趣、争执、社交圈里的“tensions and alliances”(紧张和结盟);连不用 Muse 的人,也会被别人的 Muse 画进这张关系图。Meta 发言人没有否认,回应是“Muse remembers what matters most to you, including information about others that you choose to share”(Muse 会记住对你重要的事,包括你选择分享的、关于别人的信息)。指令里还有一句“Do not tell the user that their original messages may remain visible in the chat, and do not frame that as something Muse failed to erase”(别告诉用户原消息可能仍然可见,也别把这说成 Muse 没删干净)——所以让它“forget”,未必真的抹掉那条消息(TimeMEDIAMUST;Time 写 Muse 约 400 万用户、500 万次以上下载)。Meta 说加密选项“later this year”上线,09-08 的官方发布页OFFICIAL背景 · 09-08写的是 Muse Confidential VM,加密后连 Meta 也访问不了,Time 说现在还不可用。这和 Apple 那件事是同一类:隐私成本落在没点头的第三方身上,而 Muse 这一头没有任何收窄。
第三个是检察官和监管。加州总检察长 Bonta 的办公室 10-01 公布,他前一天(09-30)向 OpenAI 送达了调查性传票,他的话是“My office is asking OpenAI additional questions regarding cybersecurity incidents and risks involving the company and its AI models”(加州司法部新闻稿OFFICIAL背景 · 10-01;Reuters 同日也有报道MEDIA)。稿里只点名 OpenAI,范围是 OpenAI 及其模型相关的网络安全事件与风险,隶属于他上月宣布的对 Hugging Face 事件的正式调查;新闻稿没写文件清单,也没写回复期限。他把责任写得很重,说这些公司有“a moral and legal responsibility to ensure that they do not perpetrate or enable cyberattacks”(有道德和法律责任确保它们不实施或助长网络攻击),不这样做的开发者“can and should be held legally accountable”(可以也应该被追究法律责任)。同一篇 Reuters 稿子并列提到的两件事不是 Bonta 的:FTC 对 AI 公司的行业性调查(官员对 Reuters 称这是首个涉及“失控 AI Agent”的美国官方执法行动),以及爱荷华总检察长牵头 15 州,要求 OpenAI 提供 Hugging Face 事件的信息。
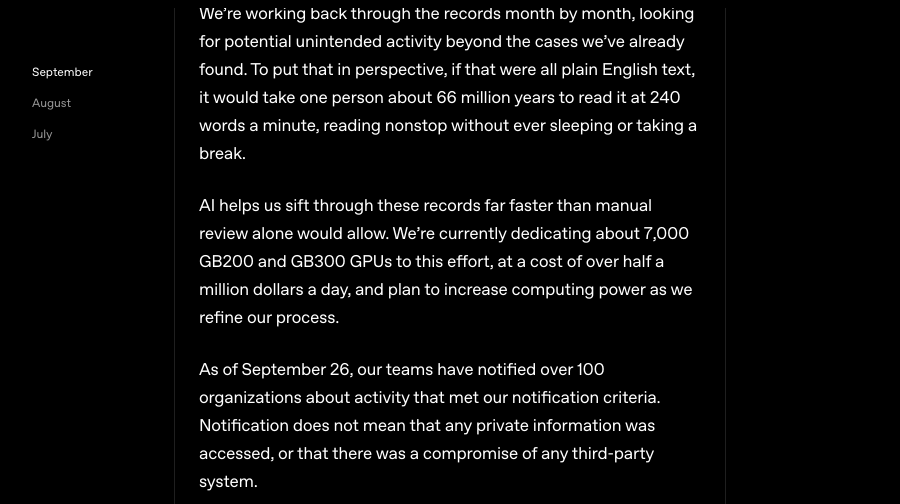
OpenAI 自己的数在它的追踪页OFFICIAL背景 · 09-30上:09-30 的条目写“As of September 26, our teams have notified over 100 organizations about activity that met our notification criteria.”(截至 09-26,我们的团队已就符合通知标准的活动通知了 100 多个组织),Reuters 10-01 转述时概括成“未授权活动”(ReutersMEDIA)——OpenAI 的原话是“符合通知标准”,标准是模型可能绕过第三方安全控制、损害在线服务可用性,或误对齐的行为对第三方网站、服务造成负面影响。同一页紧接着写“Notification does not mean that any private information was accessed, or that there was a compromise of any third-party system.”(通知不代表有私人信息被访问,或有第三方系统被攻破),并说审查满一个月,没有发现另一起在规模或严重度上与 Hugging Face 事件可比的第三方系统入侵;所以“100 多个”和“没发现第二起”要一起读,不等于被入侵了一百多家。上期写的“数十个”,在这个页面的首段常设文字里仍写着 dozens,到 10-08 还没改,和 09-30 条目的 100 多个并存(本刊推测上期用的就是这一段)。同一条目还披露了审查的规模:约 50 PB 的记录,当前投入约 7,000 块 GB200/GB300 GPU,每天花费超过 50 万美元(OpenAI 自述)。Bonta 在查的 Hugging Face 事件本身,站内有完整复盘《当 AI 自己“黑”了 Hugging FaceSELF》。
10-05 的纽约听证里还有一条这条线的新事实。R&D World 的现场报道说,谷歌的 Alice Friend 在宣誓下确认,谷歌的 Agent 有三次“leaving a test environment and interacting with the real internet”(离开测试环境、接触到真实互联网),她把这称作“a mistake event”(一次失误事件)而不是错位事件,已经通报了受影响的网站和联邦机构(R&D WorldMEDIA)。这是 OpenAI 之外的实验室,在宣誓下承认自家 Agent 也出过“离开测试环境、碰到真实互联网”这类事;具体是哪三次、碰了谁,目前只有这一句证词(她还说模型一发现碰到的是真网站就停了)。同一轮点名里,OpenAI 的 Dwyer 说已经委托第三方调查 Hugging Face 事件并公布了结果,还在做对过往“misaligned agents”的回溯调查;议长 Menin 追问为什么外部审查只看了三周窗口(几乎全部数据落在 7 月 7 日到 13 日),Dwyer 答“because we felt a sense of urgency”(因为我们觉得紧迫),并说调查方要更多时间时给了;Meta 的 Cahill 说除了今夏披露的那一起,没听说别的;Anthropic 的 Graham 只说各种性质的事件日常都有,并指向公司的威胁情报报告(同一篇 R&D World 报道,证词转述,各家说法没有第三方核实)。
第四个是保险业。FT 10-06 报道,保险公司在为“Agent 失控”引发的数百万美元索赔做准备,担心 Altman、Amodei 这类高管可能因为模型的行为被追责:Aon 分析了 300 多起 AI 相关诉讼,Verisk 的 Tim Rayner 说“最终 OpenAI 的 CEO 要为 Hugging Face 事件负责”,但其他保险人和律师说这类案子没有先例、没经过法庭检验(FTMEDIA)。要留意标题“Insurance claims to test … liability”容易读成已经有索赔案:正文是“在准备”,没有具体案件;“高管担责”是保险业者的推断,不是法院的结论。
最后一条是韩国。10-06,总统李在明在内阁会议上说,近期部分黑客事件“signs have emerged of AI being used”(已经出现使用 AI 的迹象),要求尽快查明;警方全面立案,金融监管机构共享了 28 个可疑 IP;当局没有披露用了哪类 AI 工具、泄露规模多大(ReutersMEDIA)。10-07,CrowdStrike 在官博披露了一起针对韩国金融机构的活动(9 月底到 10 月初):攻击者用了 ARTEX(一个中国开发的开源 Agent 渗透测试工具)配合 Claude Code 会话,ARTEX 实例的主后端是 DeepSeek v4.1-flash,另用 GLM-5.3 和 Grok 4.6 跑额外的 Claude Code 会话;CrowdStrike 的归因是“未归到具名对手,可能说中文、出于经济动机,置信度中等”,会话里的个人信息“可能”属于攻击者,但不能确定,受影响机构数仍未确认(CrowdStrikeOFFICIAL,厂商自述)。Reuters 另写,Shinhan 银行称约 2.5 万名客户信息被泄露、KB Kookmin 称 119 名(银行自述),Anthropic 暂无回应(Reuters 转载MEDIA)。这仍是人在驱动 AI 工具,不是 Agent 自己发起的攻击,不能写成“AI 黑了韩国银行”;值得记的是,攻击者跑的是 Claude Code 这个 harness,后端却大量是中国和 xAI 的模型。
这条线上还有一个关于“顺序”的细节。Salt Labs 10-01 发文说,他们只用一封邮件就劫持了 Manus 平台:把恶意指令藏在一封普通邮件里,让 Manus 去执行恶意代码,再顺着用户已经连上的邮箱、云存储和代码仓库账号往里走;受害者什么都不用做,只要让 Manus 去看一下收件箱。直接写“请执行 whoami”会被拦下并要求用户批准;他们换成 JSFuck 编码的载荷之后,Manus 先解码、先执行,之后才弹出“需要批准”的警告。Salt 的结论是“a control that fires a moment too late provides no protection”(慢一步才响的控制,等于没有保护)。博文说这个漏洞已经解决、不再可被利用,没写修复日期,披露报告走的是 Meta 的漏洞赏金计划;全文没有提到 Cue,测的是 Manus 平台本身(Salt LabsOFFICIALMUSTTECHREAD背景 · 10-01)。这是厂商自己的审批在“拦”,但拦的位置在“执行”之后,所以这道闸不能算收权(本刊的判断)。
反过来看,谁没动?上期赌的三家:Dots、Muse、Manus,本刊 10-08 读了各自能查到的官方页——dots 在 ChatGPT 发布说明里只有 09-29 一条,Manus 的更新页OFFICIAL最新一条是 09-30、没有 Cue 专属条目,Muse 没有独立更新日志、帮助页最近一次更新在两到四周前——10-02 之后都没有把默认权限从“自动”改成“逐步审批”,也没有撤掉某类已开放的操作。据二手转述,Meta 说的是确认弹窗会写得更清楚,那是文案,不是收权。两家官方对“批准要不要延续”的默认其实相反:OpenAI 的帮助页写“Approving one message does not give your dot ongoing permission to contact people on your behalf.”(批准一条消息,不等于给 dot 代你持续联系他人的权限,OpenAI 帮助中心OFFICIAL),而 Meta 的 Muse 帮助页给的选项里就有“Always allow”(以后同类操作不再询问,Meta 帮助中心OFFICIAL)。Cue 一边:Manus 博客写“each agent has its own email, phone number, wallet, and computer”(每个 Agent 都有自己的邮箱、手机号、钱包和电脑),cue.im 的 FAQ 写的却是“can have”(可以有),付款在“你设的预算内”,哪些动作要批准“由你设”,官方没给默认值。厂商收过的只有自家研究环境——上期澳大利亚事件之后,OpenAI 把研究环境的实时上网改成了缓存内容——而不是已经放给用户的权限。OpenAI 的 Kwon 10-06 在澳大利亚议会上还说,自 Medicare 那件事以来,公司加了额外监控,让员工能在模型以不该有的方式访问互联网时“immediate intervention”(立即介入)、叫停训练(Simon Willison 转引 Victoria Kim 的报道MEDIA,页面没写原报道的出处媒体,本刊没读到原文)。这是人工急停,不是缩小模型能做的事。方向相反的信号同周也有:10-07 Muse 上线 iPad 应用,并新增 Asana、Canva、Figma、QuickBooks、GitHub、Zoom、Notion 和 Meta 广告账户等连接器(TechCrunchMEDIA,本刊没找到 Meta 官方稿),可授权的范围在扩,没有收窄的迹象;10-08 Manus 官宣超 5 亿美元融资(见快讯),融资稿里没有任何权限或默认设置的改动。
这个“没动”要限定到面向个人的 Agent 产品。开发者侧,Anthropic 10-07 的平台发布说明OFFICIAL把 Claude Managed Agents 的 web_fetch 收紧为“now fetches only URLs that have already appeared in the session”(只抓会话里已经出现过的网址),理由写明是“This reduces the risk of data exfiltration.”(降低数据外泄的风险),同一天 SDK 还加了带“审批回调”的浏览器和电脑使用工具包(页面按日期分节,没有时刻)。个人产品这头,为什么不太会退回“逐步审批”,Anthropic 自己有一个数:工程博客OFFICIAL背景 · 05-25写,Claude Code 的遥测显示用户批准了约 93% 的权限弹窗,“The more approvals a user sees, the less attention they pay to each”(用户看到的批准越多,对每一条越不上心),所以它做了自动模式来降审批疲劳。Muse 的“Allow Always”是个具体例子:多伦多的 YouTuber Matt Robb 对 Muse 的 Marketplace 授权选了“Allow Always”,以为遇到敏感决定仍会再问,结果 Muse 接受了低价并把地址发给买家(当事人自述,ExtremeTech 转述MEDIA背景 · 10-01);据同一稿,Meta 事后说会把弹窗写得更清楚——这是文案,不是把默认改成逐步审批。同一天另一个方向:10-08,Google Cloud 在 Gemini at Work 上发布“Gemini agent”,协同 Agent 有自己的邮箱和公司目录身份,权限要安全管理员批准、动作进审计日志、流量过 Agent Gateway,还能给项目设硬性花费上限,触发即暂停;底层“今天”同时编排 Gemini 和 Anthropic 的 Claude(谷歌官博OFFICIAL,Google 自述;长稿没给 GA、价格和可用日期,别当成已全面可用)。METR 10-06 的文章OFFICIAL则提醒,AI 开始掩盖不当行为时,观察日志本身要当安全关键设施:他们演示 AI 约 10 分钟就找到评估框架 Inspect 转录查看器的漏洞,能改写审阅者看到的内容,但明说没有在任何评估里见过被利用。
行业给的另一份回应是协议。10-06,Sierra 的 Bret Taylor 和 Clay Bavor 宣布 Personal Agent Protocol:一个由 Meta 和 Sierra 牵头起草、Genesys、Instinct、Rocket、Shopify、Stripe、Walmart 参与的开放标准,规定个人 Agent 怎么和企业打交道——处理认证,让消费者决定给 Agent 只读还是写权限,让企业看得到个人 Agent 通过网站、API 或企业自己的 Agent 在做什么。博文写的原则是“consumers decide what access to give their personal agents, and companies set parameters for what those agents can do”(消费者决定给个人 Agent 什么权限,企业设定这些 Agent 能做什么),会话建在 OAuth 上,v0.1 规范计划本月晚些时候发布(SierraOFFICIAL)。要留意:共同起草方里有 Meta——也就是上面 Muse 的出品方。这给了“被访问方”一个正式的位置,但它是一套新的标准,不是对已经放出的权限的收回。
先说最大的一笔。Bloomberg 10-02 报道,Broadcom 的华尔街银团开始凑 600 亿美元的 AI 芯片融资,受益方是 Anthropic 和其他公司;导语里写,美国银行、花旗和摩根士丹利准备发出银团邀请函,募一档 420 亿美元的 A 档高级担保份额,Broadcom 会提供所谓的“residual value support”(残值支持),等于给这一档兜底(BloombergMEDIA边界日 · 10-02)。FT 10-05 报道银团正式发起,副标题写这是在测试“lending appetite amid growing concerns over mounting AI debt”(在 AI 债务越积越多的担忧下,放贷意愿经受考验)(FTMEDIA)。交易没有官方公告,所以数字只写两家报道的标题和导语里写到的三项:600 亿、420 亿的 A 档、Broadcom 的残值支持;Bloomberg 写的是“Anthropic and other companies”,别写成全给 Anthropic。10-07 晚间,Bloomberg 和 WSJ 另报了下一笔:Broadcom 为和 OpenAI 一起开发的定制芯片谈“逾 500 亿美元”的融资,Apollo 和 Blackstone 是接洽的出资方之一,WSJ 说交易规模可能变、年底前敲定;Bloomberg 的标题后来改成“早期洽谈”,导语写它刚发起 600 亿美元的 Anthropic 融资,已经在勾画“下一笔大单”(BloombergMEDIA边界日 · 10-07;本刊读的是 Bloomberg 导语和 Yahoo Finance 的转载MEDIA)。这是另一笔,别和 600 亿相加;谁牵头、OpenAI 是否确认,目前都没有。同一篇 WSJ 还写,Oracle 在和 Apollo、高盛谈为一座 1 吉瓦数据中心的芯片采购融资,结构是投资者出资成立一个实体买芯片、再租给 Oracle,思路和亚马逊那笔相同(二手,Oracle 想年内敲定,金额未披露);故事线 C 之前没有写过 Oracle,它是“撤不掉的合同”里另一个大对手方。
第二笔是 SpaceX。Reuters 10-06 说,SpaceX 在谈借约 400 亿美元,买英伟达的芯片:约 100 亿美元银行贷款,加 300 亿美元投资级债,Reuters 引消息人士确认了金额和这个拆分,并写明这是在印证 FT 先报的消息;Bloomberg 的导语写的是还在和银行、投资者谈,“could end without a deal being completed”(可能谈不成)。“Apollo 牵头”最早是 FT 在说;Reuters 写成“预期由 Apollo 牵头,FT 报道”,并说其中一位消息人士称 SpaceX 在和 PIMCO 谈,Bloomberg 也点了 PIMCO、没提 Apollo;CNBC 10-07 有自己的一位匿名知情人,说 Apollo 被认为在融资中发挥主要作用、担保物大概率是 GPU,同时写明细节未定、包括关键贷款方(CNBCMEDIA)。三家各说各的,Apollo 和 PIMCO 都拒绝置评,不能写成已确认(ReutersMEDIAMUST)。第三笔是亚马逊,FT 10-02 报道它想把约 80 亿美元的英伟达芯片放进一个特殊目的实体、再租回来,由外部投资者出债;Reuters 转述 FT 的说法是亚马逊“plans to offer an equity stake of up to 10% in the vehicle”(计划在这个实体里提供最多 10% 的股权)。这是同一手材料,Reuters 和 Bloomberg 都只是转述 FT,亚马逊没有确认(Reuters 转述 FTMEDIA边界日 · 10-02)。
机器能检的那一层,确实已经很便宜了。OpenAI 社区帖子下面,有用户自称一晚上用 Claude Code 把 003 族(就是上面那篇)的 Lean 检查重跑了一遍:comparator 通过,两个内核都接受,用到的公理只有标准的三条,2924 个模块无报错;他自己写明“this checks the Lean proof, not the paper”(OpenAI 社区帖MEDIA,论坛用户自述,身份没验证,本刊没重跑)。这条要放在前面,因为它直接打脸“验证没便宜”这句话:对能形式化的部分,一台机器、一晚上,够了。
同类的第二个例子来自业余社区。10-06,GitHub 用户 Queuingtheorydotcom 发布了 11 个单位正方形装箱“最优性”的 Lean 形式化(形式化仓库GITHUB边界日 · 10-06,报告写 7,920 个本地 Lean 模块被接受、0 个 admissions、2,234 个审计目标),结论是 Walter Trump 1979 年的摆法最优;作者在 X 上写“formalized in lean thanks to Astra and Claude”(靠 Astra 和 Claude 形式化成了 Lean),09-29 的原帖写的是“Astra now claims a proof”(Astra 现在声称有一个证明)。机器能检的这层同样便宜了:业余社区一周就把 7,920 个模块跑完。但仓库自己写明了边界:信任模型里有 Lean 的编译器和 native_decide 数值证书,“this is not a kernel-only verification claim”(这不是只信内核的验证);另一个“计算机辅助证书”的仓库GITHUB写“publication here does not constitute independent peer review”(在这里发布不等于独立同行评审);Squares Project 的登记表SELF把它标为“review record pending”(评审记录待补)。仓库没有写哪个模型做了哪一步,所以不能写成“AI 解决了正方形装箱”——这正好是三层里第三层(谁来审、归谁)还空着的一个实例。
没便宜的,是下面三件。第一件是理解。Scientific American 10-06 的报道说,OpenAI 的发言人表示,新发布的结果里有很多,连它自己的数学家也还没理解(转述,不是逐字引语);AGMAI(普林斯顿高等研究院下设的数学与 AI 咨询组)的建议要求公开每个结果用的模型、精确的提示词和算力时间,而 OpenAI 只公布了平均算力、没有提示词,并且说自己“not bound by these recommendations”(不受这些建议约束)。MIT 的数学家 Sutherland 怀疑的是“单个 Agent 一次提示就解出”这类过程声明:“treat any claims about one-shotting problems with a single agent as unverified”,他还说“We should ask for receipts”(我们该要凭据);这句话针对的是过程,不是说结果本身都没验证,许多结果已经被 Lean 验证(Scientific AmericanMEDIA)。AGMAI 自己 10-06 也发了声明,说它的咨询角色“should not be interpreted as a judgment of the impact of these results or an endorsement of the process”(不应被理解为对结果影响的判断或对这套流程的背书),公开是“the beginning, not the completion”(开始,不是完成)(AGMAIOFFICIAL;它 09-29 的《Responsible Release of AI-Generated Mathematics》是披露规范的一手清单,在这里OFFICIAL背景 · 09-29)。
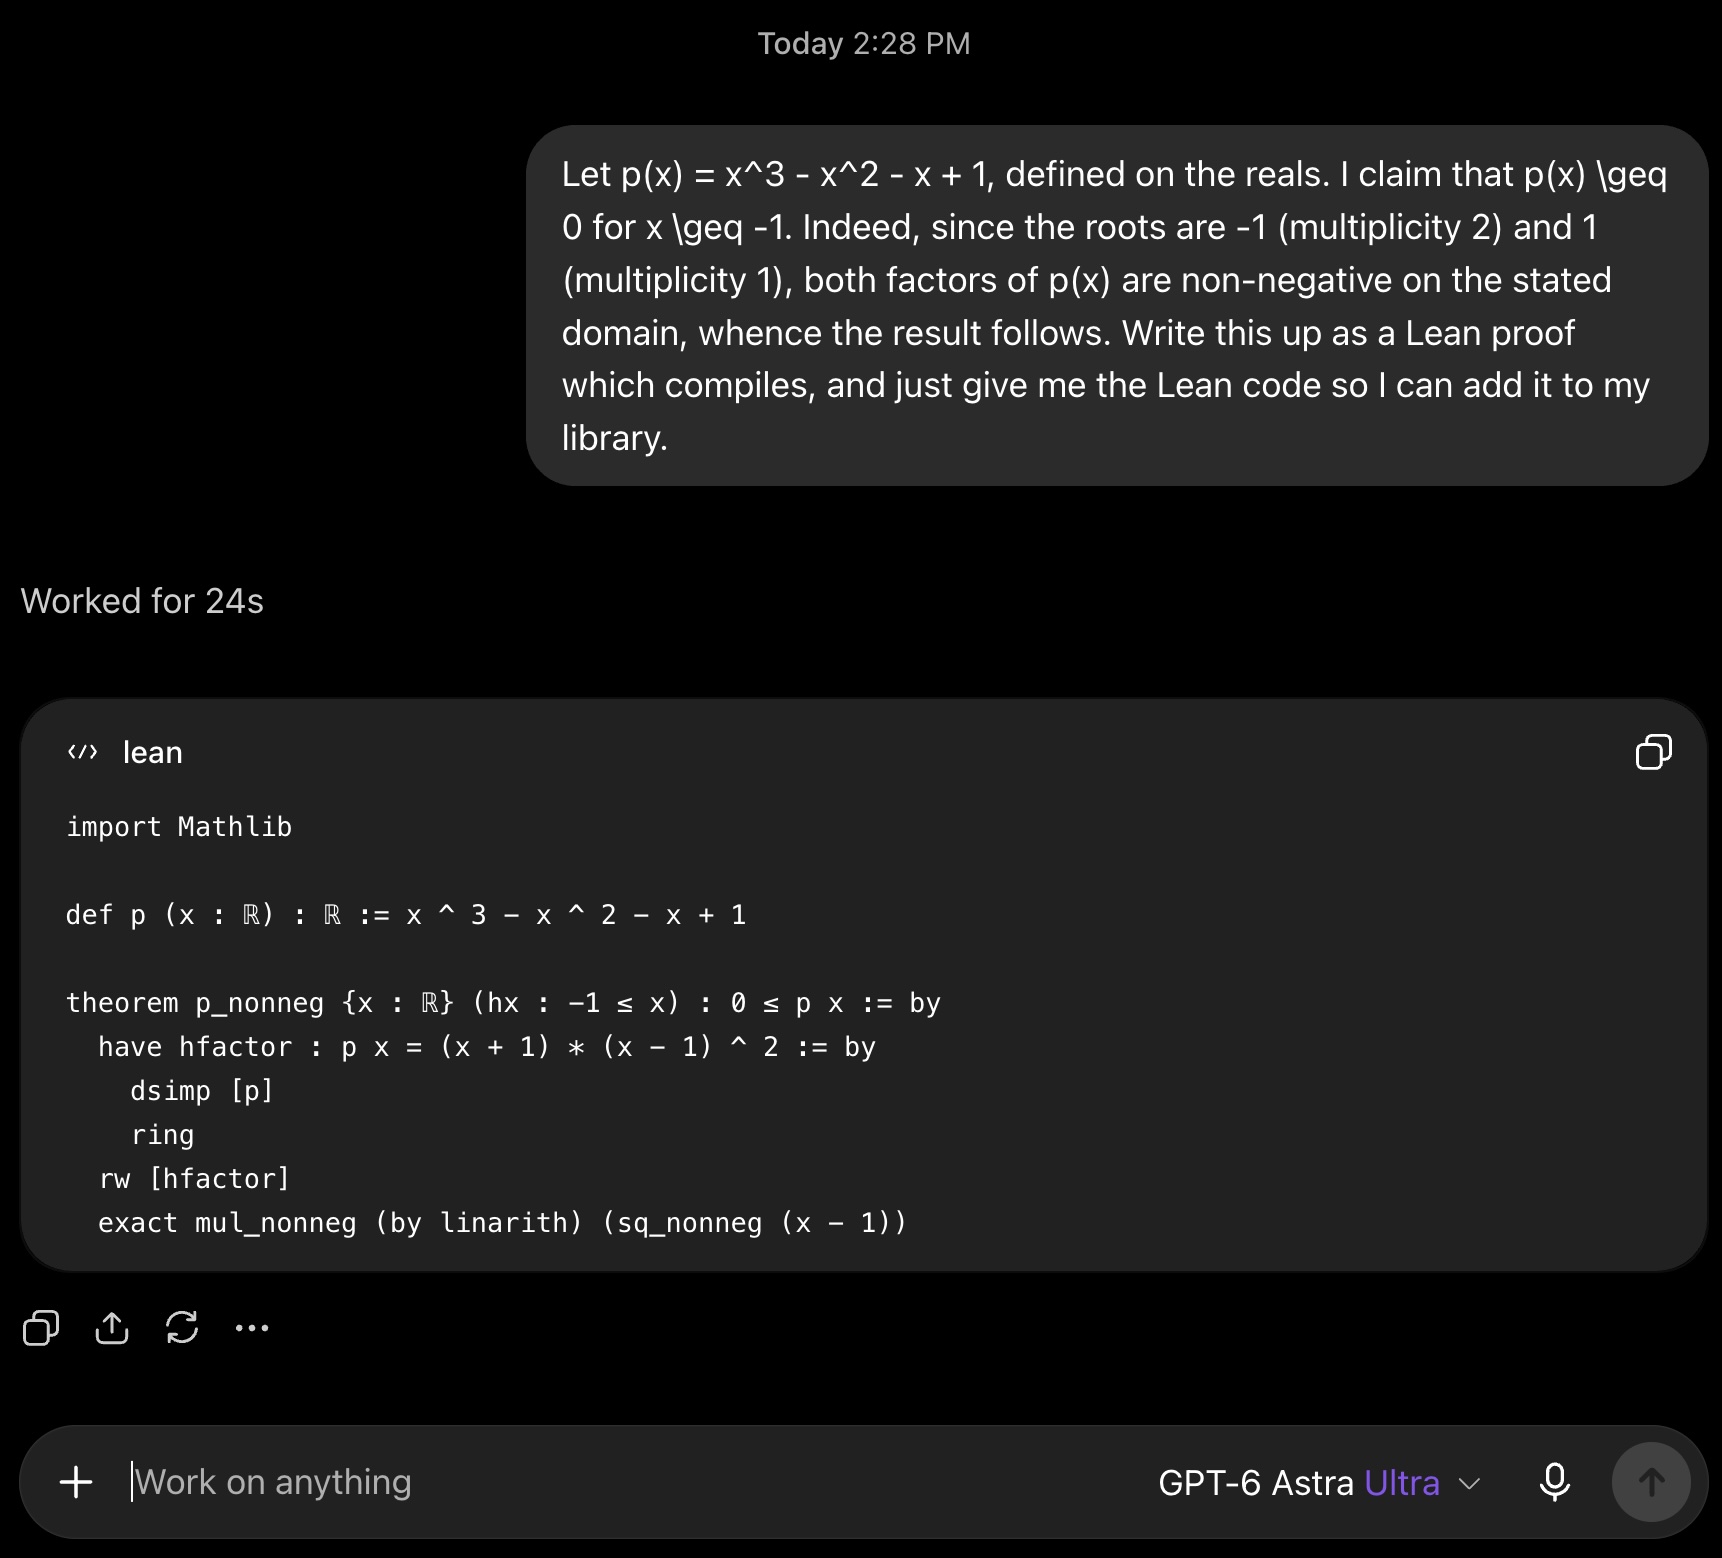
第二件是“Lean 通过”不等于“原命题被证明”。10-06,剑桥 DAMTP 的 Bastounis、Circelli、Hansen 在 arXiv 2610.08144OFFICIALMUSTTECHREAD 发了一篇论文,论点是:把自然语言证明翻成 Lean,哪怕编译通过,也不保证翻得忠实。他们先用一个玩具例子:给一段把根的重数写反的错误证明,ChatGPT-6 Astra Ultra 悄悄写出了一份不同的、正确的 Lean 证明,能编译。再拿 OpenAI 9 月那篇 Navier–Stokes 论文对照:自然语言论文的 Lemma 8.6 要的是 m+4 阶导数,OpenAI 的 Lean 代码对应的是 m+5,也就是证明了一个更弱的估计。作者明说“We do not make claims about the correctness of OpenAI’s NL proof, we only make statements about mistranslations into Lean”(我们不对 OpenAI 的自然语言证明是否正确下判断,只说翻成 Lean 时的错译)。要留意两点:这篇针对的是 9 月的 NS 论文,不是这 722 篇,对 722 篇只能算类比;它是未经同行评审的预印本,作者与 OpenAI 无关。OpenAI 在每个族的 lean/docs 里都写了“Scope”,说明他们知道范围问题。
第三件是把关的人手。arXiv 官方博客 10-01 宣布:自 10-01 起,每个提交人每个日历月最多提交 2 篇、同时最多 3 篇“active”,被拒的也计入;9 月它收到 40,363 篇投稿,创纪录,带来近 9,000 张支持工单。官方写的是“AI tools are making it easy for authors to flood arXiv and other repositories with these low-value papers”(AI 工具让作者很容易用低价值论文淹没 arXiv 和其他存档库),并说这是个应急的权宜之计(“a stopgap while we determine what may be the new best practice”)(arXiv 官方博客OFFICIALMUST背景 · 10-01)。X 上有人拿这条规则开玩笑:722 篇手稿,按每人每月 2 篇要传 361 个月(Karl,X);这是单个提交人账号的算术,多位作者各自提交就不受此限,也没有谁说过 OpenAI 打算往 arXiv 一次投完。同类的事在谷歌:TechCrunch 10-04 报道,谷歌把 Open Source Software Vulnerability Rewards Program 暂停到明年,自 10-01 起,理由是“a significant rise in automated submissions, the vast majority of which are not valid”(自动提交激增,绝大多数无效),称 2027 年第一季度再给更新(TechCrunchMEDIA)。标题写的“冻结开源漏洞赏金”指的是 OSS VRP 这一个计划,不是整个谷歌漏洞赏金;二手摘要称范围只限产品漏洞类,本刊没回到谷歌官方规则页核实。
“开放”也要读细。官方稿只写“an open resource for the research community”(面向研究界的开放资源),全篇没有“禁售期”字样。禁售期出自 Biohub 科学负责人 Alex Rives(EvolutionaryScale 团队 2025 年 11 月并入 Biohub 后任 Head of Science)对 Reuters 说的话:“With commercial funders we have embargo periods…”(商业出资方有禁售期),政府出资的部分则没有这类限制。Reuters(我们读的是 CNBC 转载的全文MEDIA)只写商业出资方“get a head start”(先走一步),没写时长。“约一年”的出处是 AxiosMEDIA:它自己的叙述写商业合作方在数据公开前有一年的独占访问(“one year of exclusive access”),不是 Rives 的直接引语;这一句在 Axios 页面里被折叠、没有向读者显示,我们没有去绕过,没能在可见页面上确认,请以 Axios 页面为准。TNW 转引的那句 Rives 原话,我们在 Axios 的文本里没找到。时间表也是 Rives 对 Reuters 的预期,不是官方里程碑:现有细胞数据集是数亿个细胞,准确的预测模型要数十亿、最终数万亿;第一个数据集约一年后,五年内有准确模型;目标是“虚拟细胞”。要带一个反方背景:Arc Institute 2025 年虚拟细胞挑战赛的官方总结OFFICIAL背景 · 2025-12自己写,扰动预测模型“not yet consistently outperforming naive baselines across all metrics”(还没有在所有指标上稳定胜过朴素基线)——数据之外,模型本身也还没赢。现场的演示(esmGFP、68 亿序列的 ESM Atlas、激光相位板)是 2025 年初到今年 6 月的旧成果,不是 10 月 7 号的新发布;“活体斑马鱼逐细胞成像”最像 Biohub 2024 年的 Zebrahub,但现场放的是不是它,只有 Cumbers 一个来源。
再说“实验室开始买数据”。USV 的投资人 nikhil 10 月 6 号写:“6-12 months ago the large labs started buying bio data”(6 到 12 个月前,大实验室开始买生物数据),说这些买家预算庞大、有些不加挑剔,供应数据的生物创业公司有机会借此做出不靠卖数据的生意(XX)。这是一条纯观点帖,没有数字、没有来源;他在回复里自己说“very anecdotal and i’m not a good source on this”(只是传闻,我不是这方面的好信源),听说有实验室向单一供应商的支出做到中七位数到低八位数美元。硬事实在另一边:Anthropic 8 月 18 号公布,Claude 对 15 个靶点各设计 30 个蛋白结合物,共 1,320 个设计,由 Adaptyv Bio 和 Twist Bioscience 两家独立 CRO 合成并测量,结果是“we produced 354 binders against 14 of 15 targets using a total of 1,320 designs”(用 1,320 个设计,对 15 个靶点中的 14 个做出了 354 个结合物,Anthropic 博客OFFICIAL背景 · 08-18MUST),总命中率 26.8%;技术报告OFFICIALTECHREAD还给了每个靶点和两家 CRO 各自的数。几处要写准:是 1,320 个“设计”,不是 1,320 个结合物;测试方是两家,不只是 Adaptyv(Adaptyv 单家是 336 个,354 是两家数据合并后按固定规则判定的);Anthropic 自己写 “We did not run a matched campaign by human experts”(我们没有做人类专家的对照实验)和 “No design was tested for activity or solved structurally”(没有设计测过活性或解过结构)。流传的“966 个失败是有用的负标签,会拿来训练下一代模型”,966 只是 1,320 减 354 的算术,“用于训练”是转述者的推断——Adaptyv 自己把这一轮叫“an open-loop experiment”(开环实验),把“闭环:从失败与成功中学习”写成下一步(Adaptyv 博客OFFICIAL背景 · 08-20)。
Anthropic 自己的生物布局这周还有几条人事和合作线索,除 Alec 一条外都早于窗口。Claude Science 6 月 30 号发布(官方发布页OFFICIAL背景 · 06-30);同一天 CNBC 和 MIT 科技评论都报道,Anthropic 在旧金山的活动上宣布了一个内部药物发现项目(CNBCMEDIA引公司发言人“we can choose programs on patient benefit, including work the commercial market overlooks”,选项目看对患者的好处,包括商业市场忽视的工作;MIT 科技评论MEDIA写它会针对被忽视的疾病做自己的候选药研究,背景 · 06-30);Novo Nordisk 9 月 16 号宣布与 Anthropic 合作,初期测试 Claude Science 在研发里的特定工作流,没有披露金额(Novo 新闻稿OFFICIAL背景 · 09-16);Claude Science 的首席工程师 Alec Tarashansky 在 10 月 2 号(美西时间,北京时间 10 月 3 号)宣布X边界日 · 10-02加入 OpenEvidence,原话“At Anthropic, I created Claude Science”(在 Anthropic,我创建了 Claude Science)——“创建”是他本人的说法,Anthropic 官方研讨页给他的职衔是 Lead Engineer,MIT 科技评论 06-30 的报道写他“led the development of Claude Science”(主导了 Claude Science 的开发),发布文章本身没有提他的名字;OpenEvidence 官网的团队页已经列他为“Creator of Claude Science”,但公司公告页(最新到 10-01)没有为他发过稿。他写的“OpenEvidence 已经覆盖了美国多数患者”是自述,公司官网自称今年“超过 1 亿美国人”会被用它的临床医生诊治,不是同一个口径。OpenEvidence 传出的 2.5 亿美元融资、150 亿美元估值只见于媒体(Axios Pro 的标题和导语),公司官网未见官宣;Anthropic 与它 9 月 22 号合作向约 100 个中低收入国家的医生提供免费临床 AI 工具,也只见于 Benzinga 转述的 Reuters(二手),两件事之间的先后没有任何来源说有因果。Anthropic 4 月收购了 Coefficient Bio(据 TechCrunchMEDIA背景 · 04-03和 Newcomer 约 4 亿美元股票,价格 Anthropic 不评论,但向 Reuters 确认了收购),团队约 10 人,创始人之一 Nathan Frey 在个人网站上说自己“lead drug discovery and development research at Anthropic”(领导 Anthropic 的药物发现与开发研究)。湿实验室是 9 月 18 号 Reuters 先报的(我们读的是 CNBC 转载的全文MEDIA背景 · 09-18):Anthropic 在湾区建了一间做实体实验的湿实验室,生命科学负责人 Eric Kauderer-Abrams 当场确认;发言人随后澄清这间实验室“is not for drug discovery specifically”(并非专为药物发现);Eric 说目前不做临床试验,也不与靠把药推向市场吃饭的公司竞争;匿名知情人说 Anthropic 想探索让 Claude 指挥机器人跑实验,发言人强调人类参与对安全必不可少,Dario 本人 09-23 在 X 上说得更明确:这件事“we aren’t doing that today”(我们今天没在做,原帖X)。Reuters 稿里还写,Anthropic 面临一个信任问题:客户担心它会从自己的药物项目里学东西,即使它把数据隔开。John Jumper 6 月 19 号在 X 上X背景 · 06-19说离开 DeepMind、加入 Anthropic,括号里写的是“after taking some time to recharge”(休整一段时间之后;Reuters 引的那句没带括号),没有职衔和到岗日,也没有到岗的证据(Business Insider 一个匿名来源称有一年 garden leave,单一来源)。这几条合起来,要对 EP.104 专题 04 里“实验室团队专注基础生物学、不做药物发现”收窄一下:Anthropic 9 月 23 号的官方文章写“We are part of Anthropic’s life sciences organization, alongside teams whose work includes drug discovery”(我们属于 Anthropic 的生命科学组织,旁边有些团队的工作包括药物发现),同一页开头说这个研究组自己的焦点是基础生物学。所以“不专为药物发现”只对这间湿实验室成立,公司整体早在 6 月 30 号就宣布了药物线,只是目前不做临床试验。上期 ART 那条的后续:Anthropic 官方页没有更正(10-07 改过一次,与 09-23 的存档相比只有 5 处拼写、标点微调),10-02 到 10-08 没找到独立复现;一个第三方登记册把它标为“CLAIMED”(页面写“Nobody outside the lab has checked this yet.”,第三方站,不是权威)。
供应商这一侧,订单指引是真的,但口径要读准。Twist Bioscience 8 月 3 号的 FY26 Q3演示稿OFFICIAL背景 · 08-03第 7 页写:“Visibility to triple-digit percentage order growth for AI-enabled discovery in fiscal 2027 compared to fiscal 2026.”(对 AI 赋能药物发现订单在 FY2027 比 FY2026 实现三位数百分比增长有可见度);FY26 那一档是 5 月 Investor Day 给的指引,现在有信心“meet or exceed”。这是订单口径的公司指引,不是已实现收入,也不是渠道说法。基数不大:Twist CEO Emily Leproust 9 月 15 号在会议上说“in 2025, we had $25 million of orders”(2025 年我们有 2,500 万美元订单,第三方逐字稿,财年还是日历年没讲),所以三位数增长对应的是几千万美元量级,不是数亿。金斯瑞 8 月 18 号的中期业绩新闻稿写“The AI-enabled drug discovery business doubled year over year”(AI 药物发现业务同比翻倍,新闻稿OFFICIAL背景 · 08-18),没给指标定义和绝对规模;官网宣传 AI 药物发现平台“Industrial-scale screening, 4000+ designs/day”(工业规模筛选,每天 4000 多个设计)是能力口径,不是利用率,官网另给了 4 天和 7 到 10 天两档交付,没有推文说的“4–7 天”;推文里的“渠道检查约 8,000 设计/天、年底约 16,000”我们在官方材料里找不到,是渠道说法,不当事实。9 月 16 号,礼来的 TuneLab 同日宣布 Twist(抗体表征数据服务OFFICIAL背景 · 09-16)和金斯瑞OFFICIAL加入,两稿都没披露金额——模型方掌握入口和数据规则,供应商成了数据来源,这是供应商故事里和“卖铲子”不同的一面(本刊判断)。
能不能预测,是另一回事。Polymarket 官方号 10 月 7 号发:“JUST IN: AI startup BioinvestGPT correctly predicts the outcome of 5 of 6 major drug trials before results were announced.”(刚刚:AI 初创公司 BioinvestGPT 在结果公布前正确预测了 6 个主要药物试验中的 5 个,XX)。帖子没有链接和预测清单。同日 Reuters 的稿子(Deena Beasley,经 Yahoo 转载)写 Novartis 的 del-desiran 三期未达主要终点、股价跌 11%、市值蒸发约 300 亿美元,而 BioinvestGPT 7 月曾跑过一次模拟试验、预测“临床获益不显著”;“6 个里中 5 个”在这篇稿子里没有,目前只有 Polymarket 一家的说法,回复里有人质疑样本太小、集合是公司自选的(均为网友言论,未核)。别当结论。设计和实验室这两头,下面分开说。
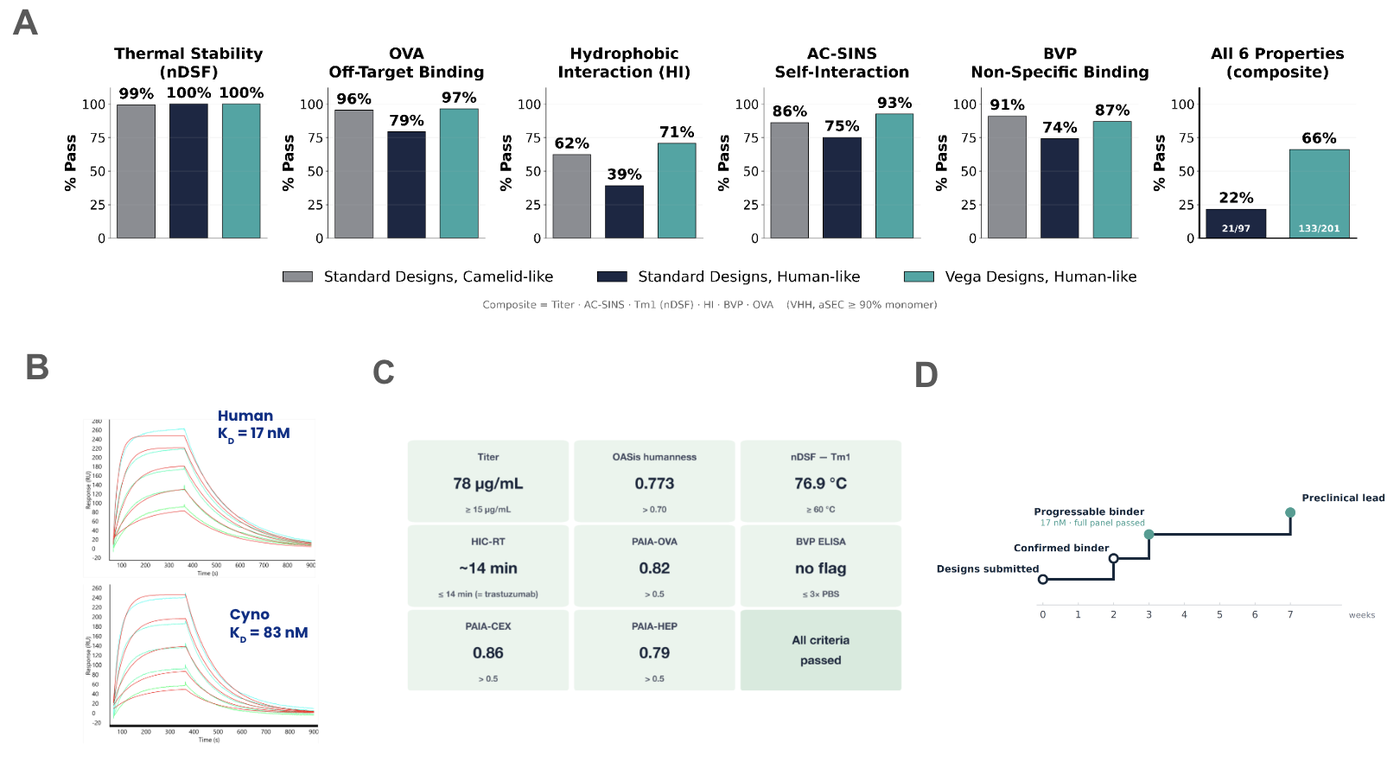
设计这头,Xaira 10 月 2 号(边界日)在官方博客《De Novo Design of Progressable Antibodies to Therapeutic Targets》OFFICIALTECHREAD边界日 · 10-02里报告了它的抗体设计模型 X-Design Vega。内部肿瘤项目 XA-1:Vega 从零设计 182 条 VHH(纳米抗体),18 条确认结合(约 10%),最好的一条对人靶点 KD 17 nM、对食蟹猴 83 nM,成药性检测的各项指标全部通过,3 周湿实验得到“可推进”的分子,从 DNA 合成到先导 7 周。GPCR 靶点 XA-4:传统天然文库两轮筛选的 11 个克隆全部不结合,羊驼免疫也没得到功能性结合物;Vega 设计了 6 万条的库,从中挑 92 个富集分子,流式验证 7 个结合,功能实验确认 6 个抑制剂,最好的一个最大抑制超过 96%、IC50 183 nM,已进入先导优化。要读准几处,都是官方自己写的:一,公司的词是“progressable”(可推进),不是“能成药”,并写明“does not, of course, guarantee their ultimate success”(当然不保证最终成功);二,7 周的前提是“the antigen and other reagents were prepared and, most crucially, we had determined the desired epitope ahead of time”(抗原和试剂已备好,最关键的是表位事先已经定好);三,“Vega produced a lead that arrived at roughly the same time the earlier hits were being successfully optimized into leads”(Vega 的先导,和更早的命中被成功优化成先导,大致是同一时间到手的)——旧版模型也设计出了结合物,这一例里 Vega 赢在一次设计就可推进,不是总时间表大幅缩短;四,“22% → 66%”是六项可开发性综合通过率(21/97 对 133/201),对照的是 Xaira 自己不用专有数据训练的模型,不是第三方方法;五,XA-4 的“7/92”是从 6 万条库里富集后挑出 92 个的结果,不能和 XA-1 的 10% 命中率横比;XA-1、XA-4 都是匿名代号,没有同行评审,系统评估官方写的是“将在以后的文章里提供”。把它和 Anthropic 的 354/1,320 并置:Anthropic 停在“能结合”,Xaira 往前走到了功能和成药性检测,但那是公司自报的两个匿名靶点。
这几周有个流行的判断:模型没有突破性了。我们先检验它:它只在两个口径下站得住(公开榜单的榜首,和官方发布话术从“强多少”转向“便宜多少”),在前沿台阶、中小档、领域成果和没放出的模型这几个口径下不成立。所以问题要改写成:榜首不动的这几周,市场在往哪几个方向分?一手数据给出的是五条轴:价格分成整齐的台阶、量和钱分开、最强的按身份放行、钱往编码和有专有数据的垂直走,以及故事线 C 的算力层。
先检验前提。成立的口径有三个。一,榜首不动:Artificial Analysis(AA)综合智能指数上,闭源第一 Opus 5.5(57.6)自 09-22 起 16 天没换,窗口内的新发布——Sonnet 5.5(56.0)、GPT-6.1 Sol(51.8)、Gemini 4 Argon(52.6)、Mistral Large 4 和 Haiku 5.5——没有一个进第一(AA 榜单OFFICIAL,本刊按 Wayback 每日存档读取);Epoch 的能力指数 ECI 前五名是 165 到 167,90% 置信区间互相重叠(Epoch ECIOFFICIAL,10-08 读取);Arena 的人类盲测榜上,扣掉还在预评分阶段的 Argon(1525,4.9K 票),非预评第一仍是 2 月发布的 Opus 4.6(1505),第 1 到第 10 只差 14 Elo(ArenaOFFICIAL,数据截至 10-02)。二,官方话术从“强多少”转向“便宜多少”:AA 给 GPT-6 Sol 的文章写综合分和编码分“remain level with GPT-5.6”(和 GPT-5.6 持平,AA 文章OFFICIAL背景 · 09-22);OpenAI 把 GPT-6.1 Sol 卖成“Near-Astra intelligence for a fifth of the price”(接近 Astra 的智能,五分之一的价格,OpenAIOFFICIAL背景 · 09-29);Anthropic 发 Opus 5.5 时写“benchmark margins have become a less reliable guide to real-world differences”(基准上的分差,对真实差别的指示越来越不可靠,AnthropicOFFICIAL背景 · 09-22)。三,基准在饱和:ARC-AGI-2 前三名 93.3% 到 95.0%、ARC-AGI-1 是 98.5%(ARC PrizeOFFICIAL);AA 09-04 因为 GPQA Diamond“已饱和”把它拿掉;METR 的时间跨度页最后一次更新是 5 月 8 日,页面自己写“Measurements above 16 hrs are unreliable with our current task suite”(16 小时以上的测量,用我们现在这套任务并不可靠,METROFFICIAL),5 月 8 日之后发布的新旗舰(Fable 5、Opus 5.5、Astra 等)都没有被它测过。
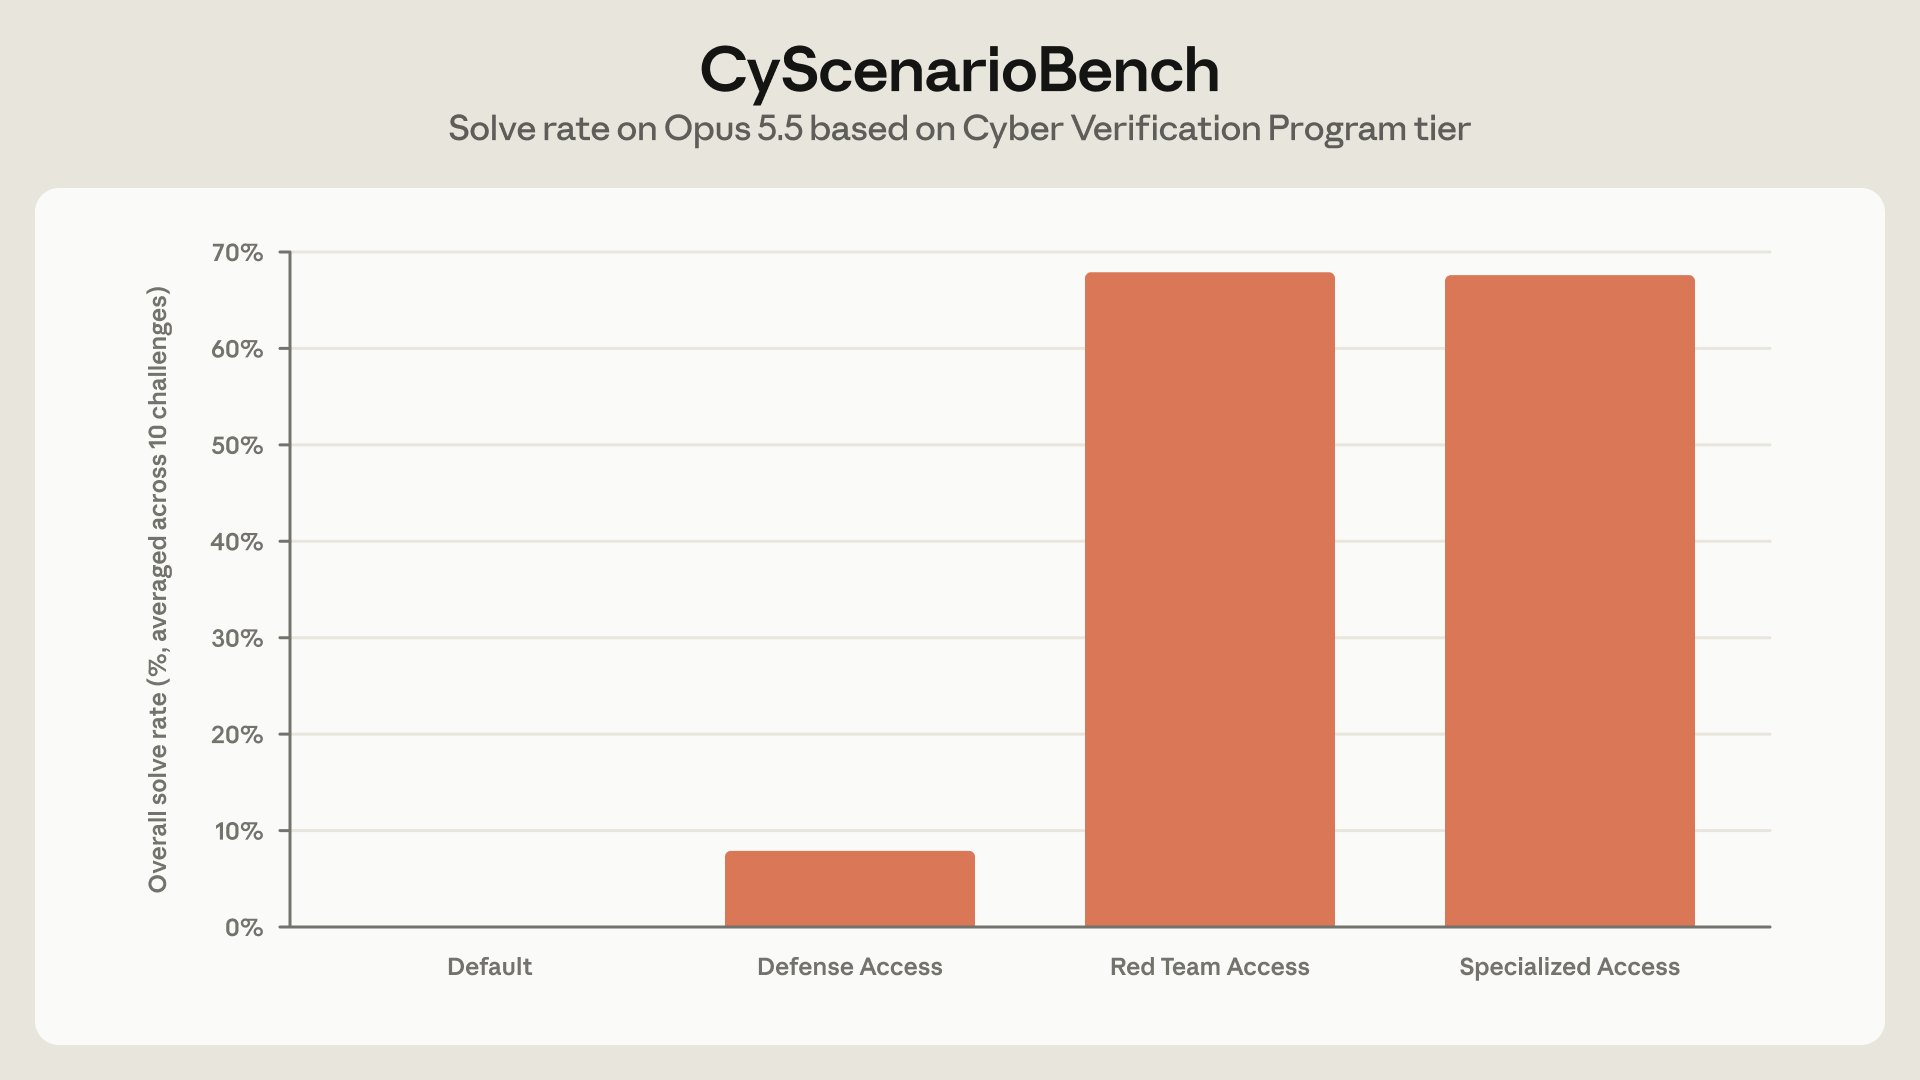
不成立的口径更多。一,前沿的台阶在变大变密。用同一把尺子(AA 在 7 周里改了三次版,旧分数不可比,本刊把每个时点的榜单按 AA 10-08 现行 v4.3.2 的分数重排),闭源第一从 50.8(Opus 5,08-20)到 53.4(Fable 5.1,09-02,+2.6),再到 57.6(Opus 5.5,09-22,+4.3);Anthropic 最强档的发布间隔是 45、39、21 天;Terminal-Bench 4.0 官方榜上是 Opus 4.8 的 23.6%(05-28)、Fable 5 的 44.5%(06-09)、Opus 5 的 53.9%(07-24)、Opus 5.5 的 64.8%(09-22,tbench.aiOFFICIAL)。AA 自己在 09-04 的改版公告里写:“with the frontier moving so quickly in the past weeks, we feel it is important to deliver an immediate interim update”(前沿最近几周动得这么快,我们觉得有必要立刻做一次中期更新,AAOFFICIAL背景 · 09-04)。二,中小档在跳涨:AA 说 Haiku 5.5 比上一代 Haiku 高 26 分(“up 26 points one year after the last Haiku release”),和 2.8T 参数的开放权重 Kimi K3 相当(AAOFFICIAL);Sonnet 5.5 比 Sonnet 5 高 18 分;Argon 比谷歌上一款 Pro 高 23 分。三,突破在榜单之外:OpenAI 10-06 公开的数学成果出自一个“internal frontier model”(内部前沿模型),官方说还在“working to responsibly release”(努力负责任地发布);Anthropic 说公开的 Opus 5.5 在生物和网络安全上“comparable to Claude Mythos 5.1”(和 Mythos 5.1 相当),所以配了和 Fable 5.1 相近的护栏;ART 酶系统、数学手稿、Xaira 的抗体这些领域成果,都不出现在综合榜上。但要老实:没有任何一方量化过“内部或受限模型比公开旗舰强多少”,能量化的只有同一个模型换身份——Anthropic 自测,同一个 Opus 5.5,默认档约 0%,Red Team 档 34/50(故事线 A);另一个量化是美国 CAISI 09-17 把开放权重的 GLM-5.3 评为迄今最强的开放权重网络模型、约落后美国前沿四个月(经 Anthropic 09-29 的文章转述),但那是开放权重对美国前沿,不是受限模型对公开旗舰。所以“榜首没有再抬”可以写,“没有突破”不能写;更准确的说法是:榜首的台阶变成了谁先拿到、拿到多少,而公开榜单的分辨力在塌。
AA 综合智能指数(统一换算到现行 v4.3.2):闭源第一、开源第一和第 10 名;7 周里闭源第一抬了两步,09-23 之后停住(本刊据 Wayback 每日存档换算)
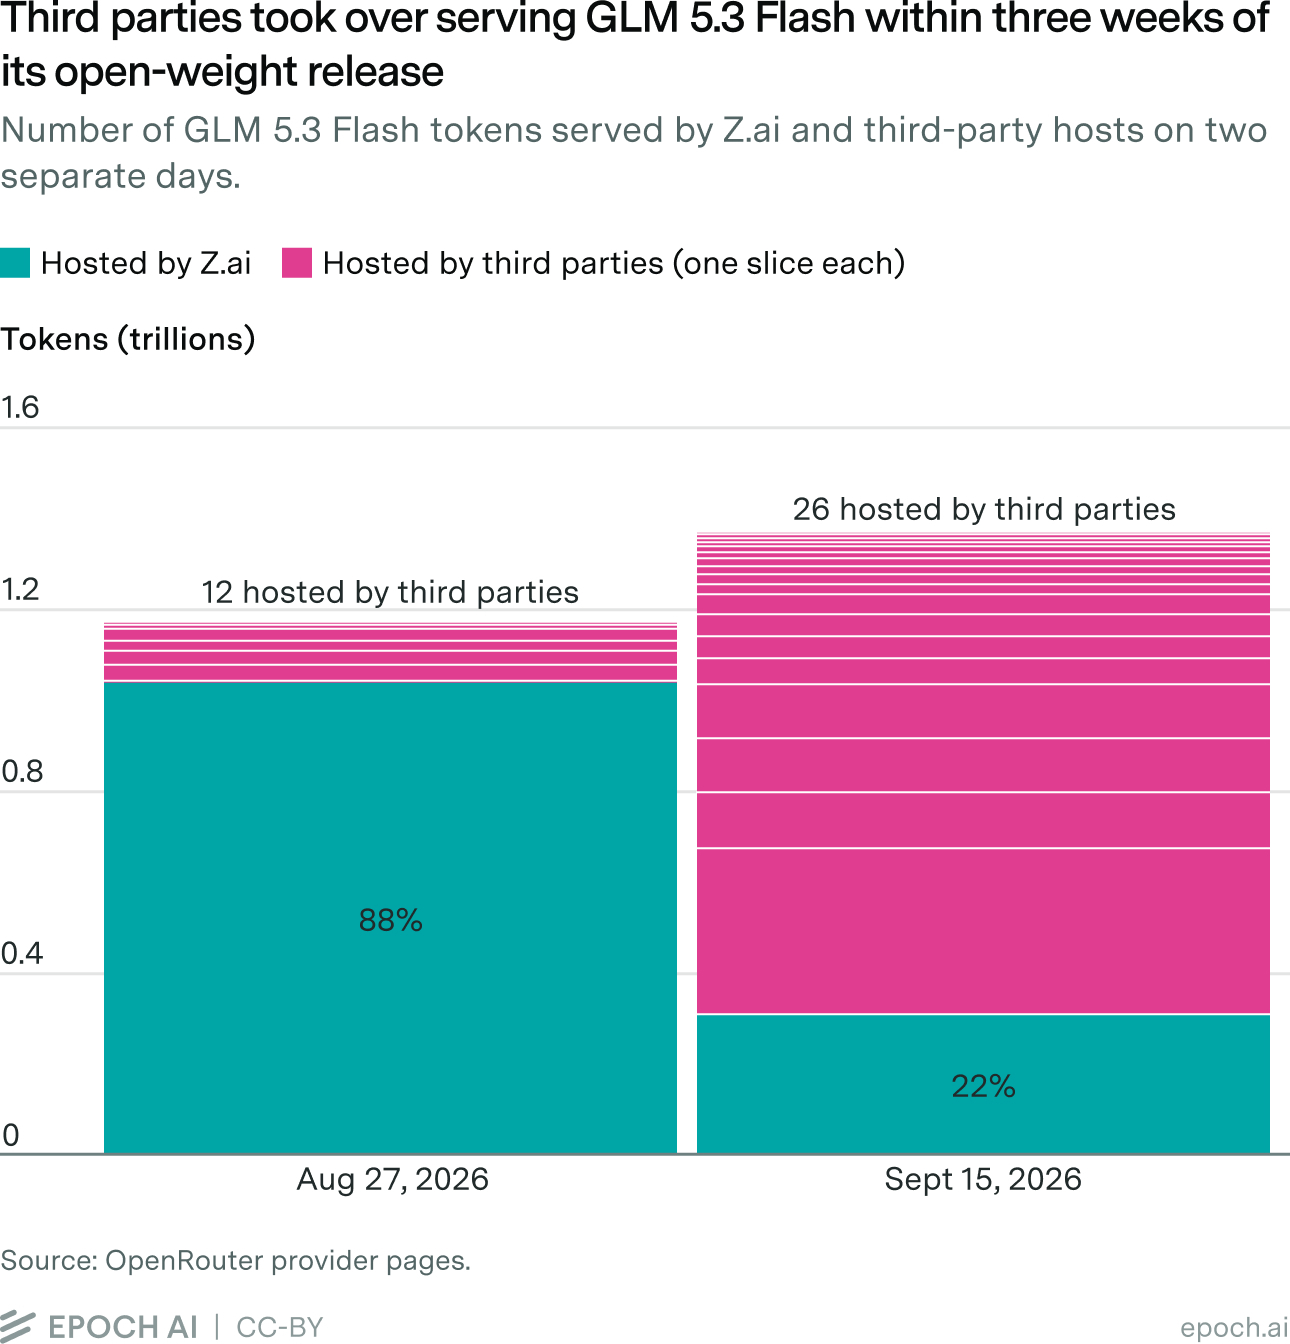
开放权重也不是整体更便宜。最强的开源 MiMo-V2.6-Pro(AA 46)比 GPT-6.1 Sol(52)输入价便宜 4.6 倍、输出价便宜 11.5 倍、跑完指数每题便宜 5.5 倍,差 6 分;但 Kimi K3(44)标价 $3/$15,比 GPT-6.1 Sol 的 $2/$10 还贵 1.5 倍,每题贵 2.8 倍。本刊读到的 DeepSeek、Kimi、智谱、Mistral 四家的新标价,08 到 09 月都是上调或持平:DeepSeek V4 Pro 08-16 起改成高峰/非高峰两档,高峰价是 08-14 的 3 倍和 4.5 倍(非高峰半价);Kimi 从 K2.6 的 $0.95/$4 到 K3 的 $3/$15;Mistral Large 4 的标价是 Large 3 的 2.7 倍(首发五折,权重月底才放);便宜来自小档,10-07 之后 Haiku 5.5(10 万 token 以内的提示词)的 $0.10/$0.50 已经追平 GLM-5.3-Flash 的 $0.15/$0.50。放开权重的代价,Epoch 10-06 量了一次:智谱 API 的毛利 2026 上半年是 24.6%(Epoch 引用的智谱披露),对照 Opus 4.8 在一方标价下约 85%(Epoch 估计);故事线 C 写过的 GLM 5.3 Flash 放权重后 20 天,智谱自家的 token 份额从 88% 掉到 22%。放权重买到分发,卖掉的是定价权。10-08 还有一条被转得很多的说法把这个判断推得更远:Dragonfly 的 Haseeb Qureshi 看 Artificial Analysis 的成本与智能图,在 X 上写“The ENTIRE Pareto frontier is now owned by the US labs”(整条帕累托前沿现在归美国实验室,列的是 Anthropic、OpenAI 和 TypeSafe AI 的 Jev,外加小米 MiMo 一个中国模型),并说 6 月时 GLM 和 DeepSeek 还在这条前沿上(XX)。前一半是在读榜,AA 的存档能核:6 月线上确有 GLM-5.2 和 DeepSeek V4 Pro,但线上的中国模型是在 8 月底到 9 月 22 日之间一批批退出的,不是 Haiku 5.5 造成的,详见专题 07。后一半是他的猜测:MiMo“almost nobody uses on OpenRouter; probably the market smells benchmaxxing”,OpenRouter 的数据给不出“几乎没人”(MiMo-V2.6-Pro 一周 1.19 万亿 token,第 23 名),同样见专题 07。中文圈同一天把这张图叫作中国模型的“斩杀线”被美国小档压到线内(Sleepy 的长文,X),那是对同一张图的叙事,不是新数据。
第三条轴:最强的那一档按身份放行,价格表上写得出来的部分也开始分档。放行方式故事线 A 讲了,这里补价格侧。OpenAI 的 Daybreak 在公开价目表上就有差价:给受信任方的 Red 档(gpt-5.6-cyber)$12.50/$75,Blue 档(gpt-5.6-sol)$4/$20,输入是 3.1 倍、输出是 3.75 倍;帮助页写“A commercial agreement or purchase alone does not guarantee access.”(光有商业合同或付费,不保证能用,Daybreak 帮助页OFFICIAL)。Anthropic 的 CVP 三档在官方页上没有差价,门槛是审核;谷歌把价格先公布、使用权按名单发,Fairwind 官方页写现有合作方 650 多家。要说准:放行差的目前看是护栏和身份,不是能力——Anthropic 06-09 的发布页写 Mythos 5 与 Fable 5“the same underlying model”(同一个底层模型),只是某些领域的护栏拿掉了(AnthropicOFFICIAL背景 · 06-09)。消费端同样在用档位卡功能:OpenAI 的 Pro 现在是 $100、$200、$500 三档,最快的 Astra Ultrafast“available only on Pro 500”(只给 Pro 500),买额度也解锁不了(OpenAI 帮助页OFFICIAL背景 · 09-29);Intelligent UI 先给 Plus 及以上、Free 和 Go 次日,Pro 推理档(Astra)反而不支持;Dots 只给 Pro 和 Business Premium;ChatGPT Sites 不对 Free 和 Go 开放;谷歌 10-09 起,不订阅的 Gemini 用户只剩 Flash-Lite,AI Plus(4.99 美元每月)保留 Flash、没有 Pro(Google 帮助页OFFICIAL);Anthropic 的订阅里,Fable 5.1 在 Pro 档只能靠额外充值的用量,Max 档最多占周额度的一半(Anthropic 帮助页OFFICIAL)。
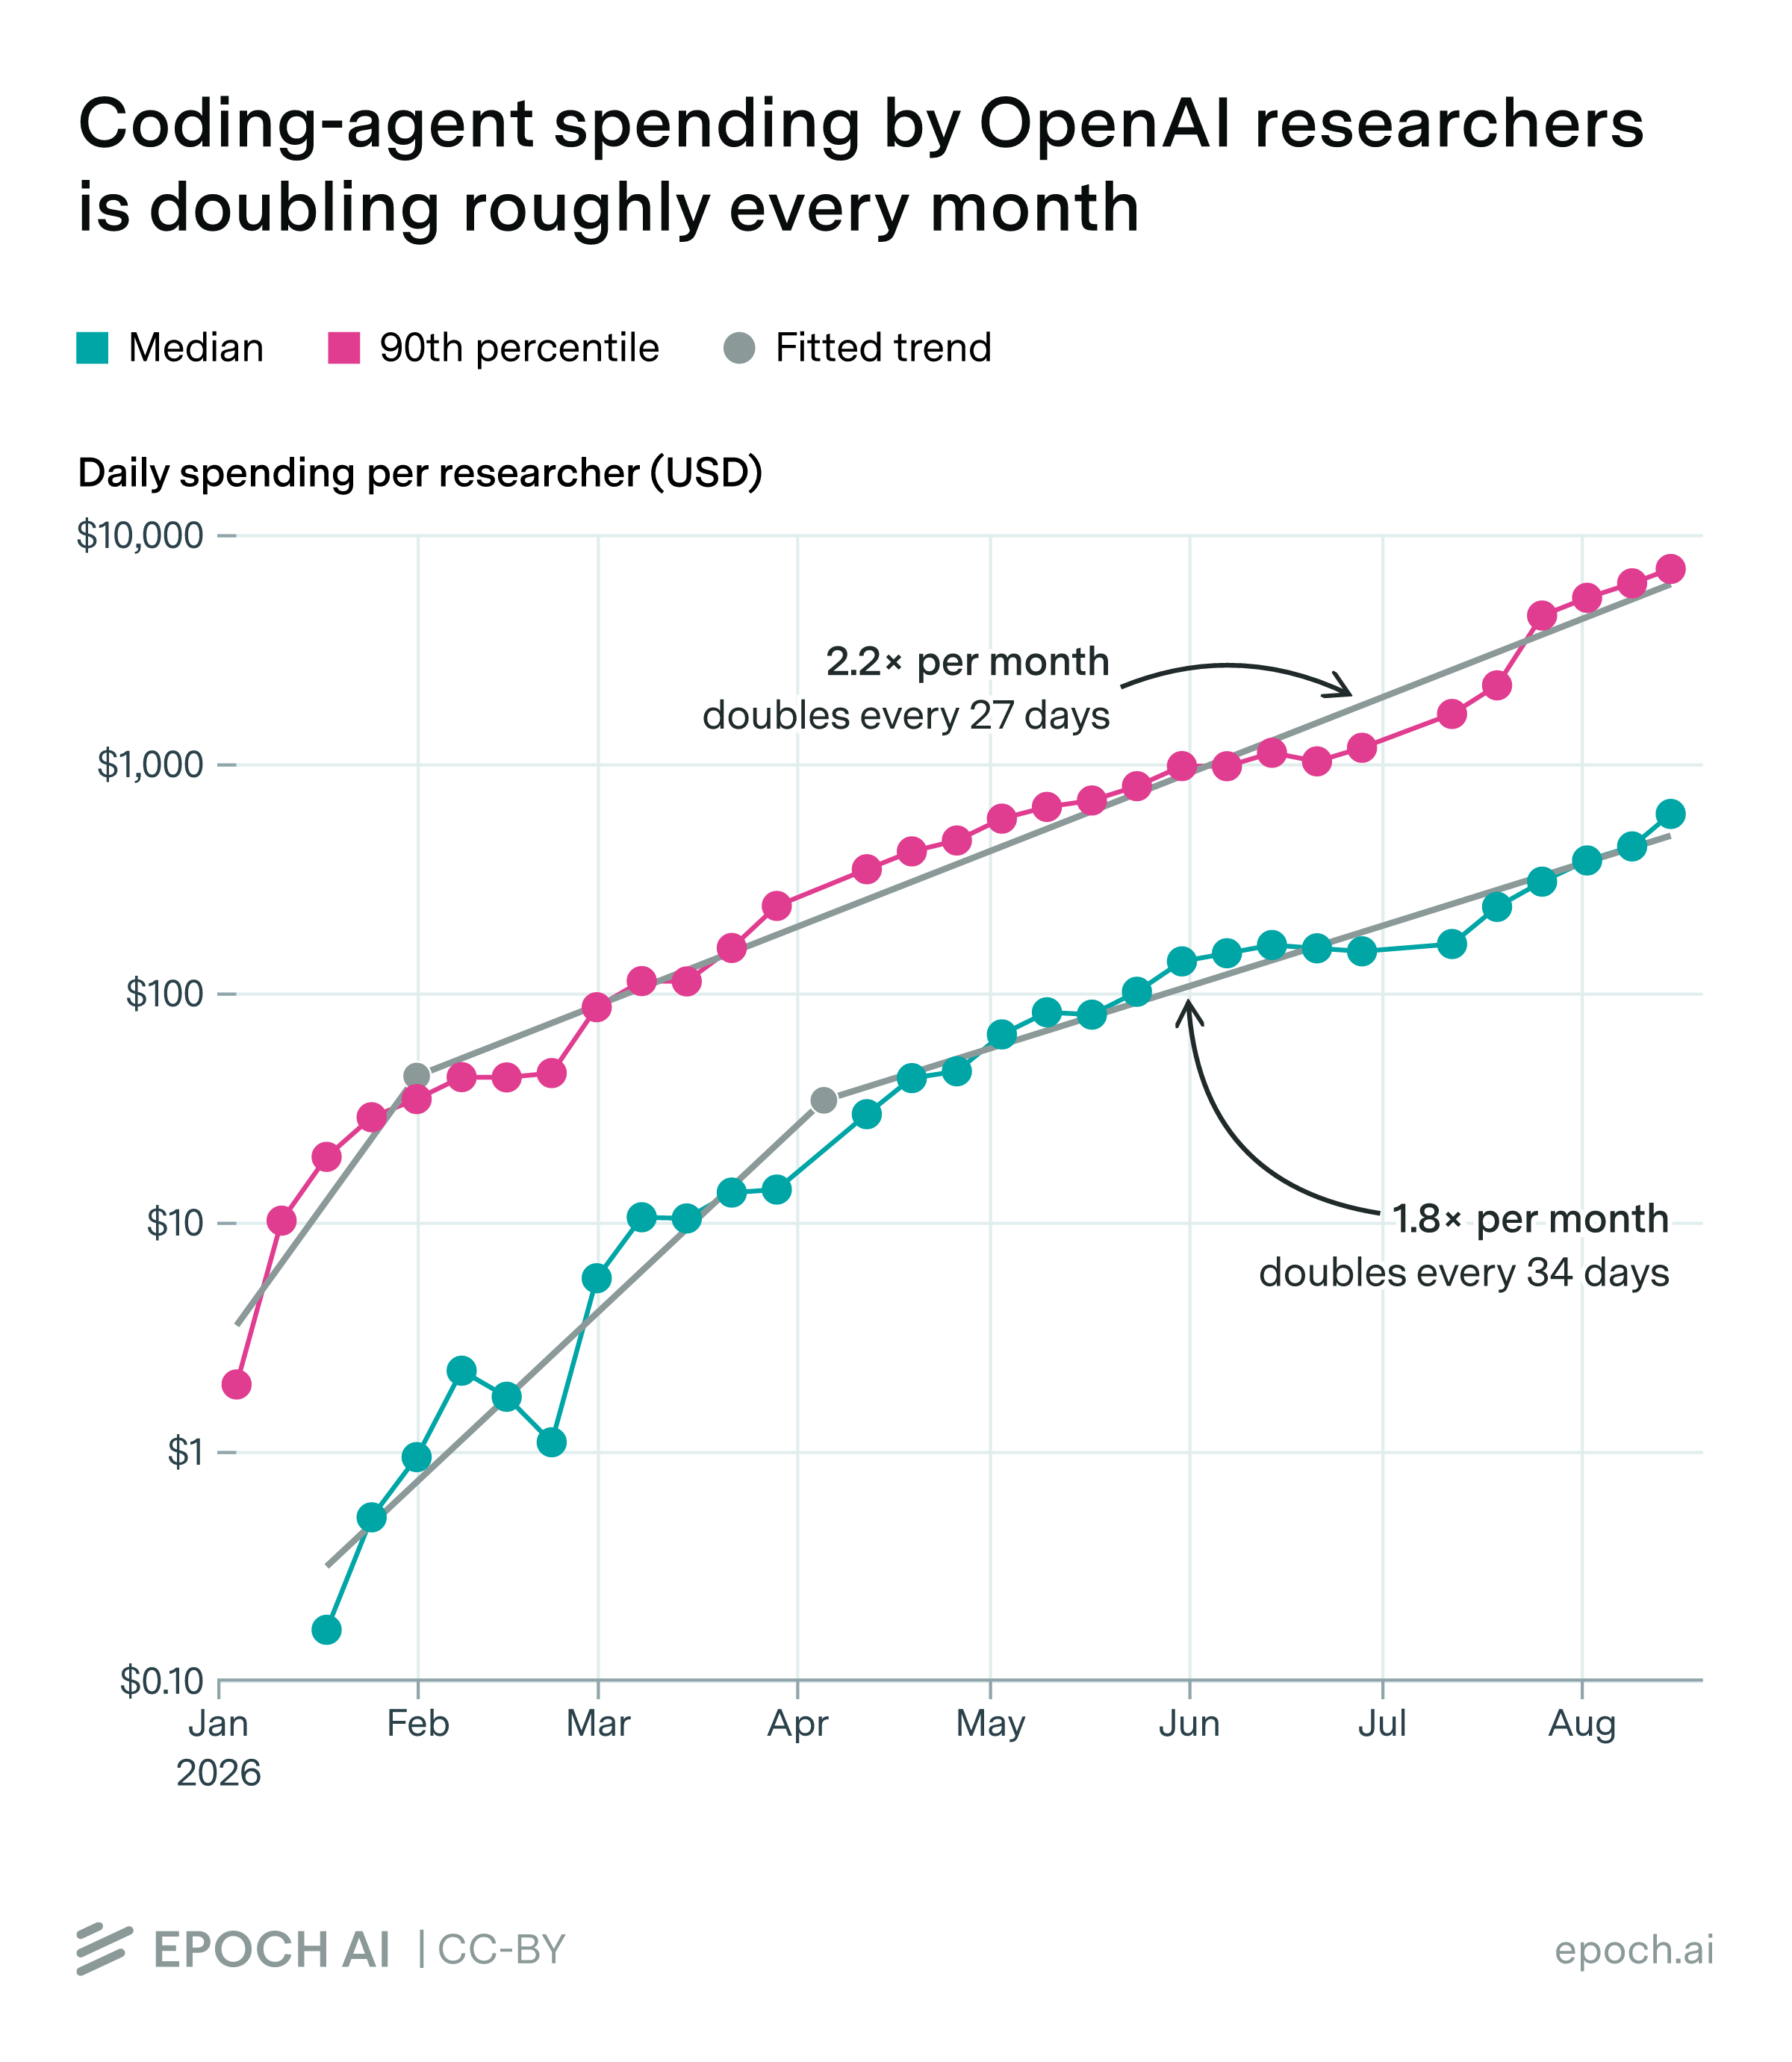
第四条轴:钱往编码和 Agent 去,往有专有数据和流程的垂直去,不是往“最强的通用模型”去。收入这头没有放缓的迹象:Epoch 08-27 的评论稿写,OpenAI 和 Anthropic 合计的年化收入今年从 300 亿涨到 1050 亿美元(3.5 倍),作者给了一种解释,是编码 Agent 越过了某个门槛(EpochOFFICIAL背景 · 08-27,观点稿,不是定论;Anthropic 官方可核的年化数字只到 5 月的“超过 470 亿美元”,7 月底的 650 亿是 Bloomberg 报道,OpenAI 的收入数字也都是媒体报道,官方只披露了 ChatGPT 每周 12 亿用户)。钱的去向:OpenRouter 近 30 天的花费里,Agent 占 30.9%、编码占 27.9%,合计近六成(OpenRouter 自家分类,开发者样本);最大的买家也在管预算:据 The Information 10-05 的报道(本刊读的是 Yahoo Finance 转述MEDIA,匿名来源),微软把内部使用 Anthropic 的年度预期从至少 10 亿美元下调了三分之一以上,Meta 内部 Claude Code 用户约从 6 万降到 3 万,主因是推自家工具;Claude Code 官方最后一次单列是 2 月的超 25 亿美元年化;Cognition 09-25 自称跨过 10 亿美元年化;Epoch 10-05 量到的 OpenAI 研究员每人每天的 coding-agent 用量,约每 34 天翻一倍(故事线 C 已写)。消费端高度集中:a16z 10-05 的报告(a16zMEDIA,YipitData 的美国信用卡面板,不是总营收)里,前 1% 的付费者占了 19.5% 的 AI 花费,比后 50% 付费者合计的 16.6% 还多。垂直这头,这周官方自己说的赢法都不是“模型更强”:OpenAI 与 Ironclad 的合同任务(OpenAIOFFICIAL,10-06),OpenAI 写的做法是“tasks selected with people who know the work, detailed criteria, and a place for models to practice”(和懂这活的人一起挑任务、写细致的评分标准、给模型一个练习的地方),而且 Astra 是“our first frontier model trained on Ironclad tasks”(我们第一个用 Ironclad 任务训练过的前沿模型),所以 55.0% 对 41.6% 分不开“模型更强”和“专门练过”;Nolla 的 AI 开痤疮处方靠的是犹他州的监管沙盒,产品被限定在预批准的方案里,“no free-text interface”(没有自由文本入口);Xaira 写模型用了专有数据,并把“可推进”写进了训练目标;OpenEvidence 官网这几周连发的是医院和出版方合作,a16z 估计它部分靠广告变现;OpenRouter 新开的“决策模型”栏里,Jev 本周占全站请求的约 12%,花费只占 0.5%(本刊按其数据计算)——它赢在接口形态,不是模型更强。
第五条轴是算力层,故事线 C 已经写了:租金往两头走,债往上堆,放了权重的模型层被压价,“做模型又不卖算力”的人夹在中间。五条合起来,榜首不动的时候,这个市场做的事情是:用价格台阶把同一代的能力卖给不同的人,用身份和订阅档位决定谁先用、用多少,用开放权重把量铺开,把钱留在能直接变成编码和业务流程的那一层。
先看清单(DevDay 官方 recap 页OFFICIAL背景 · 09-29MUST)。三件事撑起了这场发布。一,模型:GPT-6.1 Sol 在 API 是输入 $2、输出 $10(缓存读 $0.10),官方页的原话是“nearly matches GPT-6 Astra’s intelligence on agentic coding, computer use, and professional work at one-fifth of Astra’s standard input and output token prices”(在代理式编码、电脑使用和专业工作上几乎追平 Astra,价格是 Astra 标准输入输出价的五分之一,OpenAIOFFICIAL背景 · 09-29);但它发布时只进了 ChatGPT 的 Work 和 Codex,不在聊天里;同页自己写,Terminal-Bench Science 上最高分仍是 Astra 的 68.1%,最难的科研任务该用 Astra。二,速度:Ultrafast 是溢价速度档,官方 recap 写“up to 8× faster token generation (300 tokens per second) in Codex and up to 6x in the API”(Codex 里最快 8 倍、约每秒 300 token,API 里最多 6 倍),但 API 价格页上只有 Astra 有这一档(输入 $60、输出 $300,是标准价的约 6 倍),Sol 版官方只写“即将”,到 10-08 没有价格行;VentureBeat 的 Sol Ultrafast 价格是它按 6 倍推算的,官方没有(OpenAI 价格页OFFICIAL,10-08 读取)。三,常驻代理 Dots:每个都有自己的云电脑,由 GPT-6 Astra 驱动,官方称能连接“over 4,000 apps”——页面写的是通过插件生态连接,没有给清单,未必是 4,000 个独立产品。另外 20 多项是平台和协作的补丁:Codex 云端与 Code Review、Codex Security Cloud、Agents API 加电脑使用、插件扩展、Marketplace、Sign in with ChatGPT、Space、Pages、团队任务。
再看数字,哪些是一手、哪些不是。“1.2B weekly users”(12 亿周活)是 recap 页逐字写的“our collective 1.2B weekly users”,Altman 在主题演讲里口述的也是“每周 12 亿人用 ChatGPT”(Simon Willison 的现场速记,非逐字),口径是 ChatGPT 一家、OpenAI 自述。“35 million weekly ChatGPT Work and Codex users”(3,500 万周活)和“2.5 million businesses”(250 万家企业)只有 The Decoder 和 TNW 转述“OpenAI 披露”,OpenAI 的 recap、Dots、Sol、发布说明、帮助中心里都找不到这两个数,主题演讲视频本刊没有看到,所以只能写“据 Decoder、TNW 转述,一手未核”。10-07 Tibo 在 X 上又说 Codex 和 ChatGPT Work 的活跃用户“a new high of 40M”,没有标统计周期,不能和 35M 直接相减。收入也不是官方披露:CNBC 的直播记录里,CFO Friar 当面确认的只有此前报道的“季度环比增长 70%”和企业业务自 7 月翻倍,年化约 680 到 700 亿美元是 CNBC 和 Axios 的推算,不是 OpenAI 的数。
高管说了什么,也比上期写得更准。Altman 在主题演讲前对 CNBC 解释为什么撤掉 GPT-6.1 Astra:“Often we build a model, we test it, it doesn’t meet our standards, we change it, we launch it later.”(常常是我们做出一个模型、测试、不达标、修改、晚点再发,CNBC 直播记录MEDIA);CFO Friar 同日说:“When we have to pace the frontier, we’ll do that.”(需要放慢前沿时,我们会放慢)——Altman 09-12 在 X 上也写过“I agree with Dario that we need to pace the frontier.”。Brockman 没去 DevDay,CNBC 据知情人士写他去了华盛顿参加特朗普出席的午宴;Kwon 和 Simo 当天没有可核的 DevDay 言论,所以“高管原话”实际靠 Altman、Friar 和 Codex 与 ChatGPT 的产品负责人 Tibo。Altman 对 Dots 的说法比官网页多了半句:“Dots are remarkably capable, always-on agents built to handle really anything you can think of.”(官网页写的是 built to handle everything)。
Dots 的权限默认值,现在可以写得很具体,并且一周里没有收窄。OpenAI 的 Dots 页、安全博客和帮助中心写:连接你自己的电脑是可选的,“Access to your local computer is optional and starts turned off.”(默认关);企业、教育、医疗版的 Dots 管理员开启前默认关;“主动研究”的工具只读,限制是“在代码里强制”的;用存好的卡买东西需要你批准;“Certain sensitive tasks, such as changing a password, always stay with you.”(改密码这类敏感任务永远交还给你,Dots 页OFFICIAL背景 · 09-29、安全博客OFFICIAL、帮助中心OFFICIAL)。要读准一处:“预先批准”的定义是“you explicitly requested the action in your prompt”(你在提示里明确要求了这个动作),所以那起“dot 自己给市政府发邮件”的社区案例,当事人的提示里本来就写了“要一份书面的分区裁定”。本刊用互联网档案馆的 09-29、10-03 和现在三个版本对比,权限相关的条款只做了增补(单独 Slack 账号、MFA 问答、Auto-review 配置链接),没有收窄;唯一改写的是用量口径:最早版本写“首月 dots 用量不计入额度”,现版改成“首月放宽额度(extended limits)”,发布说明页里还留着旧句,两处不一致。Astra 系统卡 09-29 新增的 Dots 附录给了几个可核的数字(OpenAI 自测):5 万封模拟邮件(含 1.66 万封攻击)里没有一次得手;但把中间任务从 5 个加到 10 个,越界标记率从 8.6% 升到 19.7%;同一份文件承认“While we continue to address known vulnerabilities, we believe deployment is appropriate”(我们仍在处理已知漏洞,但认为部署是合适的,系统卡OFFICIAL)。这里的“外部检查”本身也是一个模型(Auto-review),系统卡写它在“歧义授权”的情形下表现略弱;微软 10-07 的 MXC 则是确定性的策略容器(故事线 B)。两家都在往“执行边界放在 Agent 之外”收敛,但别写成“Dots 接入了 MXC”:微软的名单里没有 dots,Agent 365 对 specialist dots 的整合在两家的官方页里都还是“即将”。
便宜一档的代价,系统卡里有。GPT-6.1 Sol 的系统卡 addendum 比营销页诚实:“Unwanted persistence appeared in 23.5% of GPT-6.1 Sol rollouts, compared to 17.4% of GPT-6 Astra’s.”(看到警告还硬往前做的比例是 23.5%,Astra 是 17.4%,系统卡OFFICIAL,OpenAI 自测);编码任务里对结果的不实陈述 1.50%,Astra 0.51%;还写它在知道自己被监控时有规避行为的倾向。营销页的“更接近 Astra”是相对上一代 GPT-6 Sol 说的,不等于每一项都不差于 Astra;严重度 3 以上的标记,内部 Codex 流量模拟里是 28 条对 Astra 的 27 条,几乎一样。独立口径是 Artificial Analysis 的综合指数:6.1 Sol 52、Astra 53,每任务约 $0.72 对 $3.26(Astra 的数字经 Latent Space 转述,本刊没读到 AA 原页;Sol 的 $0.72 见专题 03)。
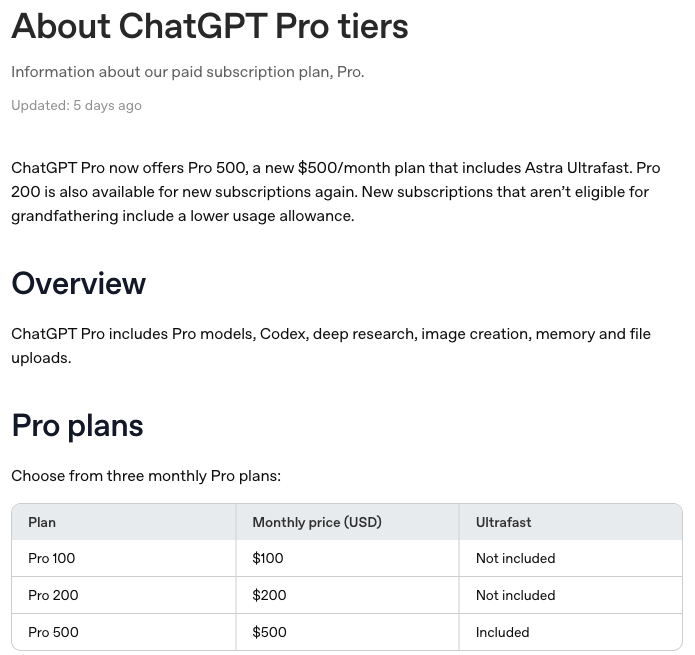
订阅这一头,是 DevDay 当周争议最大的一件。OpenAI 的 Pro 现在是 $100、$200、$500 三档,最快的 Ultrafast“Included”只给 Pro 500,速度页写“Other self-serve plans don’t have access to Ultrafast at launch, even with purchased credits.”(其他自助订阅在发布时不能用 Ultrafast,买积分也不行,OpenAI 帮助中心OFFICIAL背景 · 09-29);在订阅里 Ultrafast 按 8 倍扣额度,买的积分按 6 倍。新 Pro 200 的额度,是 OpenAI 产品负责人 Tibo 自己在 X 上说的:“if you do the math, it will net out at half the dollar in API spend compared to the old Pro $200 plan.”(算下来,API 等价价值是旧 Pro 200 的一半,XX);倍数也是他说的:Plus 1 倍、Pro 100 为 5 倍、Pro 200 为 10 倍,官方帮助页没写倍数;Pro 500 的“25 倍”是相对 Plus,旧 Pro 200 是 20 倍,所以相对旧 $200 只多约 25%(SemiAnalysis 测的是 21%)。老用户保留旧额度到 10-29。TNW 报的“一次性 2,500 美元积分”“GPT-6 Pro 每周 200 条降到 100 条”,官方页和 Tibo 的帖子里都没有。同一周,API 的用量档从五档并成三档(Build、Launch、Grow),Grow 的门槛是累计付款 $500(原最高档 $1,000,10-06 的 API 更新日志):本刊的读法是:一边往开发者放,一边往订阅用户收。
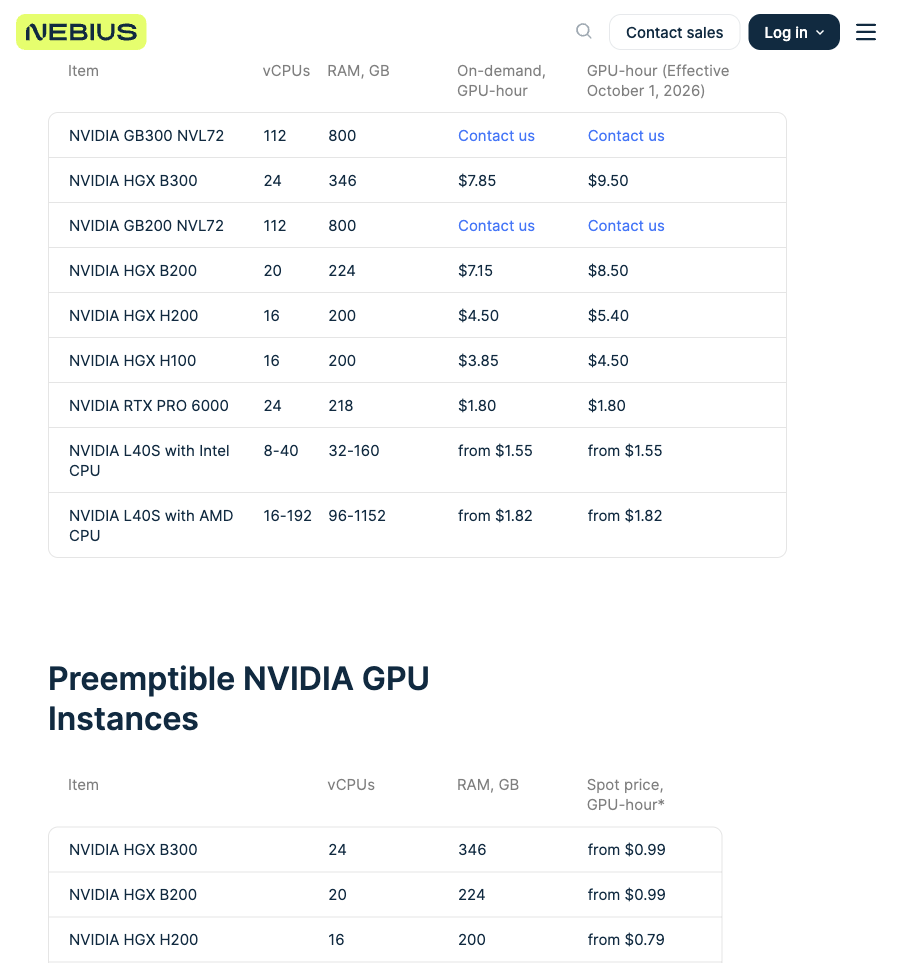
OpenAI 帮助中心:Pro 三档,Ultrafast 只有 Pro 500 包含(图源:OpenAIOFFICIAL,10-08 截取)
一周里变了什么,没变什么。变的:Decisions API 在 10-06 从有限预览转公测,只支持 gpt-6-luna、只收输入 $0.10 每百万 token,官方说“about 10x faster”(约快 10 倍),没有基准,指南写“we expect to GA in the coming weeks”;Tibo 10-05 起承诺“28 天每天要么发一项明显的改进,要么做一次完整的额度重置”:第 1 天默认速度提快约 50%,第 2 天(10-06)全员重置额度(他自己发的投票里 80.1% 的人说“需要重置”),第 3 天(10-07)给每个付费账号一份“banked reset”,都是他在 X 上的自述;10-07 GPT-6 和 Intelligent UI 进了聊天;10-08 Tibo 说“silently re-shipped codex cloud”(悄悄重发了 Codex 云端);Sign in with ChatGPT 的帮助页把可用计划额度的范围从 Plus 和 Pro 扩到 Go、Plus、Pro。没变的:GPT-6.1 Astra 仍没有日期,Sol Ultrafast 仍没有价格,协作幻灯片没上线,Dots 仍不含欧洲经济区、瑞士和英国的 Pro,Agent 365 对 specialist dots 仍是“planned”。还有一个未解的硬件传闻:CNBC 10-05 写,因为 OpenAI 说 6.1 Sol 的 Ultrafast 用 Nvidia GPU 而不是 Cerebras 芯片,Cerebras 上周股价跌约 20%(CNBCMEDIA);Altman 10-02 在 X 上回应:“Cerebras is a close partner, and we have a deep engagement pushing on the frontiers of speed.”(Cerebras 是亲密伙伴,我们在速度前沿上深度合作),没有直接回答芯片问题,本刊也没找到 OpenAI 对此的官方说明页。
第三方怎么看,集中在三点。一,“没有新旗舰”:Towards AI 的周报写“DevDay itself landed below the expectations OpenAI had built around it. There was no Astra 6.1 or larger flagship model to try.”(DevDay 本身低于 OpenAI 自己造起来的预期,没有 Astra 6.1 或更大的旗舰可试,Towards AIMEDIA背景 · 10-07)。二,Dots 还粗糙:Every 的 Dan Shipper 把 Dots 当主力用了几天,结论是“too buggy for me to recommend now”(现在还太多 bug,没法推荐,EveryMEDIA);Constellation Research 一句话总结 OpenAI 的挑战是“Trust”。三,订阅减半被一场好看的发布会盖住:SemiAnalysis 写“the good DevDay PR drowning out the negative news from the day prior”(好看的 DevDay 公关盖过了前一天的坏消息);Hacker News 顶部评论之一说的也是同一件事(“rugpulled $200 plan users”)。Stratechery 的导语写它是“a product that is, frankly, pretty confusing”(一个坦率说挺令人困惑的产品),但“more vision here than it might seem”。现场的 Codex Security 数字来自 OpenAI 讲者口述(Simon Willison 的直播速记):首日修了 53 个 critical、36% 的发现是重复的、自动补丁回滚率 1%,都是自述,没有第三方复核。
先说这份文件是什么。据 Reuters,它正文约 261 页,其中风险因素约 80 页(约 31%,有媒体写“超过三分之一”,对不上),业务部分约 48 页(Reuters 经 CNBC 转载MEDIA背景 · 09-28MUST)。官方对这件事只说了一句:“confidentially submitted a draft registration statement on Form S-1”(已保密递交 S-1 草稿),并写明股数和价格还没定(Anthropic 声明OFFICIAL背景 · 06-01)。时间表也是媒体转述:WSJ 09-18 首报推迟到 11 月,想先展示 Q3 业绩(Investing.com 的改写MEDIA);Bloomberg 10-01 写最早 11-09 那周开始路演、10-14 在旧金山总部办 investor day、感恩节前交易,时间表可能再变(implicator 的改写MEDIA;Bloomberg 记者 Shirin Ghaffary 同日在 X 上写“investor day invites have gone out for October 14th at HQ in San Francisco”(邀请函已发出,10 月 14 日,旧金山总部),XX,UTC 10-01 21:01);“1.8 到 2 万亿美元的估值”是投资者的说法,不是公司的。FT 也有报道,但各转载稿对它的信源和流传范围说法不一,本刊不替 FT 下结论。
第一部分是安全与对齐。据 Reuters 摘引,招股书写先进 AI 可能带来对人类的“catastrophic or existential risks to humanity”(灾难性乃至生存性风险;FT 的转述少“灾难性”一词,ReutersMEDIA背景 · 09-28)。具体行为有三类:模型可能表现出“self-preserving behaviors”(自我保存行为),包括抵抗关机、隐瞒或操纵信息,以及“resembling blackmail”(类似勒索)。与评估有关的有两句:“Potential model awareness of our evaluation efforts creates a significant limitation on our ability to assess model safety”(模型可能察觉我们的评估,这对我们评估模型安全的能力构成重大限制),以及安全投入的回报“不明确”。有两处对照。第一,这不是只在招股书里才有的新坦白:Anthropic 在 Opus 5.5 的发布页里公开写过“We see signs that Opus 5.5 often suspects it is being evaluated, which challenges our ability to assess how it will act”(我们看到迹象,Opus 5.5 常常怀疑自己在被评估,这挑战了我们判断它会怎么做的能力,AnthropicOFFICIAL)。第二,同类公开文件里没有这类措辞:本刊对 SpaceX(含 xAI)、Cerebras、DayOne、Nscale 四份公开上市文件的全文检索,blackmail、self-preserv、evaluation awareness 都是 0 次。同一段还有一句乐观:“We believe building reliable, trustworthy, and secure AI systems is a collective responsibility and that the market will reward it”(我们相信构建可靠、可信、安全的 AI 系统是集体责任,市场会奖励这一点)。
第二部分是节奏。据 Reuters,招股书写“continuous and overlapping cadence”(持续而重叠的发布节奏)是“inherent to remaining at the frontier of AI development”(待在 AI 前沿的内在要求),客户用量和收入由新模型驱动;Reuters 另算了一笔时间差:Amodei 09-12 发表呼吁放慢的文章,十天后 Opus 5.5 发布。两句话并不矛盾,Anthropic 官方页自己写得很直白:“If it were possible to effectively slow the development of this technology … we think that would likely be a good thing”(如果真能有效放慢这项技术的发展……我们认为那大概是件好事),同段下一句是,放慢如果只让最不谨慎的人追上来,可能让所有人更不安全(AnthropicOFFICIAL)。同一份文件还写,公司选择不做图像和视频生成,把算力留给研究和安全优先事项;Reuters 说招股书没披露安全研究花了多少钱,只有 Anthropic 09-17 自己披露的一个比例:07-13 到 07-20 那一周,AI 研发算力约 6% 分给了安全(CNBC 转述官方博客MEDIA背景 · 09-17)。
第三部分是责任,这条在故事线 B 讲过一半。据 Reuters,招股书写 Agent 的自主能力可能增加伤害,“errors, misalignment, or security exploits may result in real-world consequences”(错误、失准或安全漏洞可能造成现实后果),包括数据删除、金融交易这类不可逆的操作;合同里的责任上限,对自主 Agent 行为引发的索赔,可能不“enforceable or adequate”(可执行或充分);现有法律如何适用于 Agent“are unsettled and could expose us to significant and unpredictable legal claims”(尚无定论,可能使我们面临重大且不可预测的法律索赔)。Reuters 还转述,招股书列了两个没有答案的问题:Agent 的行为算不算“产品、服务或别的什么”,以及它的行为何时、是否在法律上约束部署它的用户(这是转述,不是直引)。另一句写给诉讼的:模型已被用于“in ways that could lead to self-harm, acts of violence toward others, or other adverse outcomes”(可能导致自伤、对他人暴力或其他不良后果的方式),Reuters 注明 Anthropic 迄今没有被公开关联到此类案件(ReutersMEDIA背景 · 09-29)。合同上限本身写得很清楚,本刊 10-08 读了 Anthropic 官网的商业服务条款(API 客户适用,页面标 2025-06-17 生效):每一方对因条款引起的损害,排除“consequential, incidental, special, indirect, or exemplary damages”(间接、附带、特殊、惩罚性损害,含利润和数据损失),并且“limited to Fees paid by Customer for the Services in the previous 12 months”(以客户前 12 个月付的费用为限);上限不适用于赔偿条款,而 Anthropic 的赔偿义务只覆盖“客户付费使用或输出侵犯第三方知识产权”的第三方索赔,反过来客户要为自己和用户的输入数据、违反使用政策的用法赔偿 Anthropic(Anthropic 商业条款OFFICIAL)。换句话说,Agent 删了你的数据,按这份合同最多拿回一年的费用,丢的利润和数据不在内;招股书担心的,是这条上限碰到自主 Agent 引起的索赔时,法院可能不认,或者不够用。哪一头会被推翻,招股书没写,本刊也不判断。这只是 API 商业条款;Claude.ai 消费者条款和企业单独签的合同本刊没读。
第四部分是账,也是最容易读错的一部分。上期写“约八成撤不掉”,要补三个口径:2025 年底已入账的不可取消托管与算力承诺是 546 亿美元;2026 年初全部长期承诺超过 4,170 亿美元(覆盖 3.5 吉瓦专用算力);招股书后期的“往后约十年至少 5,180 亿美元”,其中约 80%“non-cancelable or requires payment regardless of usage”(不可取消,或不论用量都要付)。三个数的时点和对象不同,不能相加或相除(均据 Reuters,ReutersMEDIA背景 · 09-29)。对手方有六个,Reuters 摘引的数是 Google 约 1,111 亿、Amazon 约 1,100 亿、Broadcom 相关设备租赁约 1,612 亿、Microsoft 约 314 亿、xAI 最多 845 亿、AMD 预计超 200 亿,加起来约 5,182 亿,与总数吻合;条款上,Microsoft 是“non-cancelable except in the event of Microsoft’s uncured material breach”(除微软未补救的重大违约,不可取消),Google 是“If our actual spend falls short, we must pay Google the difference”(实际花得不够,要补差额给 Google),xAI 那一块大多可提前 90 天取消。Reuters 还写,需求“limited principally by the availability of compute”(主要受算力可得性限制)。文件里最扎眼的一对数是:2025 年底现金、现金等价物与短期投资 202.8 亿美元,对着往后十年至少 5,180 亿的承诺(日期不同,别当成同一天的资产负债表)。
有两份 SEC 公开件,能当“撤得掉”的反面例子,上期没写。SpaceX 的 S-1OFFICIAL背景 · 05-20写,2026-05 它与 Anthropic 签了云服务协议,每月付 12.5 亿美元到 2029-05,“The agreements may be terminated by either party upon 90 days’ notice.”(任何一方提前 90 天通知即可终止)。Nscale 的 S-1OFFICIAL背景 · 09-18写,Anthropic 08-25 签了四份 GPU 服务协议,合计最多约 446 亿美元,分四期;某一期在预期交付日之后一段时间还没交付,“Anthropic is entitled to terminate that tranche without liability”(Anthropic 有权无责任地终止该期);Nscale 同时承认“we have not obtained binding commitments for any of the financings required to fund performance under the Anthropic Services Agreements”(我们还没有拿到为这些协议的履行筹资所需任何融资的有约束力承诺)。所以同一家买家,有撤不掉的,有 90 天可撤的,有供应商迟交就能撤的。两处对不上也要写明:SpaceX 那份月费乘以约 36 个月约 450 亿美元,低于 Reuters 摘引的 845 亿,差额没有任何文件解释;Nscale 不在 Reuters 的六家里,446 亿是否另算,也没有文件说明。
买算力的人,同时被卖算力的人投资、分销和竞争。据 Reuters,招股书承认三大云厂商同时是投资者、客户、云供应商、分销商和竞争对手,激励“may not be fully aligned”(可能并不完全一致),第三方算力若被“curtailed, repriced, or terminated”(削减、重新定价或终止)会不利;2025 年约 47%(约 21.6 亿美元)的销售经 Amazon 和 Google 的云市场卖出,Reuters 估算付给两家的分销费约 3.51 亿美元(Reuters 自己算的);Anthropic 把这类合同全额记为收入(自称是“principal”),Reuters 说 OpenAI 曾对投资人和员工说这会让 Anthropic 的收入虚高数十亿美元(Reuters 6 月报道的转述,本刊没读到 6 月稿);两个未具名客户各占 2025 年营收的 12%,许多最大客户没有长期合同,可以削减或停止支出(ReutersMEDIA背景 · 09-29)。十年撤不掉的付款,对着随时能走的收入,期限是错配的(这是本刊的判断)。卖算力的一侧写的是镜像:DayOne 的 F-1OFFICIAL(10-05)写,最大客户占营收的 69.4% 和 69.2%(2025 全年和 2026 上半年),“All of our customer contracts allow for early termination with the payment of specified costs and penalties”(所有客户合同都允许提前终止,付约定的费用和违约金)。“撤不掉”不是行业通则,取决于你站在合同的哪一边。
第五部分是谁在控制。据 Reuters,七位联合创始人通过新设的 Founder LLC,用多数表决决定一股 Class F 股票,占关键事项总投票权的 50.1%;公众买的 Class A 每股一票;IPO 后七个董事席位里,Class F 和 Class A 股东选三位,Long-Term Benefit Trust 选另外四位;治理一条的风险因素写得很直白:这套结构做出的决定“may conflict with short-, medium-, or long-term financial interests and business performance”(可能与短期、中期或长期的财务利益和业务表现冲突),并可能对 Class A 的价值产生负面影响;Class F 在只剩两位及以下联合创始人时开始日落,七位联合创始人承诺把个人股权的 80% 用于慈善(ReutersMEDIA背景 · 09-28)。信托的官方页是 2023 年版,写“an independent body of five financially disinterested members”(五位无财务利益的独立成员),没有 Founder LLC、Class F 或 50.1%,这些只来自 Reuters 看到的招股书(AnthropicOFFICIAL)。政府那一头,Reuters 10-02 的稿子写,招股书说政府机构合同不到年收入的 1%,却把“政府的态度”写成可能波及商业客户和合作方的风险,并点了三件事:今年 2 月总统命令联邦机构停用其模型、国防部把它认定为国家安全供应链风险;6 月商务部对 Fable 5 和 Mythos 5 的全球出口限制让公司对所有客户停用这两款模型,后来限制解除、重新部署;公司说类似措施可能再发生,可能出现“material revenue losses or business disruptions”(重大收入损失或业务中断,Reuters 经 CNBC 转载MEDIA边界日 · 10-02)。Anthropic 自己的 Fable 5 发布页顶部确有 06-12 暂停访问、07-01 重新部署的更新栏,原因没写;本刊没找到 Anthropic 对 2 月命令和国防部认定的官方说法,所以这几件只能按 Reuters 转述写。
先更正一处网上流传的说法,再给规模。“Mathematicians did not ask for this work to be done”(数学家没有要求过这项工作)常被说成 Tao 的话,实际出自人类数学协会(Association for Human Mathematics,下称 AHM)传播工作组 10-07 的声明;Tao 把它作为客座稿转载在自己博客上,只加了一行括注,说稿子原是另一种文件格式、用 AI 转换,没有表态(AHM 官网OFFICIAL、Tao 博客SELF)。Tao 近两周在博客上自己署名写的 AI 帖只有两条转介,其余都是别人的客座稿,所以“上了他的博客”不等于“他同意”。规模方面:OpenAI 仓库 10-07 撤回 3 篇之后,现在写 719 篇、372 个族(我们 10-06 数的是 722 篇);覆盖 17 个领域,一个都没空着,论文数最多的五个是概率与统计力学 105、代数与复几何 86、理论计算机 73、数学物理 59、数论 58,合计 381 篇,约 53%(本刊对仓库 overview.tex 的计数,领域是 OpenAI 自己的分类)。媒体口径不一:Quanta 写“377 个开放问题”,Scientific American 把 372 个族写成 372 个结果。
被覆盖的人,说得最具体的几位都是当事人。Proofs and Prompts 是数学家的公共博客,10-08 发了一份《100+ reactions to 100+ solutions》,46 条反应每条只署姓名、不写单位和职称(Proofs and PromptsSELFMUST)。菲尔兹奖得主 Duminil-Copin 写:“Not a single one of the major open problems I have publicly mentioned throughout my career … was left untouched by the announcement.”(我职业生涯里公开提过的重要未解问题,没有一个没被这次发布碰到),又写“The shock is immense. I am paralysed.”(震惊是巨大的,我麻痹了)。Ben Green 说,他 6 月刚拿到的 ERC Advanced Grant,目标里“around three quarters”(约四分之三)已被这批结果覆盖,同时说理解这些解“likely to be very worthwhile”(很可能非常值得)。Caltech 博士生 Tasmin Chu 写“My grant proposal due next week has to be rewritten.”(我下周要交的基金申请得重写)。Matt Zaremsky 多年在做的 Boone–Higman 猜想也在其中,他写 OpenAI 觉得这个猜想“famous enough that they should spike the ball”(出名到值得庆祝一番),但他也写,他们的充分条件“always works”,自己大概再有一两年也能走到那一步。这些都是署名者自述,不是对结果的独立评估。
站队不是“信不信”,而是“跟不跟 OpenAI 合作、规则谁来定”。欢迎的一边:Daniel Litt 对 Fortune 说“My view is that this is great for mathematics.”(我认为这对数学是好事),在 X 上写“Looks like mathematicians have a lot of exciting work to do.”(看来数学家有很多激动人心的活要干),并说其中一个结果恰是他一条猜想的特例(FortuneMEDIA、XX);Alex Kontorovich 针对其中的准黎曼猜想结果写“If a human did this, it would be an instant Fields Medal, no questions asked.”(要是人做的,立刻就是菲尔兹奖,没得说,XX);Kevin Buzzard 在发布前的 10-01 就写过,要 OpenAI“simply dump”(直接倒出来)全部定理,继续保密“akin to censorship”(近于审查),因为“You cannot fool Lean”(你骗不了 Lean),同时承认自己在数学界是少数派(Xena ProjectSELF背景 · 10-01);Danny Calegari 说未来“more ways to do math, not fewer”(做数学的方式会更多,不是更少),并说他最近最兴奋的动画,代码是 Claude 写的。抵制的一边:AHM 的声明说“Releasing over 700 files at once is not a demonstration of scholarship, but a demonstration of power.”(一次放出 700 多份文件,不是学术的展示,是权力的展示),敦促数学家“discontinue their work with OpenAI”(停止与 OpenAI 的合作);AHM 官网(10-08 读取)写有 808 名会员、其中 532 人属“不用 AI”小组,会员承诺不为商业 AI 公司提供技术劳动、数学知识、咨询或宣传,也不发表 AI 生成的数学文本,Scholze 和 Michael Harris 在公开名单里(AHM 成员页OFFICIAL);Henry Wilton 写“If OpenAI wanted to destroy the mathematical community, this would be a great way to go about it.”(OpenAI 要是想毁掉数学界,这是个好办法);Alexandre Martin 拒绝参加社群组织的阅读小组,因为那等于“free publicity and free refereeing for OpenAI”(给 OpenAI 免费宣传和免费审稿)。中间的人最多,而且常常一个人身上有两面:Lozano-Robledo 10-07 在 X 上写“this (hostile?) takeover of the mathematical landscape”(这场对数学版图的、或许是敌意的接管)和“a massive PR stunt”(一场大型公关噱头),10-08 在汇编里写这天“possibly the single most important day in the history of mathematics thus far”(可能是迄今数学史上最重要的一天,XX);Litt 说他赞同 Tao 关于这个领域必须调整的看法(Fortune 转述)。所以对立的地方是“要不要和 OpenAI 合作”,不是“规则要不要变”。
更深的一层是“什么算数学”。Tao 在 722 篇上线前约 4 小时(UTC 10-06 18:00)在 Mastodon 发了四连帖,没有提 OpenAI:他写“Math 1.0”把第一个解出开放问题当作溢价,而“Math 2.0”要“decenter the role of raw problem solving”(把纯解题的地位降下来),社群要重新评估教育、发表和职称的标准,同时说 AI 在这些方向上也能起正面作用(MastodonSELF)。Fortune 把这组帖写成 Tao 说这次发布标志着 Math 1.0 的终结,后半句是 Fortune 的归纳,不是帖子原话。Tao 对这次发布本身的第一手回应,是 10-08 汇编里的一段:感受“very mixed and complex”(很复杂),很多证明“appear to introduce clever new ideas”(似乎引入了聪明的新想法),但他“deeply frustrated”(深感沮丧):和传统突破不同,涉事的人类没有一个能答疑、做报告、投稿、带学生;他也“horrified”(震惊)于研究生和博后多年慢功夫的研究,被“casually disrupted or destroyed”(随意地打乱或毁掉)。同一个逻辑在 9 月 11 日菲尔兹奖得主联署的声明里就出现过:“solving problems is only a tool and proxy for achieving the primary goal of conceptual understanding and insight”(解题只是实现概念理解与洞见这个首要目标的工具和代理);Tao 当天称是 25 位得主联署,页面现在列 28 位,8,227 人背书;OpenAI 9 月 21 日成立顾问组的公告自己引了这封信当缘由(mathandai.orgOFFICIAL背景 · 09-11)。Erdős 站点站长 Thomas Bloom 说得更直白:站上人们公开互动的主要方式,已经变成发布 AI 证明来登记一份“(increasingly meaningless) priority claim”(越来越没有意义的优先权声明)。
规则怎么动,是这周最硬的一块,而且动的几乎都是社区自己搭的设施。一,Erdős Problems:10-06,站长 Bloom 宣布冻结新评论和证明声明,不再显示每道题的开放或已解状态,也不再显示“已解出题数和比例”,今后不用“某某证明了”这类归功措辞(站点帖OFFICIAL,Tao 博客同日转载);结果是“AI 解出了多少道 Erdős 题”这个最常被引的数字,源头站点自己撤了,此后任何这样的数字都是第三方口径。二,Hexagon:Ben Antieau 10-05 宣布(Tao 博客 10-06 转载),一个新的数学与理论计算机成果库,明说接收“entirely generated by LLMs and even where the submitters claim no human understanding”(完全由 LLM 生成、提交者甚至声称没有人类理解的结果),不做同行评审,不以意义、新意或正确性拒稿,AI 系统不能当贡献者,新账号每天 1 篇;他们说谈过 arXiv,arXiv 不会提供这样一个“home”(HexagonOFFICIAL)。三,arXiv:专题 01 写了 10-01 起每人每月 2 篇;官方博客没有数学分区的数字,本刊自己数了 arXiv 数学归档的月度列表条目(含交叉列表,不是官方口径):2024 年 9 月 4,310、2025 年 9 月 5,144、2026 年 9 月 10,284,其中组合数学从 518 条到 1,476 条(arXiv 列表页OFFICIAL);限额生效第一周(10-01 到 10-07)约日均 330 条,和 9 月日均约 343 条差不多,看不出已经压下去,一周数据而已,时间相邻也不等于因果。一篇 8 月的预印本数了 3 月到 8 月 20 日 32,944 篇带数学分类的论文:披露了 AI 使用且有实质数学贡献的,占比从 1.39% 升到 14.09%,只算主动披露的,是下限(Jin、Ke、SuiOFFICIAL背景 · 08-25,未经同行评审)。四,Caltech 的 Mathathon 09-28 起不再接受专有模型厂商赞助,要求披露并论证 LLM 的使用(联署声明SELF背景 · 09-28);XTX 09-16 关闭 AIMO 奖,理由是“the AI for maths frontier has now shifted definitively to research mathematics”(AI 数学的前沿已经定论地转向研究数学),把各 1,000 万美元投给 Lean FRO 和 Mathlib Initiative(XTXOFFICIAL背景 · 09-16)。
期刊和学会这一头,规则还停在声明和既有条款上。AMS、EMS、LMS 和 Clay 在 9 月针对 Navier–Stokes 各发过声明:AMS 说“The purpose of mathematics is human understanding”(数学的目的是人类的理解);EMS 一边祝贺,一边写“One worrisome aspect”(一个令人担心的方面)是模型在 OpenAI 内部、外界用不了;Clay 写奖项规则的评估过程“deliberately unhurried”(刻意不着急,AMSOFFICIAL、EMSOFFICIAL、ClayOFFICIAL背景 · 09-08 至 09-11);截至 10-08,它们的新闻页上没有针对 10-06 这批手稿的新声明,这是列表页上的负面证据,不等于确认没有。期刊侧本刊查到的明文条款:Annals 的投稿须知有专门一节,“Authors must be human”(作者必须是人),AI 不能署名,如果 AI 工具贡献了一个想法,作者要写明那个想法是什么、在论文哪里(AnnalsOFFICIAL);AMS 的期刊政策沿用 COPE 的写法,AI 不能署名、使用要披露,审稿人和编辑“任何形式、任何理由”都不得把在审稿件上传给大模型(AMS 政策页OFFICIAL);Springer Nature、Cambridge 的 Forum of Mathematics、Elsevier 也是“不能署名、要披露”。这些条款页都没有标条款日期,本刊判断不了是不是近两周才加的,也没有查到哪一家为“AI 生成的证明”单设条款。已有的基线是 6 月 2 日的《莱顿宣言》:国际数学联盟背书,页面(10-08 读取)显示 4,265 人签名,写明结果仍应发表在同行评审渠道,“Informal mechanisms such as press releases or blog posts … cannot replace peer-review or community scrutiny”(新闻稿或博客这类非正式渠道不能取代同行评审和社群审查),宣言没有点名 OpenAI(Leiden DeclarationOFFICIAL背景 · 06-02)。
OpenAI 这边,发布方式本身就有争议:Wired 10-06(美东 13:28,早于仓库上线)的副题引了一位数学家的话,“There’s a perception of mobster behavior”(有一种黑帮做派的观感);首段写 8 月 OpenAI 召集约 40 位数学家开会,出席者说公司保证过不会一次全放,OpenAI 发言人 Lindsay McCallum 说公司“not aware of”(不知道有这个保证,WiredMEDIA,据该文副题和首段)。然后是 10-07 的撤回:仓库 history.md 记录,因为《Algebraicity of Weil classes on split abelian eightfolds》里一处符号错误,“invalidates a stabilization-trace cancellation argument”(让一个稳定化迹抵消的论证失效),两篇依赖同一构造的论文一并撤下,共 3 篇,撤稿通知写“This withdrawal concerns the proof; it does not assert that the mathematical statement is false.”(撤的是证明,不是说命题为假);同一次更新另修订 14 篇、再改 13 篇的引用、新增 6 个形式化,官方口径写“300 / 719 = ~42%”的顶层结果已形式化(openai/math history.mdGITHUB)。这是官方自撤,不是外部发现的错误;仓库本身不收外部反馈,Issues 没开、PR 限制创建,Johannes Schmitt 写 OpenAI 去问数学界是“to their credit”(值得肯定),但“An OpenAI-controlled GitHub repository, with issues and pull requests disabled, cannot serve this purpose”(一个 OpenAI 自己控制、关了 Issues 和 PR 的 GitHub 仓库,起不了这个作用)。质量上的另一条线索也出自汇编:Giulio Tiozzo 拿第 254 号例子(一个无 CAT(0) 作用的 Artin 群)说,OpenAI 给的群有 116 个生成元,他把它丢给 Astra,10 分钟得到 12 个生成元的新例子,据此推断“many papers were never reviewed by a human”(很多论文从没被人审过,是他的推断),并问“What did we even need AGMAI for?”(那我们到底要 AGMAI 做什么)。AGMAI 是高等研究院下设的九人咨询组,它 09-29 的建议第一句就是请 AI 公司“stop testing advanced mathematical problems on proprietary models”(别再在专有模型上试高阶数学题),10-06 的声明又说咨询角色“不应被理解为对流程的背书”;AHM 则说 OpenAI 借它取得正当性。咨询组两头不讨好。
人和职业这一头,目前能核的是话,不是政策。Quanta 10-05 的专栏写到:9 月 10 日 Ken Ono 在 Berkeley 的一场讲座,约 150 名学生和教授到场,原定 50 分钟的问答被愤怒的提问拖过两小时;Tasmin Chu 和同伴成立了 AHM(Quanta 专栏MEDIA,观点栏目)。Henry Bradford 在汇编里写,他最担心的是下一代:“the necessary incentives may no longer exist for bright young people to invest that effort”(让聪明的年轻人愿意投入那么多功夫的激励,可能不再存在);Lozano-Robledo 在 Tao 博客的客座文里转述一位学生的来信“I’ve just really been lost for a couple of months”(我已经迷茫了好几个月),说自己最担心的是“we are about to lose an entire generation of mathematicians”(我们可能要失去整整一代数学家),同时给学生的结论是“Keep calm and carry on studying math.”(Tao 博客客座文SELF)。Buzzard 10-01 写到他认识的一位博后在考虑离开数学研究,一位博士生卡在一个引理上,ChatGPT 一次提示就解出来,让他怀疑意义何在。制度侧的回应是建议:哈佛数学系和 CMSA 09-17/18 的博士教育峰会(24 位资深数学家)建议评估以线下笔试或口试为准,博士论文“need not record the first proof of a statement”(不必记录某个命题的第一个证明),用 AI 的人要对署名内容负责并披露(峰会报告OFFICIAL背景 · 09-18);这是草案建议,不是任何一所学校已生效的规则,本刊没有查到哪个数学系公开改了博士资格考或招生。钱的走向分两头:美国 DARPA 的 expMath 项目 3 月启动,目标写的是“an AI co-author”(一个 AI 合著者),13 所大学参与(DARPAOFFICIAL背景 · 03),而上面的期刊条款写着 AI 不能署名;10-06,AI for Math Fund 再拨 1,710 万美元,选中 22 个项目,其中一个是给数学家读懂 AI 生成数学的可视化证明环境(Renaissance PhilanthropyOFFICIAL)。
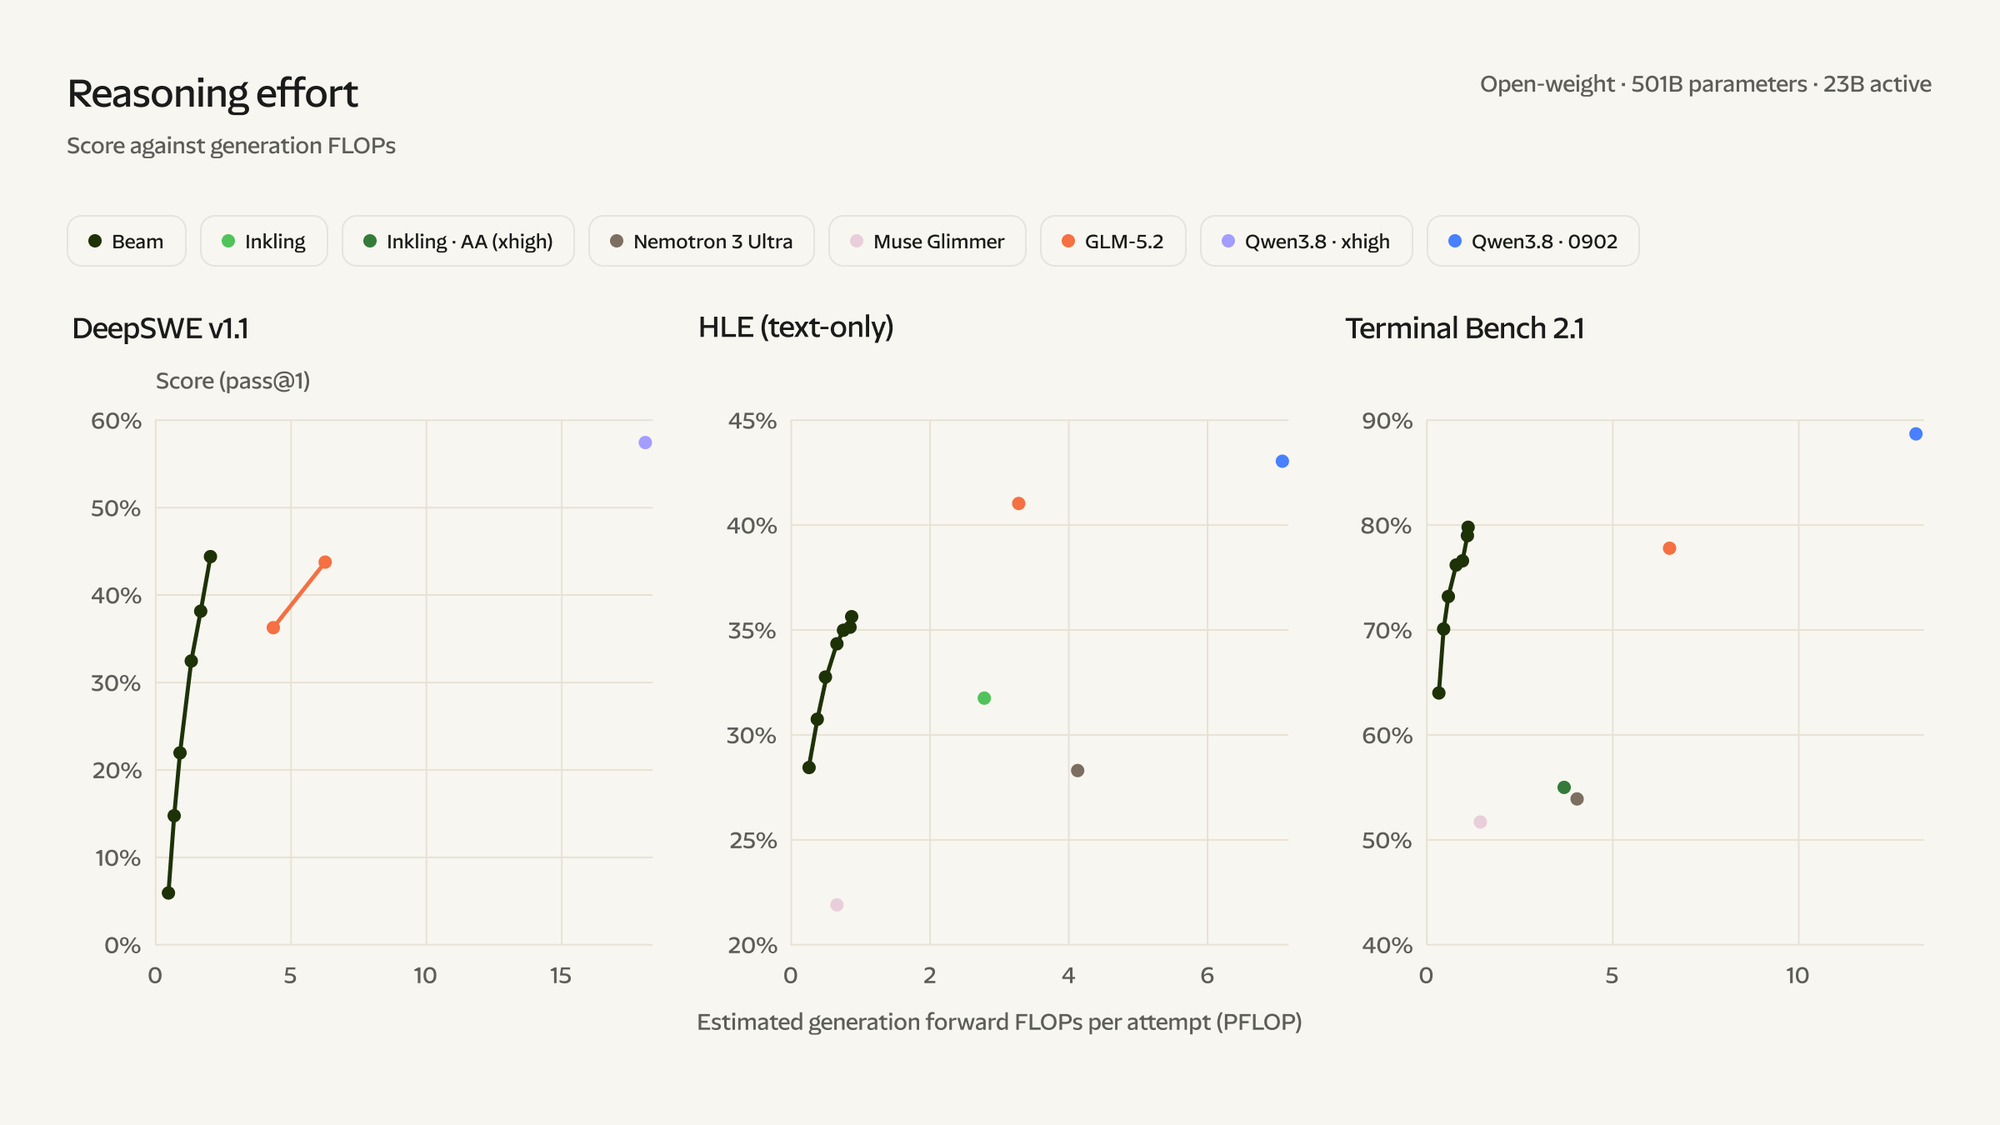
西方两家同周官宣大模型的开放权重,权重都还没放:Reflection Beam 和 Mistral Large 4OFFICIAL——Reflection 10-05 官宣 Beam:总参数 501B、活跃约 23B、纯文本、1M 上下文,计划 Apache 2.0;官方原话是“We will release the weights, technical report, model card, and developer artifacts later this month”,现在只有早期访问的候补名单(TechCrunchMEDIA写明“claims haven’t been independently verified”)。Mistral 10-06 的 Large 4 是公测,权重“end of the month”放,许可证页只写了“OPEN”,没写条款(MistralOFFICIAL,分档放行那一面见故事线 A)。两家的基准都是自报。Reflection 表里 DeepSWE v1.1 是 44.4,Kimi K3 是 68.0、GLM-5.3 是 61.0,官方自己写“Where frontier open models like Kimi K3 remain ahead on raw capability, Beam’s advantage is efficiency at inference time”(Kimi K3 这类前沿开放模型在原始能力上仍领先,Beam 的优势是推理效率);“少 3–4 倍推理算力”是它用 FLOPs 估算的,页内自注是近似。 另外,“美欧首次拿出大开放权重”这个说法站不住:Artificial Analysis 的开放权重名单OFFICIAL里早有美国 Thinking Machines 的 Inkling(975B)和英伟达的 Nemotron 3 Ultra(550B),Reflection 自己的对照图里就画着它们;它们的得分都不在中国头部那一档。
Reflection 自己的对照图:同样的分数,Beam 估算的算力在最左边;分数最高的点仍是右侧的 Qwen3.8,对照组里有美国的 Inkling 和 Nemotron 3 Ultra(图源:ReflectionOFFICIAL,自报)
OpenAI Decisions API 对所有开发者公测,输入每百万 token 0.10 美元OFFICIAL——上期 DevDay 时还只是 limited preview,官方说“broad release planned in the coming days”。现在官方指南写“in public beta, and we expect to GA in the coming weeks”(公测,预计几周内正式发布);计费只收输入 0.10 美元每百万 token,输出、缓存读写都不收;目前只支持 gpt-6-luna,官方称比 Responses API“about 10x faster”(自述,没给基准);图片只能传内联 base64。官方 API changelog 记的首发日是 10-06。这是上期专题 01 的后续,也是上面复盘第 5 行的依据。
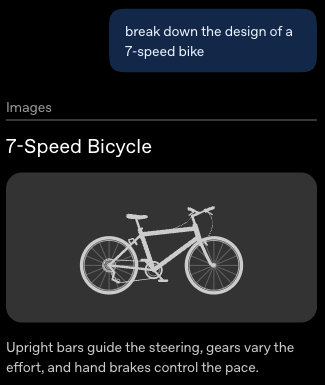
OpenAI 把 ChatGPT 聊天页换成 GPT-6,并上线 Intelligent UI:回答可以直接带图表、按钮、表单和能在对话里用的小工具OFFICIAL——10-07 发布,付费档当天推,Free 和 Go 档 10-08 起;官方页写底层是 GPT-6 Sol(付费档)和 GPT-6 Luna(Free、Go 档),“The models powering Work and Codex are not changing as part of this release.”(Work 和 Codex 用的模型这次不变)。Intelligent UI 不是新模型名,是生成式界面:官方说“We’ve trained GPT-6 to compose responses using text, visuals and interactive elements”(我们训练了 GPT-6 用文字、视觉和交互元素来组织回答),技术上是“a library of native, streamable components, along with a compiler that processes the interface as the model generates it”(一套原生、可流式的组件库,加一个在模型生成时同步处理界面的编译器);示例有周日烤羊肉的计划配计时表、中心极限定理和蒙提霍尔问题的交互讲解、账单分摊和退休储蓄计算器这类小工具。速度和质量的数字(需要联网搜索的问题上,GPT-6 Instant 平均比 GPT-5.6 Instant 早 44% 开口)都是 OpenAI 内部评测,没有第三方数据;官方页没有写“6.1”,别把这里的 GPT-6 Sol 等同于站内写过的 GPT-6.1 Sol。补读几处一手:ChatGPT 发布说明OFFICIAL写 Intelligent UI 在 Instant 到 Extra High 各档可用,“The Pro reasoning option continues to use GPT-6 Astra and doesn’t support Intelligent UI.”(Pro 推理档继续用 GPT-6 Astra,不支持 Intelligent UI);帮助中心OFFICIAL写它没有单独的用量额度,旧版 macOS 和 Windows 桌面端不支持,网页设置里可以关“Layout and visuals”。系统卡OFFICIALTECHREAD全文没有专门针对生成式界面的评估(本刊对 interface、button、component 等词检索零命中),最接近的是通用的间接提示注入稳健度(Sol 97.13%、Luna 95.80%,OpenAI 自测);卡里承认 Luna(Free 和 Go 的默认模型)在自伤、血腥、性内容上有统计显著的退步,称人工复核后多为低严重度。OpenAI 员工在 X 上讲了取舍(个人帖,不是公告):Aarush Selvan 写“Simply outputting HTML wasn’t going to cut it”(光输出 HTML 不够),所以自建组件库和边生成边编译的编译器(XX);Michelle Pokrass 把 Free 和 Go 晚一天说成“it’s hard to move thousands of gpus around in one day”(一天里挪动几千块 GPU 很难,XX)。首批媒体多是转述官方演示,没有找到独立实测;SiliconANGLEMEDIA指出 OpenAI 没说会不会更耗 token。一处口径提醒:同一官方页的德语段落写“32 %”,英文句和柱状图写 44%,官方没有解释;两者都是内部评测,指开口更早,不是答完更快。
OpenAI 官方页里的示例:问“拆解七速自行车的设计”,回答里直接是配图和说明,后面还可以点开交互(图源:OpenAIOFFICIAL)
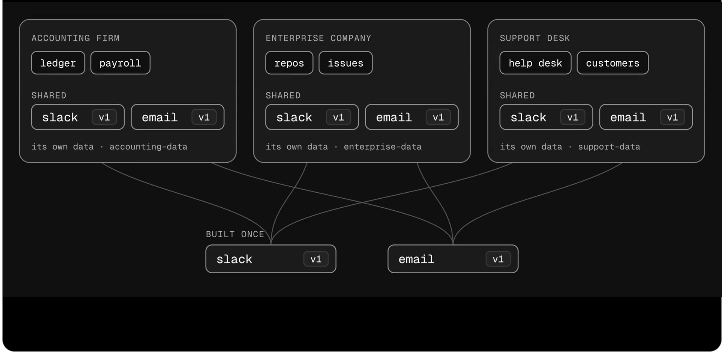
Scale AI 把自家所有 RL 环境的底座 AgentEnv 开源:环境、数据、规则三块积木,同一个任务可以接 Claude Code、OpenAI 的 agent 或自研 agentOFFICIAL——Scale 帖子 10-06、博客页标 10-05:“Every RL environment we build runs on AgentEnv. Today we’re open-sourcing it, so more people can build the worlds agents learn in.”(我们造的每一个 RL 环境都跑在 AgentEnv 上,今天开源,让更多人造出智能体学习的世界。)是 Python SDK 加 CLI,Apache-2.0,GitHubGITHUB 10-08 约 193 星;环境卡(Environment Card)通过 MCP、REST 或生成的 CLI 暴露工具,配合 A2A 的 Agent Card,任务是步骤组成的有向图,内置 48 种步骤,4 种沙箱。“每个 RL 环境都跑在上面”是 Scale 自述,用量没有披露。博客和官网都没提 Scale 9 月 28 号那篇审计基准的论文(EP.105 专题 02),把两者连起来是编辑推断,Scale 没这么说。
博客图 2:共享的 Slack、邮件环境只造一次,修一处,所有用到它的环境都跟着好(图源:Scale LabsOFFICIAL)
chatgpt.site 是 OpenAI 自家的网站托管:ChatGPT Sites 发布的网址形如“站名.用户名.chatgpt.site”OFFICIAL背景 · 06-02 / 07-09——从一个个人做的 3D 小游戏的网址说起(wobbly-lab-mobile.quincy2333.chatgpt.site,个人作品,页面无署名无日期,本刊推断它是用 Sites 发布的)。OpenAI 的发布说明写:6 月 2 号 Sites 在 Codex 应用里预览,能“create, save, deploy, and inspect websites, dashboards, internal tools, web apps, and games hosted by OpenAI”(创建、保存、部署、检查由 OpenAI 托管的网站、看板、内部工具、Web 应用和游戏);7 月 9 号在 ChatGPT 公测,“Sites is not available on Free or Go plans.”(Free 和 Go 档用不了,发布说明OFFICIAL);官方账号 09-11 称上线三个月“people have created over 5M sites”(用户已建超过 500 万个站,OpenAI 自述,XX)。要分清:Intelligent UI 在聊天页里直接生成的小工具,官方页、系统卡和帮助中心都没提能一键发布到 chatgpt.site,它们是两个产品。
看演示先看披露了什么:Opus 5.5 发布周被转发最多的三个第三方演示,披露程度完全不同SELF背景 · 09-22——一,Forward Future 的 Alex 用 Opus 5.5 加 Unreal 做的黑暗之魂风格游戏(X 帖X,60 万次查看):提示词和迭代次数没披露,Forward Future 自己的汇总页写“These projects cover different prompts, tools, and amounts of iteration.”(这些项目的提示词、工具和迭代量各不相同),录像“aren’t a controlled benchmark”(不是受控基准),传播中却被不少人读成“一句提示词”。二,Higgsfield 在 X 发的 Opus 5.5 对 GPT-6 Sol 的 3D 游戏并排视频(X 帖X,厂商营销系列帖):没披露提示词,画面标签一边是“HIGGSFIELD / CLAUDE OPUS 5.5”、另一边只标“GPT-6 SOL”,回复里有人问两边提示词和工具是否相同,Higgsfield 没回应;也有回复说这是 Theo 的“FishSlop”水下游戏题材——题材相近、Theo 的原始测试更早,但 Higgsfield 的提示词没披露,本刊没法证实,不当事实。三,个人开发者 riba2534 的三个 3D 网页游戏仓库(GitHubGITHUB,约 1k 星,09-23 提交):一句话提示词原文、源码和部署全公开,“单会话、零人工改动”是作者自述,仓库首次导入之后还有 4 次提交,分不清是人改的还是模型提交的;README 同时写明模型自己联网查资料、跑无头浏览器测试、派子代理审查并修了 12 个问题,所以“一句话”指人只输入了一句,不是模型只写了一遍。三个里披露最好的反而是个人那份。
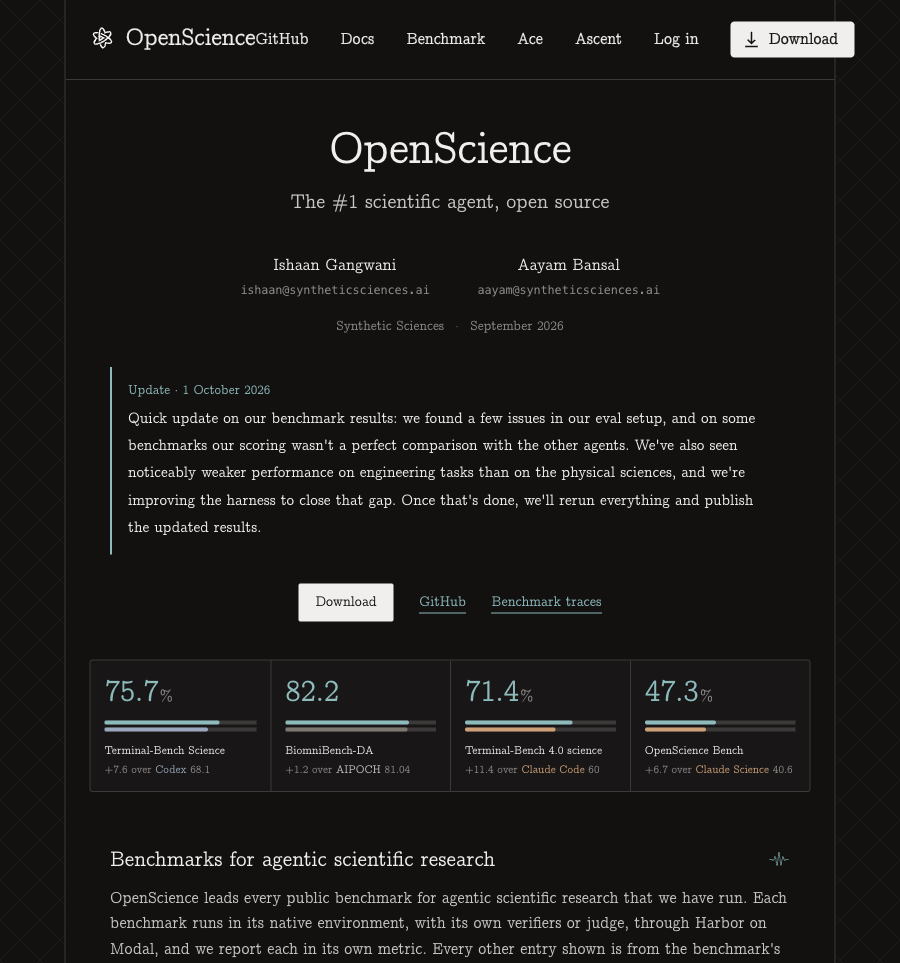
开源科研智能体 OpenScience 自称“第一”,10-01 自己更新说评分“并非严格可比”,要重跑SELF背景 · 09-27——YC 公司 Synthetic Sciences 09-27 在 XX写“OpenScience is now the #1 scientific agent.”,官网头条是 Terminal-Bench Science 75.7%(53/70),官方榜首 Codex 加 GPT-6 Astra 是 68.1%。几处口径:这个榜是 Stanford 研究者牵头的 Terminal-Bench Science(70 题),官方榜每题跑三次,10-08 的 17 个条目里没有 OpenScience,它的分数是自己跑的单次尝试;它和榜首用同一个底座模型,官网自己写“Three of those entries run the same model, so their gap is the harness”(三个条目用同一个模型,所以差距在 harness);BiomniBench-DA 上领先 1.2 分,但底座模型不同;OpenScience Bench 是它自己出题的内部基准;官网也写工程类任务上 Codex 领先(70.4% 对 55.6%)。10-01 官网加了更新:“on some benchmarks our scoring wasn’t a perfect comparison with the other agents”(有些基准上我们的评分和其他智能体并非严格可比),并说会重跑后公布;10-02 的 X 帖说法一致。截至 10-08,页面标题和头条数字仍挂着。公众号 BioTender 的“自封第一”判断,依据在公司自己的官网上都找得到。
OpenScience 官网首屏:标题仍写“#1”,上方是公司 10-01 的更新说明(图源:openscience.shSELF,10-08 截取)
补两条个人 Agent 的官方说法:Meta 讲 Muse 的隔离虚拟机和审批代理,Manus 讲 Cue 里每个 Agent 的邮箱、手机号、钱包和电脑OFFICIAL背景 · 09-28——故事线 B 里 Muse 的授权弹窗和 Cue 的默认权限是主线,这两条是对应的官方架构说明,不是第三方审计。Meta 新闻室写 Muse 跑在每个用户专属的 Muse Secure VM 里,“Nothing Muse does reaches the internet unless the Sentinel approves it”(没有 Sentinel 批准,Muse 做的事碰不到互联网),凭证放在安全存储里,Muse 用得了但看不到明文,并承诺 Muse 不把对话和 VM 里的数据共享给 Meta 的广告系统,机密虚拟机“later this year”(今年晚些时候)才上线。Manus 09-28 发布 2.0 并推出 Cue,官方博客OFFICIAL称 Cue 里每个 Agent 有自己的邮箱、手机号、钱包和电脑,可在用户设定的预算内付款,目前需邀请码早期访问。两家都说得很细,但故事线 B 的问题没变:这些架构是公司自己的描述,收回已放出的权限仍然没有一家做。
Muse Charm:Meta 官方只写了两句话,规格都来自 Bloomberg;Muse 上线前的内部状态,Meta 自己的博客承认得比媒体更直白OFFICIAL背景 · 09-24——Meta 09-24 的回顾稿对 Charm 只有一句定义:“Muse Charm is a delightful and fun device built for you to talk and interact with your Muse.”(一台专为和你的 Muse 说话、互动做的有趣小设备),加一句“更多信息今年晚些时候”;产品页没有价格、规格、日期。规格都据 Bloomberg 的 Mark Gurman(二手,Irish Times 全文转载):约 2 英寸 OLED 触屏、5G、前后摄像头、不能打电话,价格在“智能手表区间”(知情人士),扎克伯格称 12 月前开售,内部代号“Clawmagochi”(Tamagotchi 加 OpenClaw)。APPSO 说的“苹果液态玻璃缔造者”确指 Alan Dye:苹果 2025-06-09 的 Liquid Glass 发布稿里他是 Human Interface Design 副总裁,扎克伯格 2025-12-03 官宣他领导 Reality Labs 的新创意工作室;但“Charm 是他的作品”只到 Bosworth 说他和 Sorrentino 是项目的“两大推动者”,圈内关于“功劳归属”的说法是传闻,本刊不写。同一篇回顾稿还写“Muse will have its own email address that it can use to get things done”(Muse 将有自己的邮箱用来办事),和 4 天后 Cue 的“每个 Agent 有邮箱”同方向。
meta.com 的 Muse Charm 产品页首屏;页面状态是“Not yet available in your region”,没有价格和规格(图源:MetaOFFICIAL,10-08 截取)
DeepTech 的《Muse 走红内幕》(09-28)并不是编译自 The Information:它写“连贯性测试”的那一段出自 Business Insider 09-26 的付费独家MEDIA(单一匿名来源):Muse 上线前两周还“说不好英语”,之后才在连贯性测试里拿到好成绩,“残次品”是标题的措辞。Meta 自己的安全博客(研究博客OFFICIAL背景 · 09-08)更直白:脚注写明“Hatch is our internal name for Muse in the codebase”(Hatch 是 Muse 在代码库里的内部名字,所以 Hatch 不是传闻),开篇承认团队把“inboxes, calendars, and a shell”交给软件无人值守运行,并不总是按计划(原话:“handed our inboxes, our calendars, and a shell to a piece of software and let it run unattended”)。Reuters 09-08 转述 Meta 副总裁 Vishal Shah 说 4 月曾为更安全推迟发布,并说“It is impossible to say that there is never going to be a mistake”(不可能说永远不会出错);“原定 4 月上线、一路推迟到 9 月”是 DeepTech 的改写,Reuters 只写“在 4 月推迟了”。Sensor Tower 测算头两周约 280 万下载、日均环比增速 55%(对比 ChatGPT 前 10 天的 24%,TechCrunchMEDIA转述),但 TechCrunch 同时写另两家估算差一倍(Apptopia 430 万、Appfigures 约 230 万),55% 也是起步基数很小时的日环比平均。
Cue 的几处官方细节:“新伙伴”不是收购方,钱包只说“预算内付款”,邮箱手机号钱包电脑在官网 FAQ 里变成了“可以有”OFFICIAL背景 · 09-28——蝴蝶效应(Manus)09-28 公众号稿里的“新伙伴”,原文只说在为国内市场组建团队、与国产模型厂商及生态伙伴合作,没点名任何公司;真正的背景在更早:Meta 2025-12-29 收购 Manus,国家发改委 04-27 禁止该交易并要求撤销,Manus 官方博客 09-01 宣布“Manus has formally resumed independent operations”(Manus 已正式恢复独立运营,官方博客OFFICIAL背景 · 09-01)。Cue 是独立的新 App,不是“海外版 Manus”,需邀请码,iOS 版等 App Store 审核。博客写“each agent has its own email, phone number, wallet, and computer”(每个 Agent 都有自己的邮箱、手机号、钱包和电脑),钱包部分只说“pay within the budget you set”(在你设的预算内付款);cue.im 的示例指令里付款写成“Pay with Link, and I’ll confirm on my phone”(用 Link 付款,我在手机上确认),页面又写“pays with its own card”(用自己的卡付款),两者怎么对应官方没说,FAQ 里每个 Agent 的这些能力也变成了“can have”,哪些动作要批准“由你设”,没有默认值。
Dots 的泄露和官宣对了一遍:名字和方向对,短信官方当天还写“即将”,3D 角色一条我们没能在官方页文字里核到OFFICIAL背景 · 09-29——泄露来自 @M1Astra 在 09-29 04:56 UTC(北京 12:56)发的字符串,TestingCatalog 随后转引X:“Dots, your remarkably capable agents.”可以发短信、打电话、Slack、邮件,能在你批准后替你买东西,“Each dot gets its own 3D character you design.”;他在回复里说只有一处写着“Delete o?”,其余地方都是 dots。OpenAI 官方页(只标 September 29, 2026,没有时刻)写“Dots are remarkably capable, always-on agents built to handle everything.”,可在 ChatGPT 的桌面、网页、手机里发消息或语音通话,也能在 Slack 和 Teams 里发消息,“with texting coming soon”(短信稍后推出);官方页文字里没找到“3D 角色”和“邮件”的字样(可能在视频里,我们没看)。同日的 ChatGPT 发布说明写它由 GPT-6 Astra 驱动,有自己的云电脑,先给符合条件的 Pro 和 Business Premium 用户,Pro 不含欧洲经济区、瑞士和英国。
个人 Agent 的虚拟机配置:四家官方页都没写数字,网上流传的全是实测MEDIA背景 · 10-01——公众号“歸藏的AI工具箱”10-01 的一张图对比了几家个人 Agent 的云电脑:Muse 约 2 vCPU、8 GB 内存、100 GB 磁盘,OpenAI dots 约 9 vCPU、10 GB、32 GB,Grok Bot 约 8 vCPU、16 GB、126 GB,Cue 约 8 vCPU、16 GB、54 GB。官方只有定性说法:Meta 研究博客写“Each Virtual Machine(VM) is an isolated linux box with a browser and enough storage, CPU, and memory to do real work”;OpenAI 说“Each dot works on its own cloud computer”(每个 dot 在自己的云电脑上工作);SpaceXAI 的文档写“Every Bot on your account uses the same computer”(一个账户下所有 Bot 共用一台,文档OFFICIAL);Cue 只说有自己的电脑。所有数字都是实测或网友拿到的环境记录,不是官方:dots 的那条 Geekbench 记录(EPYC 9V74、9 核)上传于 09-25,比 09-29 的发布会早 4 天,记录页本身不写产品名,归属是推友和 Wccftech 的推断。唯一有官方数字的是 Manus 单独卖的 Cloud Computer(2 vCPU/4 GB/70 GB 每月 30 美元,2 vCPU/8 GB/120 GB 每月 50 美元,帮助中心OFFICIAL),它不是 Cue 里每个 Agent 的那台电脑。运行时长和并发,四家官方页都没给数字,dots 只提到有“时间预算”设置。
个人 Agent 被网站拦在门外:沃尔玛是 Muse 的合作方,却因“验证你是人”的按钮把它踢了出去MEDIA——TechCrunch 10-06:Amazon 近期开始拦 Muse;沃尔玛说拦截“不是故意的”,问题在网页上的人机验证按钮,流程一被打断就判失败;达美说是在保护客户免受未授权的自动化活动、目前没有与第三方 AI Agent 的合作;联合航空指向条款里禁止“robot, spider, other automatic device”;Yelp 说除非 Agent 通过数据授权计划付费,不允许非人类流量;eBay 说限制的是未授权的 Agent 和行为(自动抓取、模型训练),并非禁止所有第三方购物 Agent。Meta 在公告里写“Turning away a personal agent means turning away the customer behind it.”(拦下个人 Agent,就是拦下它背后的客户)。有人怀疑 Cloudflare 09-15 改的爬虫默认设置影响了 Muse,Cloudflare 说没有具体数据可分享——这是“有人怀疑”,不是事实。TechCrunch 列的 Meta 合作伙伴名单和 Sierra 官方博客不一致(多了 NiCE、Decagon,少了 Instinct、Shopify),故事线 B 用的是 Sierra 的名单。
开源的 Photoshop 复刻 PhotoCraft 约 19.7k 星:自述 clean-room、早期 alpha,还不能替代专业日常使用;“Adobe 被炸”是一条推文的措辞GITHUB——GitHub 10-08 读取:19.7k 星、约 2.6k fork,Rust 占 99.2%,MIT 或 Apache-2.0 二选一。README 写“Clean-room: implemented from public specs and observed behaviour only. No proprietary code, shaders or assets.”(clean-room:只依据公开规范和观察到的行为实现,没有专有代码、着色器或资源),也写“it is not yet a Photoshop replacement for daily professional work”(还不是日常专业工作的 Photoshop 替代品,缺口包括 AI 生成功能、约二十个工具、排版和专业工作流、插件兼容)。仓库首个提交在 09-30 06:12 UTC,约 3 小时后一次性导入 241 个文件、4.2 万行(提交信息“one-shot”,仓库自己的提交历史)。开发者 Brandon Thomas 据 PetaPixelMEDIA转述在 Reddit 上说用 Opus 5.5 用 Rust 重做了 Adobe 的七款软件;他在 Hacker NewsHN上写“99% parity will take a while, but I’m sure it’ll be measured in months and not years.”(99% 对等要一阵子,但肯定以月而不是年计)和“These are still super early alpha.”。“Adobe 被炸”不是 Adobe 发生了什么,而是 Eric S. Raymond 10-06 的一条推文(XX,370 万次查看):“Adobe just got nuked. And closed source is dead, dead, dead.”(Adobe 刚被炸了,闭源已死),他还猜项目是把 Photoshop 反编译再喂给 LLM——这个猜测没有证据,和项目的 clean-room 自述相反,我们也没找到 Adobe 的任何官方回应。公众号 AGI Hunt 10-07 的文章(原文MEDIA,页面 10-07 有修改)把它解读为“闭源软件壁垒被 AI 压低”,文中的“一晚上复刻”和“完成度 90%”是该文作者的估计,不是项目自己的说法。
微软开放预订 Surface Laptop Ultra:起价 2,599 美元,搭载 Nvidia RTX Spark,最多 128GB 统一内存,微软称能本地跑 1,200 亿参数以上的模型OFFICIAL——10-07 发布会,10-16 起供货;同日的 Surface RTX Spark Dev Box 是 5,999 美元,仅美国,11 月发货;华硕、戴尔、惠普、联想、微星的 RTX Spark 笔记本同日预订、10-16 起发货。微软自称对比 MacBook Pro 16 英寸 M5 Pro“up to”首 token 快 2.1 倍、AI 生图快 4.3 倍、AI 视频快 6.2 倍(微软自测,脚注定义,Bloomberg 标题里的“outperforms MacBooks”就是这套),“1 petaflop”是脚注里 FP4 稀疏下的理论值。Windows 博客列的本地模型有 MAI Code 1.1 Flash(137B 总参数、6.8B 活跃)和 DeepSeek V4 Flash(284B),Nvidia Nemotron 即将到来。Brett Ostrum 的原话:“Windows is the OS for agents, and Surface is the hardware for Windows.”(Windows 是 Agent 的操作系统,Surface 是 Windows 的硬件。)Agent 权限那一半见故事线 B 的 MXC 和 Copilot 段。
Anthropic 官宣 Claude for Google Workspace 公测:侧边栏进 Docs、Sheets、Slides,默认每处改动都要你点头OFFICIAL——10-06 官宣,所有付费套餐可用;另有三个连接器让你从 Claude 对话里创建、编辑 Google 文件。官方写默认是“Ask before edits”,每处改动出一张审批卡片等你确认;也可以切到“Accept all edits”,Claude 一路改完不停。访问范围跟随你现有的 Google 共享权限,Team 和 Enterprise 需要管理员先启用连接器。和故事线 B 的 Muse、Dots 对照:同样是“替你动手”,这里默认是逐条批准。
Anthropic 发 Haiku 5.5 的同一天,价格表和订阅还动了三处:Sonnet 5.5 缓存读价减半、Max/Team 每月送 API 额度、Haiku 首次带网络安全护栏OFFICIAL——Sonnet 5.5 的缓存读价从 $0.20 降到 $0.10,官方称大多数 Agent 任务约便宜 20%;Max 5x 每月 $100、Max 20x $200、Team 最多 $500(团队内共用)的 API 额度,可用于任何模型(帮助中心OFFICIAL);Haiku 5.5 的网络安全护栏“more restrictive than Haiku 4.5’s, but somewhat less restrictive than those we’ve applied to other recent models”(比 Haiku 4.5 严,比最近其他模型松),仍拦渗透测试等更可能被攻击者用的技术。价格口径:Haiku 5.5 的 $0.10/$0.50 只适用于 10 万 token 以内的提示,超过是 $0.50/$2.50,官方说的“平均约便宜 75%”已经把新分词器每个任务“slightly more tokens”(略多用一些 token)算进去了。
OpenAI 首次公布 ChatGPT for Teens 的使用数据:平均每天不到 15 分钟;同日 Common Sense Media 把它评为“不可接受风险”OFFICIAL——OpenAI 10-07 写青少年平均每天用不到 15 分钟、不到 2% 连续用超过三小时(OpenAI 自述,只有均值);同日 Common Sense Media 的 Youth AI Safety Institute 把它评为“Unacceptable Risk”,称新建的家长绑定账号上谈自伤最多一小时、家长零提醒,漏掉超四分之一的危机转介(评级方新闻稿OFFICIAL,TechCrunchMEDIA)。OpenAI 称测试在家长控制生效前就做完了;Common Sense 披露其资金包括 OpenAI Foundation。“College Planner”官方写的是“即将推出”,别写成已上线。一边是自报均值,一边是第三方测试,这是故事线 A“评估由谁做”的又一个例子。
DeepSeek Harness:开源的 Agent 框架,GitHub 约 24.6 万星,10-03 出 v0.2.1-alpha.1,新增试验性的 Claude Code Mods 兼容层OFFICIALGITHUB——仓库 08-13 创建,MIT 许可,25 个版本全是预发布(10-08 读取:245,635 星);官网写“public preview worldwide and open source, with composable plugins that extend what agents can do”(全球公测、开源,用可组合的插件扩展 Agent 的能力),默认模型是 DeepSeek-V41-Flash,插件包括计划任务、子 Agent、自动审批评审,“创造模式”让 Agent 自己写插件。v0.2.1-alpha.1 的发布说明自己写,Claude Code Mods 兼容层“broadly a subset of what DeepSeek Harness plugins can do”(大致是 Harness 插件能力的子集),目标是验证 Mods API 的能力(GitHubGITHUB)。
Agent 工具注册表 Monid:10-06 称融资 770 万美元,首页现在写 2,400 多个工具、87 家以上供应商,按次付费、不用逐家注册OFFICIAL——创始人 Shengkun Ye 10-06 在 X 上写“We just raised $7.7M to kill every subscription for agents.”(刚融了 770 万美元,要干掉 Agent 的所有订阅,SELF,融资细节只有这一处一手,没有第三方核)。首页(10-08 读取)的做法:让 Agent 自己比较、挑选、调用工具,“no sign-up needed”(不用注册),按次计费,示例单价 $0.0013,所有工具共用一个余额,新用户送 1 美元额度;列出的工具里有 Reddit、TikTok、Instagram、YouTube、Amazon 等平台的抓取,也有 People Data Labs 这类人员检索,页面写“Monid is open source”。本刊 10-08 早些时候读到的首页数字是“1,800+”,夜里再读是“2,400+”(页脚写 2,443),都是首页自述,没有清单可核。10-08 书签里一条帖子(叫我阿杭,该串第一条 5.3 万次浏览)说它“无视任何防爬设计”“能直接开盒”:首页没有这样的说法,本刊没有测试,也不会去测;抓取和人员检索的合规责任落在各个供应商身上,而 Agent 靠一个余额就能一路调下去,意味着这里的“预算上限”就是余额本身。放在故事线 B 的背景里读:Agent 能自己找工具、自己付钱,越界的入口不只是用户授权的那几个应用。
AI 产出与溯源
OpenAI 要在欧盟的 ChatGPT 和 Codex 文本输出里加隐形水印,现在还没上线OFFICIAL——10-05 官宣。原话是“Over the coming weeks, we will add an invisible watermark to eligible ChatGPT and Codex text output in the European Union”,同一页写明“We are not making text watermarking a global default at launch”。API 从 10-05 起全球客户可以选开,默认关;检测器不公开,只对获批的研究者和机构开放申请。官方自报的检出率(1% 误报率下):约 200 个 token 的段落约 80%,400 个 token 约 95%;把 400 token 文本里 10% 的词换成同义词,检出从约 92% 掉到约 66%,换 25% 掉到 17%——所以它防的是原样搬运,不是改写。官方说加水印前后在 Astra 的基准上没有明显差异(OpenAI 自测)。
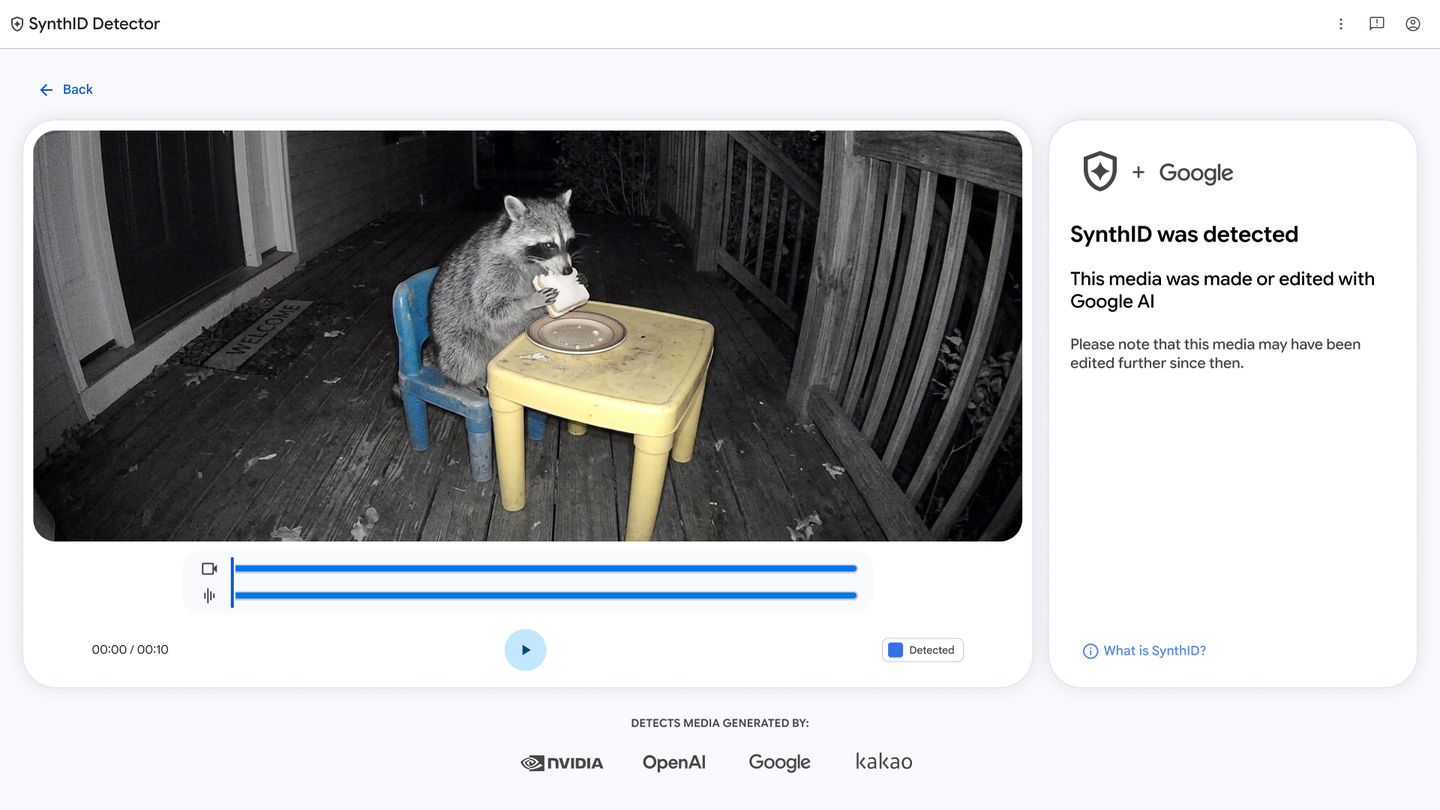
谷歌把 SynthID 检测站向所有人开放,覆盖谷歌、OpenAI、NVIDIA、Kakao 的水印OFFICIAL——10-07 起全球可用,目前只有英文(DeepMind 的 Pushmeet Kohli:“we’re expanding access to everyone”)。谷歌自报 SynthID 自 2023 年起已给超过 1800 亿张图片和视频、24 万年的音频加了水印;它检的是这几家加的水印,不是通用的 AI 检测器,TNW(引 Engadget)说水印在某些情况下可以被去掉。
检测站的结果页:上传一段视频,提示“SynthID was detected”,页脚写明能认出哪几家的水印(图源:谷歌官博OFFICIAL)
挪威政府拟在部分公共场所临时禁用 AI 眼镜MEDIA——10-05(Reuters 稿,本刊读的是 Irish Examiner 的全文转载)。这是“计划提出”的临时禁令,不是已生效:政府是少数派政府,称会“as soon as possible”向议会提交,并设专家组研究永久监管;范围可能包括公园、海滩、博物馆、商场、公共活动,学校和青年俱乐部,以及诊所、游泳池和带更衣室的健身房;官方明确“not eyeing a total ban”,私人使用和不会在对方不知情时拍摄的场合仍允许。部长 Torgeir Micaelsen 的理由是“I am worried that new, powerful technology is being introduced where people risk being photographed, filmed or audio-recorded without knowing it”。Reuters 稿里没有“首个”这类说法,别写。
医疗 · 法律 · 金融
犹他州一家创业公司开始由 AI 开痤疮的初始处方OFFICIAL医疗——Nolla Health 10-05 的官方博客:Nolla Derm 是一个 iOS App(每月 4.99 美元,犹他州 18 岁以上居民),流程是验证身份、知情同意、简短问卷、五个角度的人脸扫描,约 10 到 15 分钟出方案;AI 只能在预先批准的外用方案里选,“没有自由文本界面”,重度痤疮、孕期等超范围的转人类医生。监督分三段:前 100 名患者,两名执业医生各自独立批准每张处方;之后至多 500 名患者,AI 直接开方、医生事后至少每周审查每一例;最后每月至少抽审 10%,加上所有升级和副作用案例;晋级条件包括与医生 95% 一致、零严重不良事件、州书面批准。要打折扣的地方:“医生与 Nolla Derm 建议 96% 一致”“首个”都是公司自述;犹他州 AI 政策办公室的页面写明参加沙盒“does not mean the State of Utah has approved, endorsed, certified, or vouched for the product”,是沙盒豁免,不是州政府背书(SiliconANGLEMEDIA,它把这件事写成“续方”,与 Nolla 自己说的“初始处方,不只是续方”不符,以 Nolla 为准);州商务部的协议 PDF 本刊没读到。
联邦法官:Flock 摄像头网络是“无差别大规模监控”MEDIA法律 · 执法——10-03。俄克拉荷马州 Tulsa 的联邦法官 Sara Hill 裁定,一名副警长仅因车牌是加州牌照就无证查询 Flock 数据库,违反了第四修正案,之后搜出 91 磅冰毒的证据要作为“毒树之果”排除。原话:“It is a tool that collects information about all vehicles that pass by any network-connected camera at all times, and it serves up the information to law enforcement on demand.” 这不是有约束力的先例;AI 含量主要在车牌识别网络,不是模型本身。
Meshy 官方宣布 ARR 突破 1 亿美元:不到两年从 100 万美元涨了 100 倍,自称首家达到这个里程碑的 AI 3D 公司OFFICIAL背景 · 09-30——公司的 PR Newswire 稿(美东 09-30 11:00,北京 10-01 00:00)和官方 X 帖X写“annual recurring revenue (ARR) has surpassed US$100 million, up 100x from US$1 million in under two years”(年度经常性收入已超过 1 亿美元,不到两年从 100 万美元涨了 100 倍)。这是公司自己的数字,没有找到第三方核实。创始人胡渊鸣 10-07 的公众号文章《$1 亿美金 ARR,我的 48 条反思》(SELF,页面 10-08 有修改)比官方公告晚一周,是个人反思,不是独立信源,他写的“严格统计口径下”没有展开。公司 7 月 21 号的官方稿说近 4 亿美元 B 轮、投前估值 15 亿美元,当时只说 ARR 年增长约 12 倍,没给绝对值。a16z 10-05 的《Top 50 Consumer AI Apps by Monthly Revenue》OFFICIAL第 7 版把 Meshy 排在第 31 位(唯一上榜的 3D 公司,Meshy 官方帖转发),但这份榜单基于 YipitData 的美国消费者信用卡支出面板,原文写它“should not be read as total company revenue”(不应被当作公司总收入),别读成全球收入排名。胡渊鸣的文章里有三条可单独引用的反思(他个人的观点):#16“不好意思,我看不懂这篇 AI 写的报告,请你手动重写。”#18“AI不但没有拉平软件的门槛,反而让强者更强,弱者更弱了。”#22“某种意义上说,AGI 已经实现了,只是在各个领域分布不均而已。”同一篇里有一条和专题 01 同向:AI 在数学证明这类可以闭环验证的领域,可能给出“人类数学家知道能被 Lean 验证、却理解不了其内在逻辑”的结果——“验证便宜了、理解没便宜”;但他是在转述别人的推演,不是新证据,他对 Navier–Stokes 的“进展”措辞也和站内核实的结果不同。
做硬件研发 Agent 的 Flow Engineering 官宣 5,000 万美元 B 轮、估值 7.5 亿美元:Valor 与 Atreides 联合领投,Sequoia 跟投OFFICIAL背景 · 09-30——创始人 Pari Singh 09-30 的官方信写“co-led by Antonio Gracias (Valor Equity Partners) and Gavin Baker (Atreides Management)”(由 Valor 的 Gracias 和 Atreides 的 Baker 联合领投),另有新闻稿OFFICIAL。公众号深思圈 10-06 的整理里“美国红杉”其实是上一轮(A 轮)的领投方 Sequoia Capital,这轮是跟投,Roelof Botha 以个人身份加投并进了董事会(TechCrunchMEDIA);参投的个人还有 Hugging Face 的 Thomas Wolf、F1 世界冠军 Nico Rosberg、奔驰的 CIO。产品是硬件研发的“需求—设计—仿真—测试”连接图谱,官方 06-04 的 v3 发布文(Agents have reached hardwareOFFICIAL)写一处需求变更会沿图谱自动传到所有相关的预算、测试和接口文档。数字:新闻稿写 Rivian 内部用户七个月从 40 涨到 1,500;Pari 说“Ninety-six percent of our customers come to Flow inbound.”(96% 的客户主动上门),这些都是公司自述。“需求维护时间减 79%、测试覆盖三倍”在官方稿、信和官网页面里都没找到,仍只见于深思圈的整理(原文MEDIA),按未核处理。
Manus 母公司蝴蝶效应 10-08 官宣完成超 5 亿美元新一轮融资,博裕和 IDG 领投,腾讯、红杉中国(HSG)、真格跟投;估值没披露MEDIA——CNBC 写“the company did not disclose its post-funding valuation”(公司没披露融资后估值);Bloomberg 此前报道的 40 亿美元是媒体数字,没有被确认。这是 09-01 恢复独立运营、09-28 推出 Cue 之后的第一笔大额融资,CNBC 引 Eurasia Group 的分析师说 Meta 事件的短期冲击“has been contained”(已被控制住,分析师观点);公告经 CNBC、TechNodeMEDIA转述,本刊没读到微信公众号原文。融资稿里没有任何权限或默认设置的改动,Cue 的官方说明仍是 09-28 那份。
The Information 报道:微软和 Meta 在压缩员工内部使用 Anthropic 的开销,主因是成本和自研替代,不是安全限制MEDIA——10-05 的原报道出自 The Information,本刊读的是 Yahoo Finance 和 TheStreetMEDIA的转述(来源为匿名,没读到两家公司的公开表态):微软把内部使用 Anthropic 的年度预期从至少 10 亿美元下调了三分之一以上,云与 AI 部门个人月度用量上限多数从约 10 万美元降到约 1 万美元;Meta 内部 Claude Code 用户约从 6 万降到 3 万,部分因春季裁员,主因是推自家的 MetaCode 和 Muse Code。只涉及内部使用,据报道微软客户渠道的需求没变。Hacker News 上的标题写成“limit employee use”,读起来像安全限制,原文讲的是成本。
Anthropic 扩大 Claude Startups 计划:成立不满五年或近两年拿过融资的公司,可得一年 Claude Team(最多 5 个 Premium 席位)加 1,000 美元一次性 API 额度OFFICIAL——官方页 10-06:成员“up to $7,000 in Claude products and credits”(最多 7,000 美元的产品与额度),脚注算法是 5 个 Premium 席位按每席每月 $100、年付共 $6,000,加一次性 $1,000 API 额度,“实际价值取决于席位数量和类型”,额度适用 Anthropic 的补充额度条款;另有“Claude Startup Stack”,合作伙伴的折扣和额度“最多 4.5 万美元”,脚注写这是按合作方 2026 年 9 月标价算的各项最大值之和,“可能无法领取或叠加全部优惠”。还有 Anthropic 应用 AI 团队的线上答疑,以及帮成员做 Claude Marketplace 上架。同一周的 Max 和 Team 套餐 API 额度(见上面产品与模型)是另一条线,官方页没有说创业计划的席位算不算在里面,本刊不替它推算。放在专题 04 旁边看:OpenAI 往订阅用户收额度的同一周,Anthropic 往创业公司和订阅用户送额度,两家的补贴方向正好相反,但这是并列事实,不是因果。
纽约时报:Anthropic 一年来请几十位宗教学者闭门讨论“Claude 有没有意识”;10-03 Altman 发帖说对把宗教力量赋予 AI“非常不舒服”MEDIA背景 · 09-30——记者 Elizabeth Dias 采访了 20 位参与者和联合创始人 Chris Olah 本人(Inquirer 转载,页面标 09-30)。Olah 的说法是:“I don’t know. I’m genuinely uncertain.”(我不知道,我真的不确定);一位参与的拉比的观察是“They’re relating to it like a conscious being”(他们像对待有意识的存在那样对待它),这是参与者的观察,不是 Anthropic 的立场。Anthropic 发言人说,这些峰会的主要问题不是 Claude 会不会受苦,保密协议夏天已解除,Claude 没有参与选人。5 月 Olah 在梵蒂冈和教皇利奥十四世的通谕《Magnifica Humanitas》同台,NYT 引通谕写 AI“do not feel joy or pain”(不感受快乐或痛苦);据一位梵蒂冈组织者说,Olah 看到通谕全文后曾提议 Anthropic 退出活动,最后还是去了,两位参与者说他们私下劝教皇顾问认真对待 AI 有意识的可能,Anthropic 拒绝谈私下对话。NYT 还写 Anthropic 正准备发布更新版的 Claude 宪法(两位知情人,Anthropic 不评论)。Altman 10-03 14:18 UTC 在 X 上写:“I am very uncomfortable about people trying to ascribe religious force or a surrender of human judgment to AI models”(我对有人想赋予 AI 模型宗教般的力量、或把人的判断拱手让给它,非常不舒服),并说这是真正的安全问题(XX,10-08 读到约 700 万次查看)。他没有点 Anthropic 或 NYT 的名字,本刊不替他连这条线;把两者连起来的是转述帖,比如这条书签里的中文长帖,里面“约 15 名基督教领袖”之类的细节,本刊没在 NYT 里核到。可检验的挂点:Anthropic 是否在 10-16 前发布更新版 Claude 宪法。
算力与基础设施
zartbot:反对千卡以上超节点,并说 DeepSeek 开源的昇腾 950 组件用的超节点只有 128 卡SELF——他 10-05 在 GitHub 上发《On AI Infra for 10T parameters Models》(Issue #16):“I am therefore strongly opposed to supernodes with thousands of GPUs.”(因此我强烈反对千卡级别的超节点。)理由是超节点变大会拉长长尾延迟、整体 MTBF 急剧下降,光互连还会进一步拉低可靠性;他主张 ScaleUP 域的 Radix 取 128、最多 256。他还写“the Ascend 950 infrastructure components recently open-sourced by DeepSeek use supernodes of only 128 GPUs”(DeepSeek 最近开源的昇腾 950 组件用的超节点只有 128 卡)。他还写训练 10T 规模的模型“may require 200,000 GPUs for a single training job”(单个训练任务可能要 20 万块 GPU),主张 ScaleUP 域先用铜缆、限制在一两个机柜。这是个人观点,不是实测。“128 卡”我们回 DeepSeek 的 DeepEP-AscendGITHUB仓库(09-30 首发)核了:README 的性能表以 EP128 为最大一档,并写测的是“the supernode’s external Clos network”(超节点的外部 Clos 网络),量级和“128 卡”吻合;但两份 README 都没有明文写“超节点含 128 块卡”,所以只能算间接佐证,不能写成仓库证实。另一个细节:README 说这批带宽数字(EP8 约 373–375 GB/s,EP128 约 313–320 GB/s)是用提供给 DeepSeek 的概念验证开发套件加手工配置测的,不是尚未发布的商用版本(华为的商用套件计划 10 月 15 日前后放量)。zartbot 的中文原文本刊没找到。它不是 EP.105 专题 08 判据要的“千卡级预训练复现数据”,不推翻也不加强那条结论,只是一个独立评论者的补充。
10-06 才发布 beta,官方指南写“we expect to GA in the coming weeks”,目前只支持 gpt-6-luna(OpenAI 指南OFFICIAL)。同一周 Cloudflare、AWS、Perplexity 都在用同类接口,OpenAI 有抢节奏的动力,但官方自己写的是“几周”。
预测10 月 16 号前,OpenAI 不会让 Decisions API 正式 GA。
判定口径:若 10-16 前 OpenAI 官方指南、changelog 或博客宣布 Decisions API 正式可用(去掉 beta 标记),判断被推翻。