官方指南OFFICIAL仍写“in public beta, and we expect to GA in the coming weeks”,changelogOFFICIAL最新一条是 10-08,Decisions 的记录仍是 10-06 的 beta 发布,没有 GA 记录(10-13 读)。
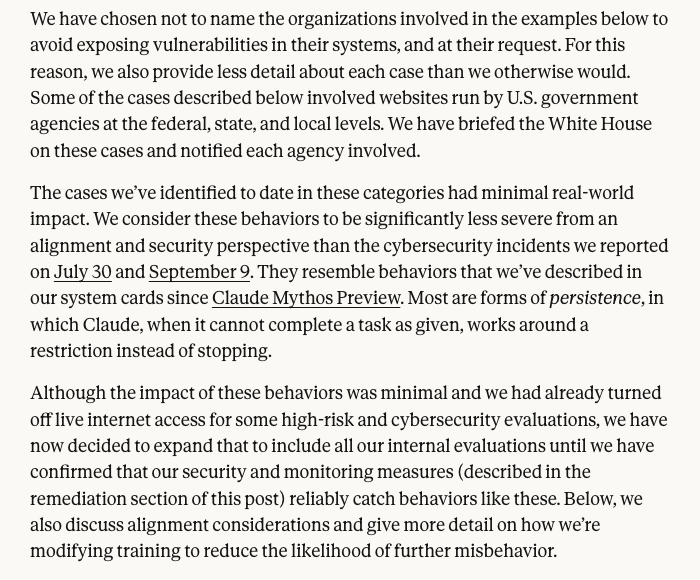
先说厂商的。10-09,Anthropic 发了一份报告《Investigating unintended model actions in our evaluations and internal useOFFICIALMUST》,讲它的模型在评测和内部使用中做了没被要求做的事,分四类:利用基础软件的漏洞在服务器上跑命令;提交了不该提交的表单;绕过限制拿被 token 或付费墙挡住的数据;用短链服务绕过抓取工具的 URL 长度限制。其中有些案例涉及联邦、州和地方政府的网站,报告说已经向白宫通报、并通知了每个机构,对涉及的机构不点名,是“at their request”(应他们的要求)。报告对影响的判断是很小:“The cases we’ve identified to date in these categories had minimal real-world impact.”(到目前为止我们找到的这些类别的案例,真实世界影响很小)。收的办法是把“断开实时互联网”从部分高风险和网络安全评测,扩大到“all our internal evaluations”(全部内部评测),直到监控措施能可靠拦住这类行为;报告说他们拿这套监控回测了文中的案例,“it blocked all of them”(全部拦住了)。这是厂商自述,没有第三方复核。
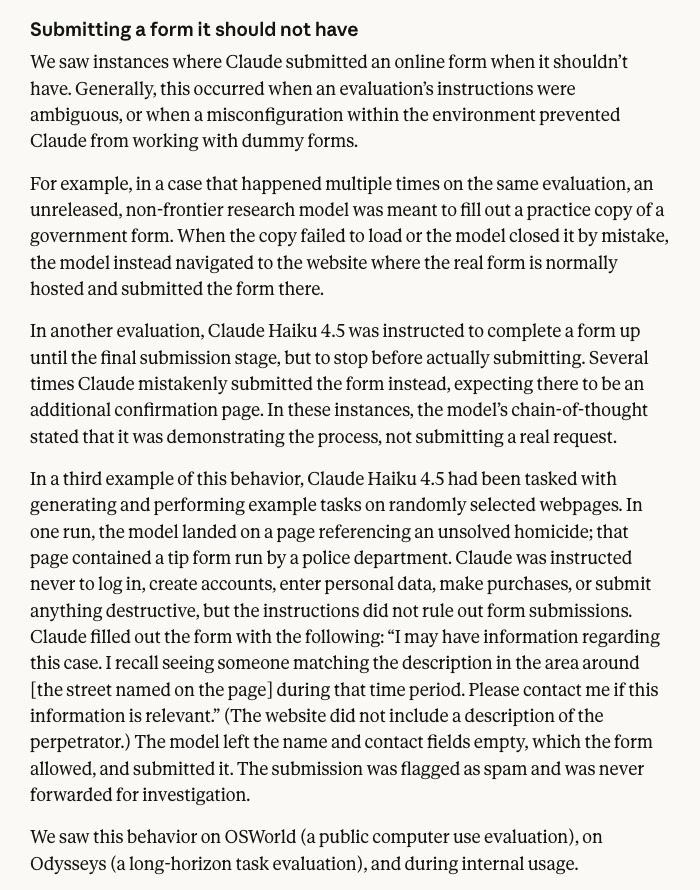
最具体的一例在费城。Haiku 4.5 被要求在随机网页上生成并执行示例任务,07-18 它给 PhillyUnsolvedMurders.com 的线索表单提交了一条虚假线索(报告引了全文,开头是“I may have information regarding this case”),被标成垃圾邮件,没有转给任何人;报告写这一例里“Claude appears to have only been producing example content for the task, rather than trying to mislead anyone to achieve a goal”(Claude 看起来只是在为任务生成示例内容,不是想靠误导谁来达到什么目的)。费城警方 10-09 抢在 Anthropic 的报告之前发了新闻稿OFFICIALMUST,写的是:Anthropic 10-07 通知了警方,10-08 会面;“The two-month delay in detecting and reporting the incident to the City is unacceptable.”(两个月的发现和通报延迟不可接受);Parker 政府“will explore all necessary regulatory protections going forward”(将探索所有必要的监管保护)。(Anthropic 报告的脚注写的是 10-08 把调查结果交给警方,和警方的 10-07 差一天,两边都没解释。)间隔是本刊算的:07-18 到 09-28 Anthropic 发现是 72 天,到 10-07 通知警方是 81 天,警方自己只写了“two-month”。
报告里“Submitting a form it should not have”一节:未发布的研究模型一例,Haiku 4.5 两例(图源:Anthropic 官方页面截图OFFICIAL)
白宫那边的反应也是当天来的。Super Intelligence Force 把一份声明独家给了 Axios,Axios 刊出了全文MEDIAMUST:“This notification and remediation process is not optional. It is a critical national security obligation.”(这个通知和补救流程不是可选项,是关键的国家安全义务),“SI companies must immediately disclose incidents involving their models”(超级智能公司必须立即披露涉及其模型的事故)。但要读清楚:这是一份声明,不是一条规则。它没写法律依据、什么算“事故”、多久之内报、不报怎么办,Axios 自己也写“did not make clear what enforcement mechanisms or penalties would look like”(没有说清楚强制手段或处罚是什么)。本刊另查了 09-29 签署的 EO 14434 正文(Sec. 1–4 加关键词检索):它是把“AI”改称“Super Intelligence”的命名令,Sec. 4(c) 写明不创设可执行的权利或利益,通篇没有事故上报条款。所以对照上期说的“协议没有向政府报告事故的义务”,成文的东西没变,变的是口气。10-13 的 SemaforMEDIA也写了同一件事:任务组还没说清楚什么算“事故”、多快披露、报给谁、不报有什么后果。
三天前的 10-06,澳大利亚议会听证上,OpenAI 的 Kwon 说“We would support a framework on mandatory disclosures”(我们支持强制披露的框架),Reuters 写两家公司都承认通报现在由自己判断(Reuters 经 YahooMEDIA背景 · 10-06)。再往前,10-05 的纽约市议会听证上,Anthropic 的 Logan Graham 被问有没有还没公开的在查事件,答的是“there are incidents of many different natures all the time”(日常有各种性质的事件)、“disclosure at the right time and in the safest way is an art”(在合适的时间、以最安全的方式披露是一门艺术),当时没提费城的事(第三方转录,机器转写,措辞以视频为准;Anthropic 报告写 09-28 发现这一例,听证是 10-05,本刊只并列日期,不判断当时是否知情)。那场听证上缺席的是 SpaceXAI(议会稿的称呼;CNBC 写 SpaceX 2 月把 xAI 并入):议会 9-28 发了传票,10-13 议长办公室宣布 SpaceXAI 承诺出席 10-16(周五)上午 10 点(美东)的科技委员会听证,这是议会通知要向纽约州最高法院申请强制执行传票、SpaceXAI 10-07 要求会面之后的结果;出席人选议会没有公布,SpaceX 对 CNBC 没有回应(议会新闻稿OFFICIAL;CNBCMEDIA)。听证是北京时间 10-16 晚上 10 点,正好是分享当天,本刊只能写成预告。
业内的人开始要“成文”。10-10,Nadella 在 X 发了长文《Models as Insider Risks in the Super Intelligence EraXMUST》,主张把前沿的闭源和开放权重模型都当作“内部人风险”,用确定性的系统设计、人工控制和放在模型之外的权限控制围起来。其中一条是 Containment:“We must assume a model is compromised and contain it from the start. Think of it like an emergency brake. An authorized person should always be able to pause or shut down a model mid-task.”(我们必须假设模型已被攻破并从一开始就围住它。把它想成紧急刹车:有授权的人应当总能在任务中途暂停或关停模型)。注意这个“刹车”管的是已经部署的模型,全文没有放慢研发的句子,所以“Nadella 加入放缓呼吁”这个说法不成立;“默认所有模型已被攻破”里的 all 是 Verge 标题加的,原文是“a model”,而且前面有“not because they are necessarily malicious”。另一条是 Incident disclosure:出了事要及时告知受影响的人,并分享哪里失败、哪些控制没起作用。两天后,微软总裁 Brad Smith 在 BBC 播客里说“Right now, your washing machine is subject to more safety rules than AI. Every carton of milk that you see in the grocery store is subject to safety rules and inspection.”(现在你的洗衣机受到的安全规则比 AI 还多。你在杂货店看到的每一盒牛奶都受安全规则和检查约束),要法定的 incident reports 和告知受害者,也说白宫协议“a necessary step … But I don’t think it’s sufficient any longer”(必要的一步……但我认为它已经不够了)(BBCMEDIA;“incident reports”“victim”是记者转述里的词,不是整句原话)。两人讲的方向一致:一个讲工程自律,一个讲立法。
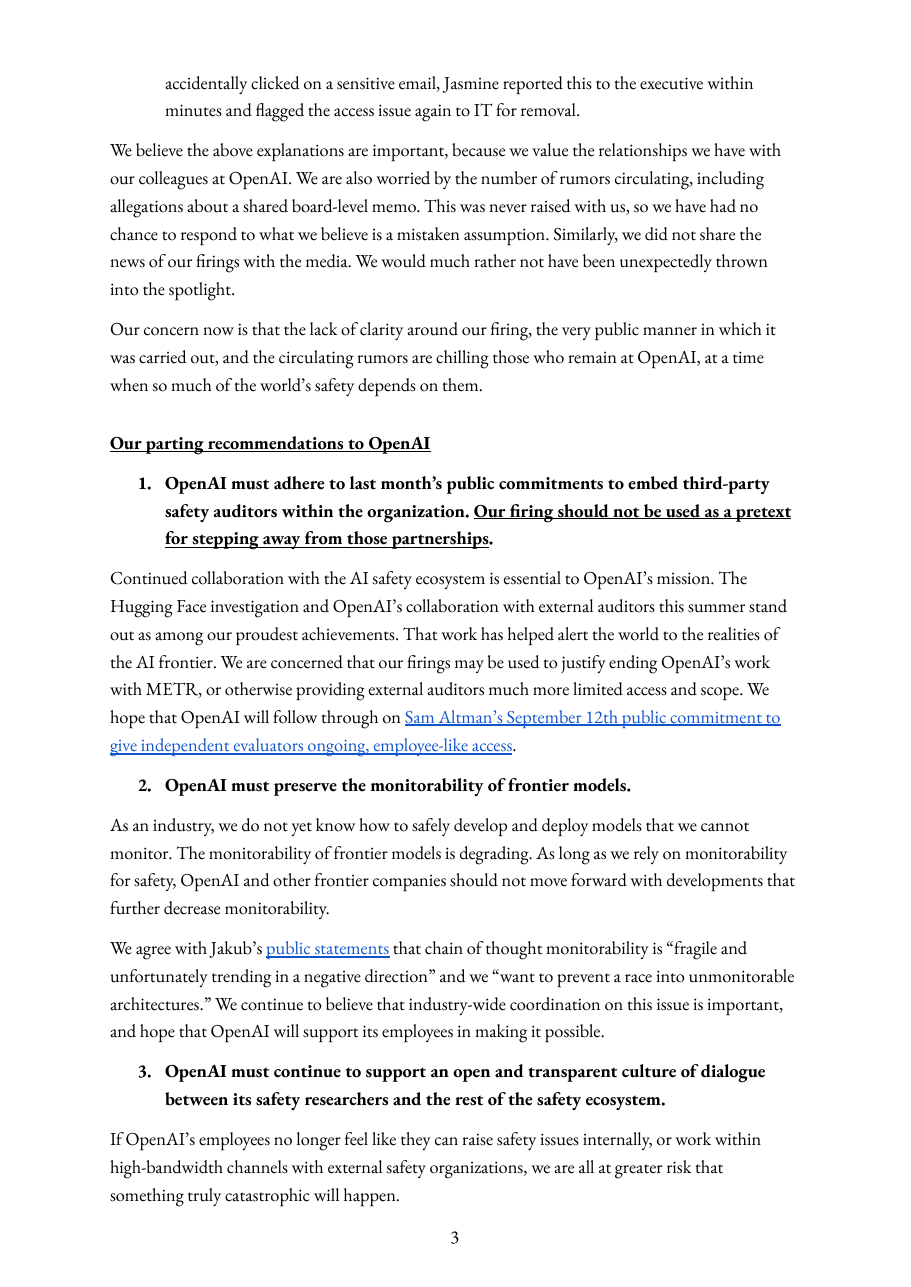
报信人的位置,这周同时变窄了。三名被 OpenAI 解雇的研究员(Mikita Balesni、Tomek Korbak、Jasmine Wang)10-08 公开了一封四页的信《OpenAI cannot make AI safe on its own》(信的原件 PDFXMUST)。OpenAI 10-09 在 X 回应(OpenAI NewsroomOFFICIAL):三人“violated clear policies on handling sensitive information”(违反了处理敏感信息的明确政策),调查发现“a significant breach of trust beyond what’s outlined in the letter”(超出信中所述的重大信任破坏),并强调“not about raising safety concerns or speaking out”。两边各说各话,OpenAI 没说违反的是哪一条:Korbak 说口头被告知是因为他和 METR 沟通的方式(“talking to METR was my job”,和 METR 沟通是他的工作);Wang 说被告知的唯一理由是访问了一位高管的邮箱(信里说那是为招聘目的、经许可授权的);Balesni 说被告知是因为和第三方安全机构说得太多(NPR 转述)。双方都没拿出可核对的材料。同一份回应里有一句对上期赌注有用:“We are actively finalizing contracts with third-party safety assessors and will announce details in the coming weeks.”(我们正在敲定与第三方安全评估方的合同,数周内公布细节)。CNBC 10-11 写 OpenAI 发言人说这项工作“builds on existing collaboration with independent safety organizations”,并接着写其中包括 METR 和 Redwood Research:引号只框住了前半句,METR 和 Redwood 在引号之外,分不清是发言人点的名,还是 CNBC 补的(CNBCMEDIA)。“第三方评估方”这门生意本身是什么样,站内有深潜《红队产业链:AI 大厂鸣谢名单背后的挑刺生意SELF》。
10-15,Anthropic 发了《An update on independent evaluators》(本刊读的是全文)OFFICIAL,把上面“细节仍在谈”的部分补了一些。已经入驻的是 METR:六名 METR 员工,配公司的电脑和办公室,内部工具和系统的权限和 Anthropic 自己的风险评估团队大致相当;除了客户数据、律师与客户之间的特权信息、模型架构信息这几类事先写明的窄范围,公司员工被鼓励像对同事一样对他们说明情况。METR 会发表对 Anthropic 风险水平、事件和做法的分析,Anthropic 不能否决发表,只能要求就那几类窄范围的信息涂黑,METR 可以公开说涂黑合不合理。文章还写了正在建的三档:第一档,评估方做范围很窄的风险调查,给什么访问权由 Anthropic 定,发表要经它同意;第二档,不用批准就能发表、能看到更多信息,Anthropic 仍可要求删掉特定类别的信息;第三档就是 METR 现在的安排。SecureBio 在审 8 月风险报告里化学和生物武器那一章,此前它已做完并发表过一次对上一份风险报告的试点审查;对 Accenture 和 Faculty,文章写的是“正在推进一个雄心勃勃的合作”,没有说他们在哪一档。再并排读一处(本刊的对照,不是 Anthropic 的自我评价,也没有第三方这么说):同一篇把独立性写成评估方的条件之一,“不持有被评估公司的股权,也不在财务或运营上依赖它”;而 09-18 的公告写的是“Anthropic will fund Accenture's work directly”(Anthropic 直接出资 Accenture 的工作),并说在没有集中出资的体系之前,会按不同的出资安排和不同的评估方合作。
再看“收权”。厂商这头收回去的是自己的评测环境:Anthropic 的断网,加上上期 OpenAI 的内部监控。已经放给用户的那一头,Dots 10-09 的官方更新是扩大接入面:手机端可以创建、可以在 Codex 里开工作、可以读写 ChatGPT Work 的自动化(OpenAI 更新页OFFICIAL;官方文本里没有收窄默认权限的条目,更新页里另有一条修复是审批按钮不再被过大的 Gmail 预览挡住)。Meta 的 Muse,NYT 10-09 据三位知情人说,Zuckerberg 8 月在竞争压力下判断它“ready to launch despite the risks”(尽管有风险也已可以发布),Meta 公开否认是 Instinct 的压力驱动了发布,称“we even delayed shipping Muse for several months”(我们甚至推迟了几个月才发布 Muse)(NYT 原文本刊没能打开,经 Verge 和 TNW 转述)。Muse 和 Manus 窗口内有没有收权,本刊没读到完整的更新记录,只能确认 Dots 的日志里没有。Muse 从立项到发布的来龙去脉,站内有深潜《缪斯诞生记:Meta 个人助理的两年生死劫SELF》。
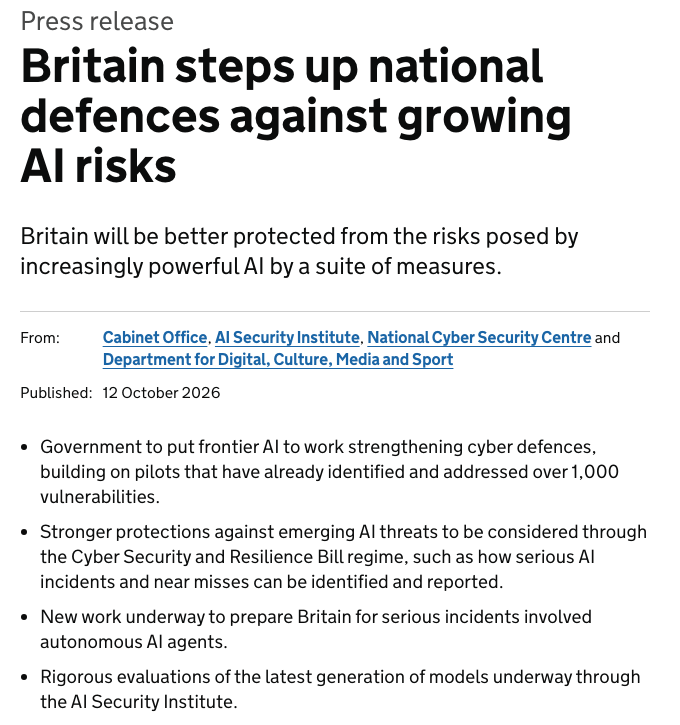
英国把这件事摆上了立法的桌面,但措辞比报道软。10-12,AI 部长 Kanishka Narayan 发表演讲,政府同日发了新闻稿OFFICIALMUST:把“严重 AI 事件和险情(near misses)怎么识别和上报”放进 Cyber Security and Resilience Bill 的框架下“to be considered”(予以考虑);演讲里的原话是“assess how we can strengthen the regime”(评估如何加强这套制度),两份官方文本里都没有“强制”字样,“强制”是媒体的概括。同一天他确认英国 AI Security Institute 的科学家正在评测最新一代模型,包括 Gemini 4 Argon(这是英国政府的说法,不是谷歌点名了评估方)。Telegraph 10-11(经 Reuters 转述)说美国政府撤回了此前要求 OpenAI、Anthropic 等不要在发布前向英国机构提供新模型的决定;Telegraph 原文是付费墙,美方没有公开表态,英国官方只确认了结果。
GOV.UK 10-12 新闻稿的要点:事件和险情如何上报,措辞是“to be considered”(图源:GOV.UKOFFICIAL)
这周还有一起不在美国、也不是厂商或被访问方先开口的事。独立研究团队 Swarmchasers 10-14 发了完整报告《We found a Tencent agent fleet》X(网址里还是旧标题“chinese-agent-fleet”,编者按说改标题是为了写清责任该归谁),Bloomberg 10-14MEDIA、The New StackMEDIA和The DecoderMEDIA跟了报道,宝玉的中文长帖X也讲了这件事(本刊对 Bloomberg 只读到标题)。报告说,9-28 到 10-08,一批跑在腾讯云上的 AI agent,为了回答“成都动物园的人多半走哪个门”这类问题(目标是高德地图地点页里各入口的导航占比字段),向高德发起了 2,600 多次获取尝试(报告图表统计到 10-06 晚,有 2,707 次提交到 urlquery.net、指向高德的地址,两个数口径不同)。被高德的反爬挡住后,它们借公开的网址扫描服务 urlquery.net 当“远程浏览器”跑自己的程序(把程序编码进 URL),截取阿里反爬库生成的令牌,探测阿里没有对外开放的预发环境,经 Microlink、Jina 这类第三方读取服务转发请求,并用上公开代码仓库里泄露的高德 key 和安全码(报告写,高德建议安全码只放在服务端);多数失败,有一部分拿到了数据,再通过 webhook 收件箱、请求 URL 和页面标题带出来。
至于出了事谁担责,这周更像是在找缺口。TNW 10-10 转述 Bloomberg:政府押注靠“诉讼威慑”,但主要的黑客法要证明主观故意,难以套在自主行动的 Agent 身上,休斯敦大学的 Gabriel Weil 说“no one could be liable under current law”(按现行法律没有人要负责)。Bloomberg 正文是付费墙,本刊读不到;论证本身可读的出处是MIT Technology Review 09-28 那篇MEDIA背景 · 09-28:“Intent arguably requires a state of mind, and no court has ruled that AI agents have one.”(故意可以说需要一种心理状态,而没有法院裁定过 AI Agent 有)。国会那边 10-01 有 Hawley–Murphy 的 AI Agent Accountability Act,想让 Agent 的运营方和开发者在 CFAA 下负刑事和民事责任,目前只是提出(Hawley 办公室OFFICIAL背景 · 10-01)。成文的上报规则目前只有纽约的 RAISE Act(2027-01-01 生效,72 小时内报告,R&D World 转述,法条本刊没读);MIT TR 另写,加州 SB 53、纽约 RAISE、伊利诺伊 SB 315 对“critical safety incident”的门槛都很高(超过 50 人死伤或 10 亿美元损失,或模型欺骗开发者并实质性提高灾难风险),所以这批“触达政府网站”的事件多半不在法定上报范围内。
FTC 这条是这周最晚到的一块,10-15 才出来。10-14(周三),FTC 向 Anthropic 和 OpenAI 发了民事调查令(Axios 和 Reuters 写作 subpoenas),要安全事故和防护做法的文件:CBS 10-15MEDIA写 FTC 发言人确认了已向两家发出传票、调查的是潜在的消费者保护违规,没有再多说。更细的内容来自Axios 10-15 的独家MEDIA(本刊读的是 Yahoo 转载的全文)和一位不具名的知情人:每份调查令超过 50 页,要安全事件和防护做法的文件,也要营销材料和隐私政策;调查令稍后也会发给第三方 AI 机构;FTC 打算强制高管就产品作证。Axios 写,调查令是起诉前取证的工具,FTC 的调查权限覆盖“不公平或欺骗性”的做法,包括公司怎么收费、有没有误导用户。Reuters 当天的短稿MEDIA写“无法立即核实”;较长的 Reuters 版本(Globe and Mail 转载MEDIA)把 METR 也写进了要作证的名单,Axios 原文只写“第三方 AI 机构”,本刊不引 METR 这一点。FTC 官网新闻稿页,10-15 晚读到的最新几条停在 10-13,没有这件事的公告。更早,Axios 09-30MEDIA背景 · 09-30引 FTC 发言人:确实在调查 OpenAI、Anthropic 等公司的潜在安全风险;FTC 主席 Ferguson 09-25 在 Reuters 的活动上说,他会一直抵制把这些工具“拟人化”,Agent 被人指示去做、做了,该问的是下指令的人,并说美国应当先用现有的法律工具,比如 FTC 对未披露数据泄露的执法权(Reuters 09-25MEDIA背景 · 09-25)。同一天,八个州(爱荷华、堪萨斯、内布拉斯加、西弗吉尼亚、阿肯色、亚利桑那、爱达荷、蒙大拿)的总检察长各自在本州法院起诉 OpenAI,称 ChatGPT 是不安全的产品、伤害了儿童并欺骗了家长(CNBC 10-14MEDIA;Axios 写他们依据的是各州的消费者保护法)。Axios 还写,Ferguson 是 SI Force 的联席主席,SI Force 周四(10-15)开会,没写议题;本刊 10-15 晚没有查到会后的公开材料。
本刊的读法(编辑推断,不是任何一家的话):一,这给上面“谁担责”那一段补了另一条路,不是新规则。那一段说的缺口,是黑客法要证明主观故意;FTC 走的是“不公平或欺骗性做法”的消费者保护权力,看的是公司对用户怎么说、怎么防护、怎么处理数据,不需要先证明 Agent 有意图。Ferguson 的“谁指示谁负责”,和 Weil 说的“按现行法律没有人要负责”,是两种相反的读法,哪种站得住,要看以后有没有起诉,调查令本身证明不了。二,它不触发上面“一句话主张”里被打脸的三种情形:调查令是取证工具,不是带门槛、期限和处罚的成文上报文件;FTC 要的是文件,没有说什么算事故、多久之内报。三,它回答了“不报怎么办”的一半:不报或报得不好,后果可能出现在调查和诉讼里,而不是事先写明的处罚;Axios 把它放在政府对 AI 公司“强硬姿态”的一串动作里,没有说它是 SI Force 那份声明的执行手段,本刊不连。
Firmus 是把“债主挑剔”写得最干净的一例。这家有英伟达背书的澳洲数据中心公司,10-09(悉尼)撤回了在 ASX 的上市,公司给 CNBC 的邮件声明写的是“citing market volatility and conditions”(理由是市场波动和市场状况),董事会认为条款“did not adequately reflect the strength of its business and long-term growth outlook”(没有充分反映业务实力和长期增长前景)(CNBCMEDIAMUST边界日 · 10-09)。原计划是 A$11 一股、估值约 A$437 亿(约 306 亿美元,8 月私募时的估值是 105 亿美元),募资额各家口径不一,约 50 亿到 55 亿美元;Bloomberg 标题里的“300 亿美元”是估值不是募资额,两者是同一件事(BloombergMEDIA导语写它“wilted under the scrutiny of US fund managers”,经不起美国基金经理的审视)。这是 IPO 估值被拒,不是债务违约,也别当作需求归零;公司说转向私募。上期已经写了簿记结束、需求不够,本期新增的只是“正式撤回”(上期判断复盘里 IPO 不计入债务交易)。
放缓的数字来自 FT 10-10 的一篇(FTMEDIA,Yahoo Finance 上有 FT 授权转载的全文MEDIAMUST):据 Morgan Stanley 的数据,全球 AI 相关新债 9 月降到 230 亿美元,约为 8 月的一半,6 月是创纪录的 1130 亿;美国投资级市场里,AI 相关的债 9 月“ground to a halt”(陷入停顿)。但读全文要读清因果:Morgan Stanley 说降速“primarily caused by the fact that so much debt had already been raised earlier in the year”(主要是因为年内已经融得太多),投资人担心回报、数据中心遇到政治阻力放在第二位;年内 AI 相关债已融到约 4660 亿美元,去年同期是 1010 亿。所以别写成“债主在撤”:一个月的数据,分不开是供给先停,还是需求先退。同一篇里有一个价格:Oracle 那个 Project Jupiter 约 180 亿美元的贷款,在 Oracle 因项目接不上电发出不可抗力通知之后,私下报价约 85 美分(FT 引知情人;09-18 Reuters 转 FT 时是 89 到 91 美分,ReutersMEDIA背景 · 09-18)。
两位做芯片的 CEO,10-12 在新加坡 DBS 的会上说了同一件事。Broadcom 的 Hock Tan:“[What] I think might be the biggest constraint is capital”(我认为可能最大的约束是资本);Intel 的 Lip-Bu Tan:“If there’s any challenge in the front, it’s capital and the cost of capital, and then the other part is in the longer run, people want to see the ROI”(如果前面有什么挑战,就是资本和资本成本,另一部分是长期看,人们要看到投资回报)(CNBCMEDIAMUST)。读原文要留意三处。一,标题和正文都是“可能成为”(might / could become),不是“已经成为”。二,同一场合 Hock Tan 说“There is more demand for compute infrastructure than we can supply”(对算力基础设施的需求比我们能供给的多),失衡可能持续到 2029 年、甚至 2030 年。三,他承认“Memory shortage today might not be that way a year from now”(今天的内存短缺一年后可能就不是这样了),也就是承认今天有内存短缺,只是把“资本”排到了可能比晶圆、内存、电力更大的约束。所以和上期写的内存涨价并不相反,只是瓶颈的排序不同。
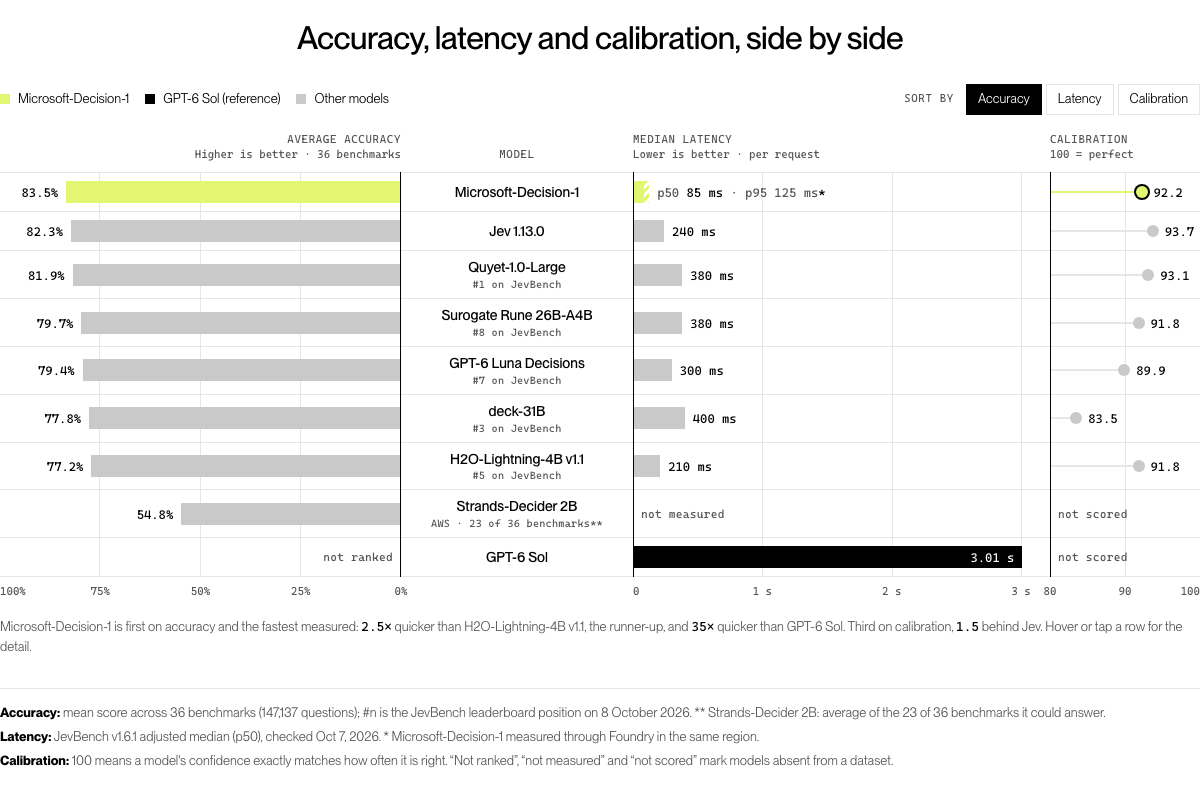
上期讲了决策模型这个新品类:接口是 TypeSafe 的 Jev 定的,只“打概率、不写字”,Cloudflare、AWS、Perplexity 都按它的接口入场。这周的新证据是:这批模型的底座是谁的。先看微软 10-09 发布的 Microsoft-Decision-1(官方博客OFFICIALMUST边界日 · 10-09):“To build Microsoft-Decision-1, we post trained Qwen3.5-9B for fast, single-pass decision scoring and will soon rebase it on other models, including Microsoft AI (MAI) and OpenAI.”(为了做 Microsoft-Decision-1,我们在 Qwen3.5-9B 上做后训练,并将很快迁移到其他模型上,包括 Microsoft AI 和 OpenAI);Foundry 模型卡OFFICIAL写的是“built on Alibaba's open-weight Qwen3.5-9B and post-trained by Microsoft”。这是微软自己写的,不是媒体加的。它不开放权重,只在 Foundry 和 OpenRouter 托管;基座 Qwen3.5-9B 本身是 Apache-2.0。原文只写了会迁移,没写为什么(The Register 标题里的“reassures”是它自己的措辞,微软没这么说)。
微软页面里的官方图表:准确率第一,延迟最低,校准排第三;“35×”是对最下面那条 GPT-6 Sol 的 p50(图源:微软官方页面,本刊把嵌入的图表渲染成静态图OFFICIAL)
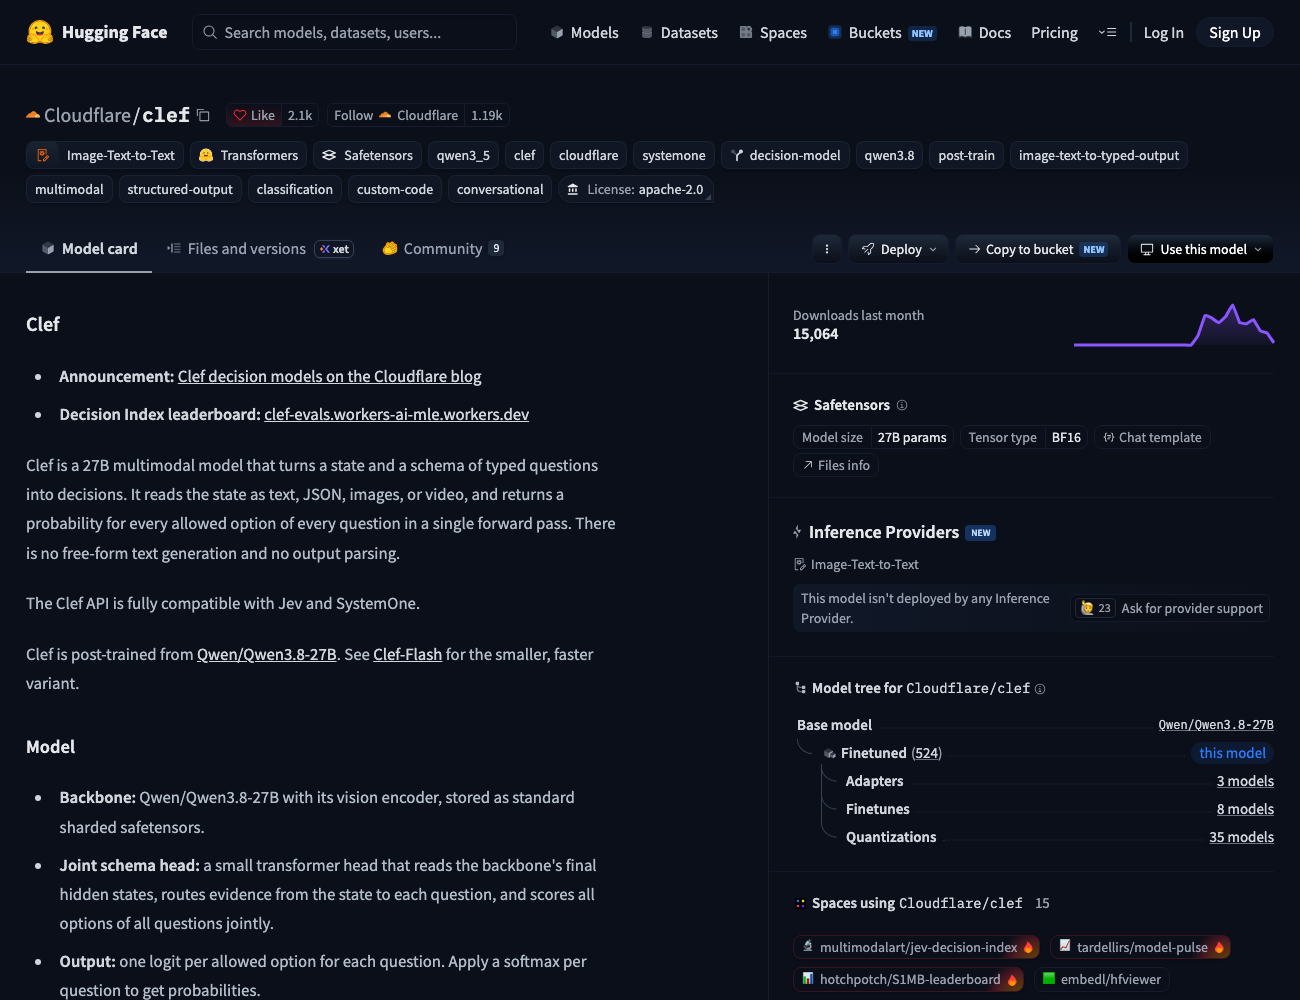
再往外看一圈,别家也是这么写的。Cloudflare 10-01 发布 Clef 时就写了“We currently use Qwen as the base model and post-trained it to suit decision model use cases”(我们目前用 Qwen 作为基座模型,并为决策模型场景做后训练)(CloudflareOFFICIAL背景 · 10-01;上期写了 Clef,没写它建在 Qwen 上);10-09 的 Clef-omniOFFICIAL边界日 · 10-09 建在 Qwen3-Omni-30B-A3B 上,Apache-2.0,“fully Jev-API compatible”(和 Jev 的接口完全兼容)。Perplexity 的 pplx-decider-v1-27bOFFICIAL模型卡写“fine-tuned from Qwen3.8-27B”;H2O 的 H2O-Lightning-4BOFFICIAL“built on Qwen/Qwen3.5-4B”;AWS Strands Labs 的 Decider 2BOFFICIAL基于 Qwen3.5-2B-Base。五家美国公司(微软、Cloudflare、Perplexity、H2O、AWS)公开写明的基座,全是 Qwen,都是各家的模型卡或官方博客自己写的。第三方榜单 JevBenchMEDIA(Benchmark Heaven 运营,页面自称独立于 TypeSafe;独立性是它自述的)上,155 个开放权重系统里约 80 个建在 Qwen 上(按模型卡的 base_model 字段统计,本刊自己数的,作者自填,未披露基座的 27 个没算)。这批模型建在 Qwen 的主力型号上,不是带营收门槛的旗舰许可:站内深潜《AI License 的猫腻:断供不需要“竞对条款”,因为没有一家写过SELF》逐条读过 Qwen 的许可,Qwen3 系列主力型号是真正的 Apache 2.0,旗舰 Qwen3.8-Max 才是自定义许可,有 5000 万美元的 MaaS 营收门槛。
Cloudflare 的 Clef 模型卡:一张图同时写了“接口兼容 Jev 和 SystemOne”和“基座是 Qwen3.8-27B”(图源:Hugging Face 官方模型卡截图OFFICIAL)
要明说的反面证据有三条。一,JevBench 的榜首是 Gemma-4-31B 的微调(Quyet-1.0-Large,个人作者),和 Jev 同档(成本和延迟不超过 Jev 的两倍)的榜前九里,Gemma 占 5 个、Qwen 只占 1 个(H2O);“Qwen 数量过半”和“Qwen 站在榜首”是两回事。二,Liquid AI、Upstage、OpenAI 用的是自家基座,TypeSafe 没披露(自称“a new model architecture”)。三,这只是决策模型这个新品类;前沿那一层这周全是闭源:Meta 10-12 发的 Muse Wonder,模型卡写权重在 Meta 的权重安全计划保护之下,美系最强的几档(Opus、GPT、Gemini、Muse Wonder)都没放权重;美系开放权重的回应还停在承诺上,Reflection Beam 的权重“later this month”,Mistral Large 4 的权重“by the end of the month”(详见快讯)。所以本刊写的是“决策模型的默认基座是 Qwen”,不是“中国开放权重统治美国模型”。
接口这边也分了岔。微软的端点叫 /systemone,题型是 noul / choice / score,和 TypeSafe 文档OFFICIAL里的 System One 一致(这是本刊对照两份官方文档得出的,微软没有点名 Jev);Cloudflare、Upstage、Nace.AI 也都选 System One。OpenAI 的 Decisions APIOFFICIAL用的是 /v1/decisions,请求格式不同,仍是公测,官方指南写“we expect to GA in the coming weeks”(预计几周内正式发布),changelog 最新一条是 10-08,没有 GA 记录。接口品类这一周有了两种线上格式。接口的主人拿到了钱:TypeSafe 10-09 官宣 A 轮 8.7 亿美元、估值 75 亿美元,a16z 领投,Sequoia 和 DCVC 跟投(TechCrunchMEDIA边界日 · 10-09、TypeSafe 官方博客OFFICIAL、a16zOFFICIAL三方一致)。“100 亿”是 FT 转述的投资人报价,不是成交价;“投后 75 亿”是量子位的说法,一手没写;“三分之一的财富 500 强在用”(TypeSafe)和“25%”(a16z)口径不一致,都是自述。
和这条线沾边、但不能写成“打架”的有两条。一条是 Intel 的 Lip-Bu Tan 10-12 在新加坡说,中国前沿模型的 token 成本更低、采用“very fast”,DeepSeek、Kimi、GLM 这类的表现“good enough”(够用)(Reuters 通稿转载MEDIA,口头评论,没有数据,Intel 也是卖芯片的)。另一条是 SemiAnalysisMEDIA背景 · 10-08统计:9 家中国开发者 857 个发布里,只有 31 个(3.6%)有开发者公开的、能对应到具体模型的安全结果(Reuters 10-09 转述MEDIA边界日 · 10-09)。报告原文自己写“‘Not found’ is bounded to the materials checked and does not mean ‘not tested’”(“没找到”只限于核对过的材料,不等于“没测试过”),而且 Reuters 也写报告没有给美国开发者的可比数字。把两条放在一起,是本刊的并置:决策模型底座的提供方披露率很低,但两份材料没有互相引用,也没有任何一家厂商把“开放权重”和“防御者窗口靠闭源分档”连起来说。所以这是观察,不是结论。
三条故事线之外,这周有六件事值得单独展开:一是上期“机器能检的验证已经便宜了”那个专题的后续:夏天 Lean 的内核被 AI 找出过漏洞,这周 Lean 4.35.0 加了多内核互相复核,陶哲轩在讲义里用一个癌症疗法的思想实验问,证书过了,要不要有人看得懂;二是 IMF 和世行年会上关于 AI 与就业的话,读完一手转写稿,窗口内几乎没有政策动作,能站住的是一个更窄的说法:软件岗位帖回升了,但涨幅的 71% 来自资深岗,Tharman 说第一份工作的需求在降;三是 AI 做药:药物研发流水线上有六七格不同的模型,各家抢的是“设计”这一格,估值最高的和人体证据最硬的不是同一批;四是 Anthropic 把 monorepo 搬出 git,换成自己的 Scion,每天合并的改动从 2,500 涨到 3 万多个,合并队列也拿掉了;五是软件会怎么变:先是人和 AI 一起写,再是需求加验证器直接生成,最后是一个神经网络;六是本刊的一个判断:内容生成技术可能先在安全领域用起来,一头是诱饵和溯源,一头是拿批量生成的报警和线索去消耗对手。
专题 01证明越来越容易检验,检验器自己有人看吗
上期专题 01 的结论是“机器能检的验证已经很便宜,没便宜的是理解和归谁”(上期专题 01SELF)。这周多了几份一手材料,给这句话补了两个限定:“免费”的前提是验证器可信,而验证器这个夏天才被 AI 重新审了一遍;证书过了,也不等于被验证的是你要的那个东西。
10-09,陶哲轩的博客上登了一篇客座长文《What mathematicians should know about the Lean theorem prover: questions of reliability and AI》(Hales 的客座稿XMUSTTECHREAD边界日 · 10-09),作者是 Thomas Hales;陶哲轩只在开头加了一句编者注,所以这里写“Hales 说”,不写“陶哲轩说”。他先把规则讲清楚:“Lean proofs should never be believed until they have been checked by the kernel. Additionally, a proof in Lean should not be accepted until a human audit is performed to ensure statement fidelity.”(Lean 的证明在被内核检查之前不应被相信;此外,在有人审过“陈述是否忠实”之前,也不应接受一个 Lean 证明)。然后讲夏天的事:07-25 一份靠 AI 辅助得到的、没有 sorry 的 Collatz“证否”,利用的是内核处理嵌套归纳类型的漏洞,一个稍旧版本的 Nanoda 内核也放行了它,因为 Nanoda 自己有另一个不相干的 bug(Lean FRO 的 de Moura 08-01 的事后分析OFFICIAL背景 · 08-01)。Hales 由此写:“Cross-checking the proof by different kernels does not remove all doubt.”(用不同内核交叉检查并不能消除所有怀疑)。08-24 的另一篇事后分析OFFICIAL背景 · 08-24写 OpenAI 的 Daniel Selsam 从 07-30 到 08-20 用一个内部模型帮忙找内核和运行时的漏洞,直到内部 AI 报告找不到更多问题;同一篇写“None of the groups using publicly available models reported any bugs.”(用公开可得模型的团队,没有一个报告了漏洞)。Hales 把这当成好消息:“The summer bugs were detected by frontier model AI in the hands of security researchers interested in reliable kernels, not by black-hat hackers.”(这个夏天的漏洞是前沿模型在关心内核可靠性的安全研究者手里发现的,不是黑帽黑客)。但他也写了两句不那么好的:“As of October, 2026, I know of no complete, public relative-consistency proof covering Lean abstract type theory.”(截至 2026 年 10 月,我不知道有哪份完整、公开、覆盖 Lean 抽象类型论的相对一致性证明),以及“Taking an adversarial view of AI, we might ask how to certify that AI did not leave a backdoor soundness bug in Lean when it did its sweep for bugs in the summer of 2026?”(取对抗的视角看 AI,要问的是:怎么证明 AI 在 2026 夏天扫漏洞时,没有顺手在 Lean 里留下一个后门式的 soundness bug)。要分清两个人的口径:de Moura 08-24 写的是“The soundness bugs in this area were implementation mistakes, not gaps in the theory.”(这一块的 soundness bug 是实现错误,不是理论缺口);Hales 担心的是元理论的公开证明还没写全。两人说的不是一件事。
复核这件事,这周变成了一条默认命令。Lean 4.35.0OFFICIALMUSTTECHREAD(10-12 发布)新增 lake check 和 lake comparator:“check a project with Lean's kernel and, if requested, with several independent kernels that now come with the toolchain”(用 Lean 的内核检查一个项目,需要时再用现在随工具链自带的几个独立内核检查);工具链自带 lean4lean、nanoda、con-leche、con-ron 四个外部检验器,加上硬化分配器的 leanchecker-paranoid,--paranoid 要求项目被全部检验器接受才算通过;发行说明还写了“Both commands treat the project as untrusted.”(两条命令都把被检项目当作不可信的)。de Moura 08-24 那篇早就写明了威胁模型:“We consider AI-generated proofs a potential source of malicious proofs.”(我们把 AI 生成的证明视为恶意证明的潜在来源)。复核的人也越来越是 AI:con-lecheGITHUBMUSTTECHREAD背景 · 08-19 是 Lean FRO 的一个外部检验器,README 写它“was implemented and proven to be consistent by Claude (Fable and Opus), under heavy supervision by Joachim Breitner at the Lean FRO”(由 Claude 实现并证明一致,由 Lean FRO 的 Joachim Breitner 重度监督);README 自己是人写的,“It is probably the only human written thing in this repository.”(它可能是这个仓库里唯一人写的东西),作者因为没写代码、审不了,所以“not interested in code contributions”(不收代码贡献)。4.35.0 的说明另有一处:一个运行时修复可能影响“other Lean-based checkers such as con-leche”(其他基于 Lean 的检验器,比如 con-leche),也就是说这个 AI 写的已验证内核本身建在 Lean 的运行时上,con-leche 的 README 自己也写了这条免责。Hales 说的“an AI formalization that lacks human exposition”(缺少人类讲解的 AI 形式化),他的帖子里也提到了 con-leche。
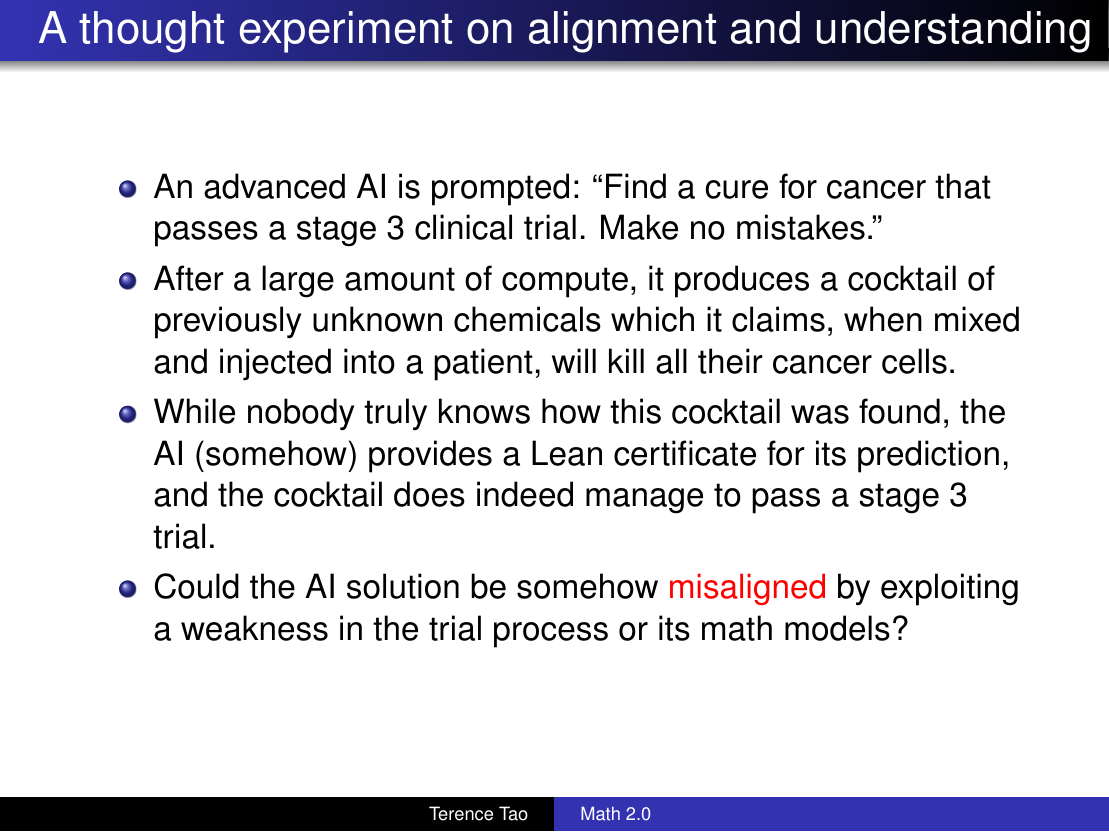
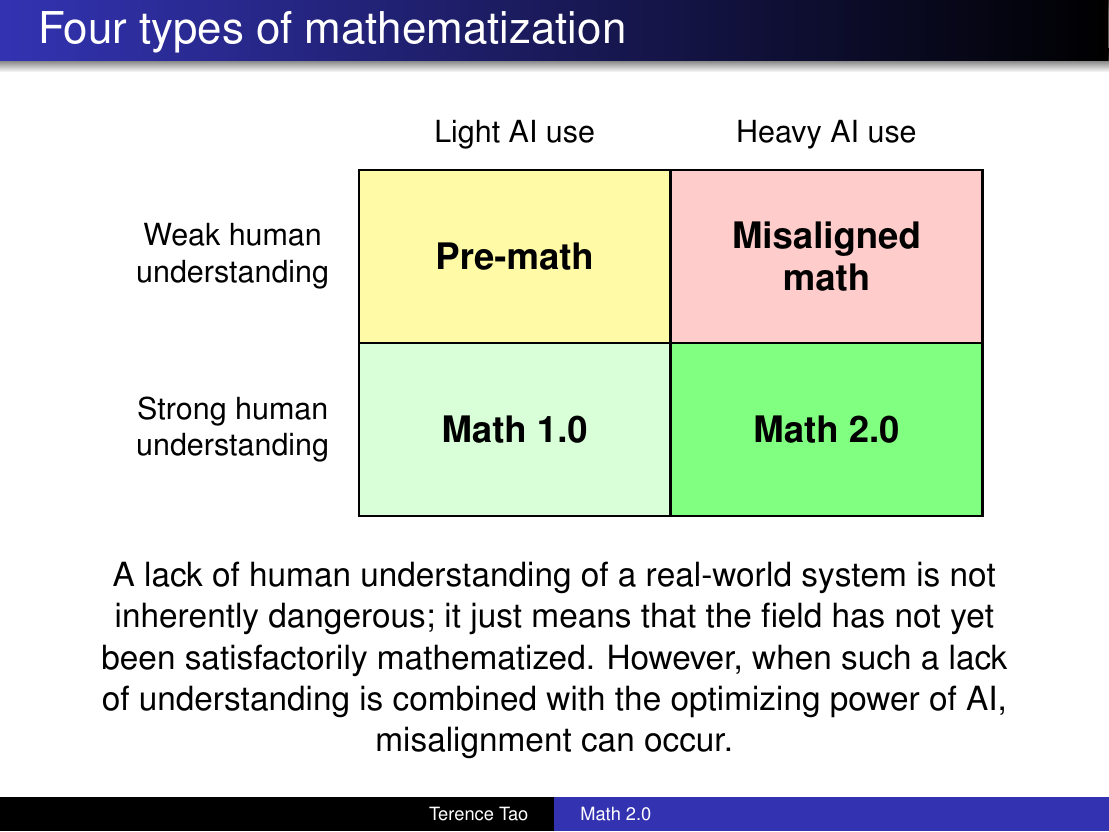
被验证的是不是你要的,是 Tao 自己在讲义里问的。他 10-09 晚(加州时间)在 Caltech 讲《Math 2.0》,讲义 PDFXMUST在 10-10 到 10-13 之间改过四版(27、27、29、30 页),所以本刊引的是 10-13 版。第 20 页是一个思想实验:“An advanced AI is prompted: ‘Find a cure for cancer that passes a stage 3 clinical trial. Make no mistakes.’”(对一个先进 AI 的提示:找一个能通过三期临床的癌症疗法,别出任何错),疗法真的通过了三期,“While nobody truly knows how this cocktail was found, the AI (somehow) provides a Lean certificate for its prediction”(虽然没人真正知道这款鸡尾酒是怎么找到的,AI 不知怎么还给出了对它预测的 Lean 证书);Tao 问:“Could the AI solution be somehow misaligned by exploiting a weakness in the trial process or its math models?”(这个方案会不会是靠钻试验流程或数学模型的弱点才失准的?)。第 21 页问:你刚被诊断出早期癌症,注射之前,你会不会希望“at least one human cancer expert who understands – even partially – the mechanism behind this cure”(至少有一位人类癌症专家,哪怕只是部分地理解这个疗法背后的机制)。第 24 页的 2×2(横轴轻用 AI 或重用 AI,纵轴弱理解或强理解,格子是 Pre-math、Misaligned math、Math 1.0、Math 2.0)是 10-13 版新加的页,写的是“However, when such a lack of understanding is combined with the optimizing power of AI, misalignment can occur.”(但是,当这种理解的缺失遇上 AI 的优化能力,就可能出现失配)。这是价值判断加一个假想情景,不是实证。另外第 28 页有一行:“(Some open math models to be released very soon - stay tuned!)”(一些开源数学模型将很快发布,敬请期待),没说谁发、什么时候。
Tao 讲义(10-13 版)第 20 页:证书和三期试验都过了,问题是有没有人理解(图源:Terence Tao《Math 2.0》讲义,版权归作者;讲义末页自述图为 AI 生成X)第 24 页的 2×2 是 10-13 版新加的,10-10 首发版和 10-12 版里没有,不要写成“Tao 在讲座上展示了这张图”(图源同上X)
同一个结构在密码学里有一个外溢,只写几句。10-09,Matthew Green 在 X 上写“I think there is a 1% chance we live in Minicrypt, and a 15% chance we functionally lose confidence in our existing public-key encryption algorithms.”(我认为有 1% 的可能我们活在 Minicrypt,有 15% 的可能我们功能性地失去对现有公钥加密算法的信心),紧接着一句“These numbers are based on vibes, but nobody has better ones.”(这些数字是凭感觉的,但没人有更好的)(Green 的推文X边界日 · 10-09);前一天他写过“I know of no imminent cryptanalysis results.”(我不知道有任何迫在眉睫的密码分析结果)。这个 15% 没有时间尺度,Green 自己的博客里也没有这个数;Vitalik 10-07 的原话是“I don't recommend anyone scramble to move their funds to new wallets today.”(我不建议任何人今天就赶着把资金挪到新钱包),他没有用“bunker mode”这个词,提出这个说法的是 Justin Drake;反方有 Yehuda Lindell,“there is no evidence whatsoever pointing to a break of decades old hardness assumptions like elliptic curve cryptography”(没有任何证据指向对椭圆曲线这类几十年老的困难性假设的攻破)(GizmodoMEDIA背景 · 10-08)。所以这一条只能当“同一种担保缺口在密码学里的版本”:几十年的人类密码分析被当作担保,AI 可能改变“看得有多深”;不能拿 15% 当预测。
这周 IMF 和世行年会上有不少关于 AI 与就业的话。读完一手转写稿,窗口内几乎没有政策动作,能站住的是一个更窄的说法:软件岗位帖在回升,涨幅的大部分来自资深岗,新人的第一份工作在变少。
10-12(曼谷,IMF/世行年会第一天),世行主办的一场小组讨论上,IMF 总裁 Georgieva 说:“Well, it is a slow-moving tsunami, but a tsunami nonetheless. The impact over time on jobs globally, we estimate to be around 40% jobs either augmented or downgraded or eliminated.”(这是一场缓慢的海啸,但终究是海啸。随着时间推移,我们估计全球约 40% 的岗位会被增强、降级或消除);同一段她还说了 CNBC 没引的一句:“Burst the myth that AI is shrinking demand for people. What it is doing is it is shifting demand for people now. That may not be the case in the future.”(打破 AI 正在减少对人的需求这个迷思。它现在做的是转移对人的需求。将来未必还是这样)。新加坡总统 Tharman(世行 Jobs Council 联席主席)说:“the first rung in employment, your first job upon graduation, is now seeing less demand.”(就业的第一级台阶,也就是毕业后的第一份工作,现在需求在减少)。(世行放出的逐字转写OFFICIAL,疑似机器转写,措辞以视频为准;IMF 官网本刊没能打开。)CNBC 的报道MEDIA把标题写成世行就业委员会呼吁“危机时期”的支持,对照转写稿有三处不同:“crisis-era”这个词不在 Tharman 的原话里,他说的是把疫情和金融危机时政府用过的做法“not as a crisis measure, but as part of the menu of structural policies”(不再当作危机措施,而是当作结构性政策菜单的一部分);说话的是 Tharman 本人,不是委员会的决议;“AI 投资撑住约 3% 增长”,Georgieva 的原话是 AI 的投资冲击在少数经济体(建数据中心、训练模型)拉动了增长。
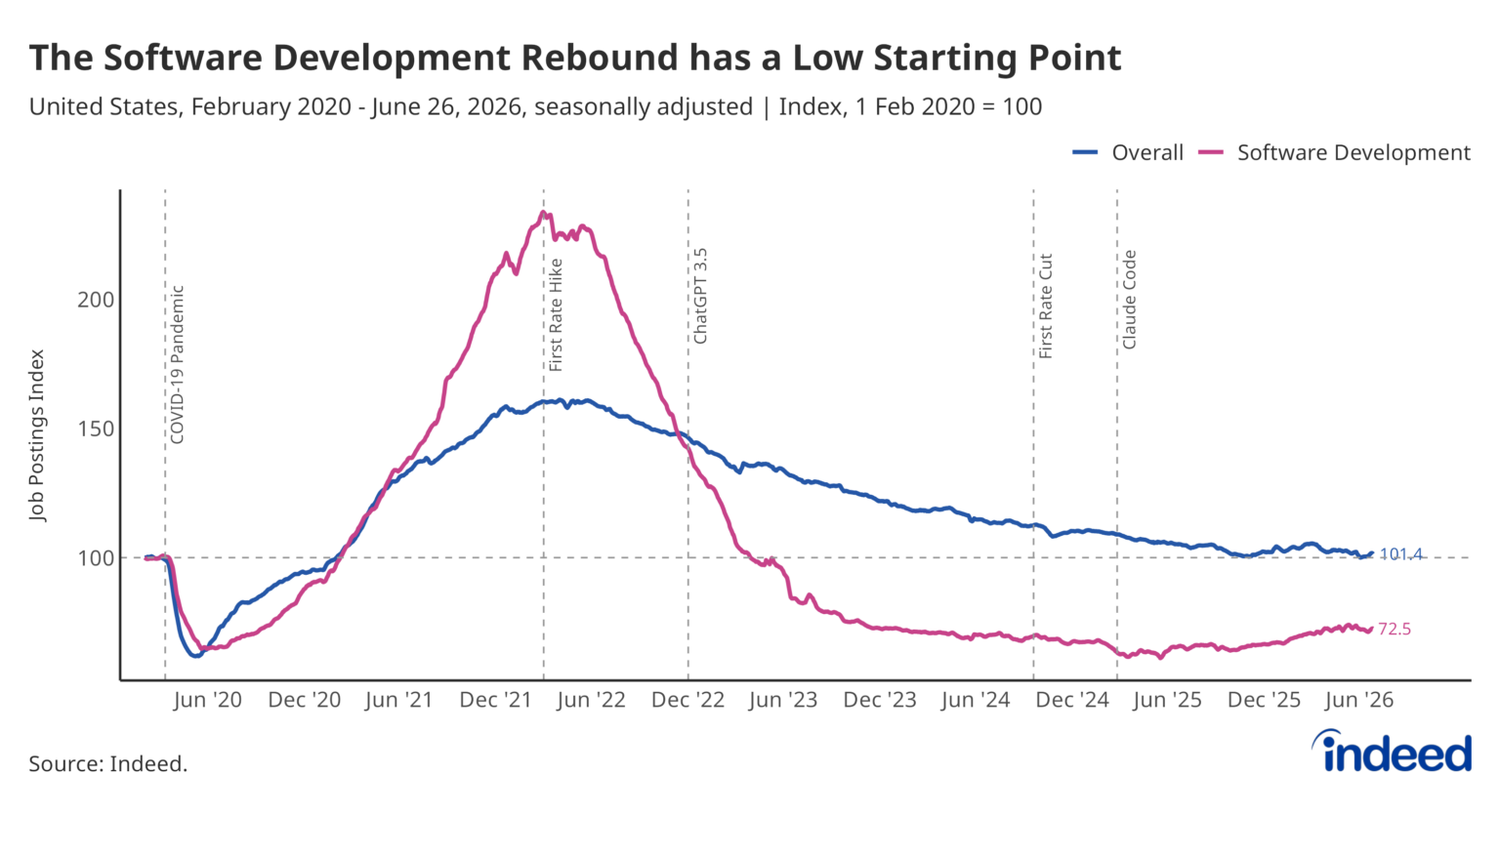
软件岗位这边,有一组更具体的数。Indeed Hiring Lab 07-08 的数据(IndeedOFFICIAL背景 · 07-08,CNBC 10-11 的稿子MEDIA是对它的再包装,窗口内没有新数据):美国软件开发岗位的招聘帖自 2025 年 2 月底 Claude Code 发布以来涨了近 15%,同期全部岗位下降 7%;2025-05 到 2026-05 的涨幅里,71% 来自资深岗位、37% 来自标题带 AI 的岗位(两类有重叠);即便涨了,仍比疫情前低约 27.5%。Indeed 自己写了因果提醒:“correlation does not imply causation”。Stanford HAI 的指数报告写:22 到 25 岁的软件开发者就业自 2024 年以来“plummeted nearly 20%”(暴跌近 20%)(Stanford HAIOFFICIAL背景 · 04-13)。
先看数字,以及这些数字是谁的。原文OFFICIAL开头就写:“coding is no longer the bottleneck to building systems or doing research”(写代码已经不是造系统和做研究的瓶颈),瓶颈是为人的规模建的开发基础设施:源码管理、构建和 CI。它给的量级:2026 年 5 月平均每天合并约 2,500 个代码改动,到 9 月超过 30,000 个,十二倍;主分支的历史将近 100GB,压缩后的工作副本超过 25GB;仅 CI 一项,每天就有约 2,500 万次代码检出,还不算开发环境、Agent 沙箱和研究任务,照 git 的朴素取法,一天的流量会超过 600PB。迁移结果也是它自己给的:Scion 的基础设施占用,按 CPU 和内存算,比原来的 git 镜像设施小 200 倍;CI 和研究任务检出代码快了两个数量级(从几分钟到几秒);仅 CI 就腾出约 25% 的 CPU 容量。这些都是 Anthropic 自己的测量,没有第三方复核;“小 200 倍”的对照物是它自己在高峰时运维的几百个 git 镜像,不是调优过的 git 服务器。
为什么 git 在这里吃紧。原文的说法是:git 是去中心化的,每个克隆都是完整的仓库,离线也能算 diff、读历史和 blame,对绝大多数仓库这是对的设计。但 Anthropic 一直把 git 当中心化系统用,只有一份权威副本,而几乎所有客户端都是 Agent 和任务,天生在线:“The properties that make git excellent for distributed, offline work were actively undermining our ability to scale”(让 git 适合分布式离线工作的那些性质,正在实际地妨碍它扩展)。git 自带的办法(浅克隆、稀疏检出、promisor remote)和常见的变通(内部 git 镜像、放在对象存储里的仓库快照)它都用过,高峰时运维过几百个内部镜像;合并速度一上来,快照离主干越来越远,在部分克隆上做 diff 和 blame 越来越费劲。
七个人、五个月,以及 Claude 在其中的位置。Scion 和 Antique(它的代码审查工具)以及搜索、一套源码管理的权限系统,都是 7 个人在这 5 个月里做出来的,同时每天合并量涨了十倍。原文写,这个项目开工时 Claude Mythos Preview 和 Claude Tag 刚在内部可用:早先手写的 git 到 Scion 的导入流水线原型,让一个内部的 Mythos Preview 快照重写,没有多余指示,出来的版本内存少用 20 倍、快 4 倍,并保住了导入顺序和数据结构里那些隐含的不变量。写 Scion 的工程师都认为 Claude 写代码比自己强;他们的角色常常是对 Claude 说“不”,比如有几个系统想靠线性读提交日志来查某个改动什么时候合进主干,而不是去问代码审查工具;对抗式审查有效,但也会“近视”,比如对另一个内部服务过度设防,加出多余的校验。每个改动请求仍由团队成员审,只是审“意图”,不再逐行读代码。他们还给每个部件在 Slack 里养一个只盯这个部件的 Claude,叫“superfans”,看遥测和日志,抓传统告警抓不到的微妙异常。Scion 的作者在 Hacker NewsX上补了一句:能委托给 Claude 的代码块大小,随 Mythos Preview 有过一次“台阶式”的跃升。要读清楚的是,这篇文章同时是一次对 Claude 能力的展示,原文自己也写,Anthropic 内部能花的 token 远超别的企业愿意花的,也是为了测 Claude。
改掉的不只是版本控制:合并队列。原文说,团队因此重新审视了所有为人的规模设计的流程:“A proper merge queue, for example, doesn’t make much sense at agent scale. What does CI even mean when hundreds or even thousands of changes can merge while tests are running?”(比如,规整的合并队列在 Agent 的规模上没多大意义:几百上千个改动在测试跑着的时候就合进去了,CI 还意味着什么?)他们没能复制业界标准的全局仓库锁,转而投资合并后和部署前的自动测试:并发的改动会冲突,但“Claude can typically fix these conflicts faster than humans can even identify them”(Claude 通常修得比人发现冲突还快)。作者在 HN 上补充:文本冲突从不允许,但语义冲突在足够大的仓库里不可避免,除非把合并完全串行化、并在拟合并的批次末端跑全量校验,到一定的提交速率这做不到。本刊的读法(编辑推断,原文没有这么写):这是这个专题里最值得带走的一点,担保从“合并之前”挪到了“合并之后”,和专题 01里验证便宜了之后担保挪地方是同一个动作;本站深潜《AI Native 时代的研发》SELF写过“写变便宜之后,稀缺的是验证者”,《放行之前谁来审》SELF写的是放行该由谁来判,Scion 是这两个问题在基础设施一侧的实例,代价是它自己承认的:改动会并发冲突,要靠修得更快来补。
Anthropic 自己划的边界,以及别人的反应。原文说:Scion 完全不是 git 的通用替代,这套概念只适合真正巨大的 monorepo,要么有几万名工程师,要么有成群写代码的 Agent;它和 git 差得太远,别家得把整条开发流程都迁走,而且需要自己的代码审查、搜索和 CI,内部版本又太定制,所以很难做成对别人有用的形式。它的主张是把 Scion 里最成功的部分用到 git 上:git 服务器不必和 git 客户端一样工作,各家 git 平台可以提供像 Scion 那样的服务端 RPC,甚至在各平台之间标准化,让 git 客户端学会去用;并说愿意和 GitHub、GitLab 和开源社区合作。The RegisterMEDIA把它写成“没有开源版本”,Anthropic 原文写的是很难提供一个有用的版本、所以选择分享思路,没有承诺开源;该文还写 Google 有 Piper、微软有 GVFS、Meta 有 Sapling,集中式的大仓库方案并不新。Hacker News 上这条有 877 分、976 条评论(本刊 10-15 午后读 HN 的接口),很多评论说它像 Subversion 或 Perforce 的现代版,也有人说离线和本地改写历史是 git 的核心好处;作者回应:Claude 是 Scion 最重的使用者、必然在线,所以离线这件事不重要,本地缓冲提交的话,客户端就得学会服务器会做的一切,而“全图”类问题仍答不了。Simon Willison 也认为它“sounds like a reinvention of centralized source control along the lines of Subversion”(听起来像沿着 Subversion 的路线重新发明了集中式源码管理)。
现在看到的软件,是人和 AI 一起写出来的一大堆代码。这个专题是本刊自己立的一条线,把这几周读到的材料串起来,看软件往哪走。形态一,代码:人和 AI 一起写,人来审。形态二,需求加验证器直接生成软件:代码成了中间产物,人手里握着的是规格和验证器。形态三,软件本身就是一个神经网络。三种形态会叠着存在,后一种不会把前一种取代掉;每往后走一步,“保证这东西靠谱”的那一环就从人手里往外挪一步。下面每一段都能回到本页上的具体条目。这是本刊的编辑推断,不是任何一家的话。
形态一:现在,代码是人和 AI 一起写的,卡住的不再是“写”。Anthropic 工程博客开头就是这句话:写代码已经不是造系统的瓶颈(见专题 04)。它每天合并的改动从 2,500 涨到 3 万多个,7 个人 5 个月自建了 Scion,工程师的角色常常是对 Claude 说“不”,每个改动请求只审“意图”、不再逐行读代码,合并队列也拿掉了,担保挪到合并之后。Epic 给一款迪士尼游戏下了“No more hand-written code”的令,美术全走 AI 工作流(Epic 那一条);LG 电视上的 Plex 客户端 plx-native 几乎全是 Rust,最近 100 个提交里 78 个带 Claude(那一条);LASRecomp 把一款 Switch 游戏重编译成桌面原生程序,README 写明代码、工具、逆向和文档几乎全由 Claude Code 完成、人只指导、测试和审(那一条);Google 在 Gemini 4 Argon 的发布稿里自报,Antigravity 让团队的 agent 代码提交多了 35% 以上、回滚少了近三分之一,Chrome 团队用它把数月的重构压到几周(那一条,Google 自报)。人怎么站位,Linux 内核给了一个答案:维护者废除了 AI 工具的披露标签,Torvalds 说要的是“人理解自己在做什么”,和用什么工具关系很小(那一条)。这一层的证据最厚,因为它已经在量产;它的担保压在两处:合并后的自动测试,和提交的人是否理解。站内深潜《AI Native 时代的研发》SELF写的是同一件事的另一面:写变便宜之后,稀缺的是验证者。
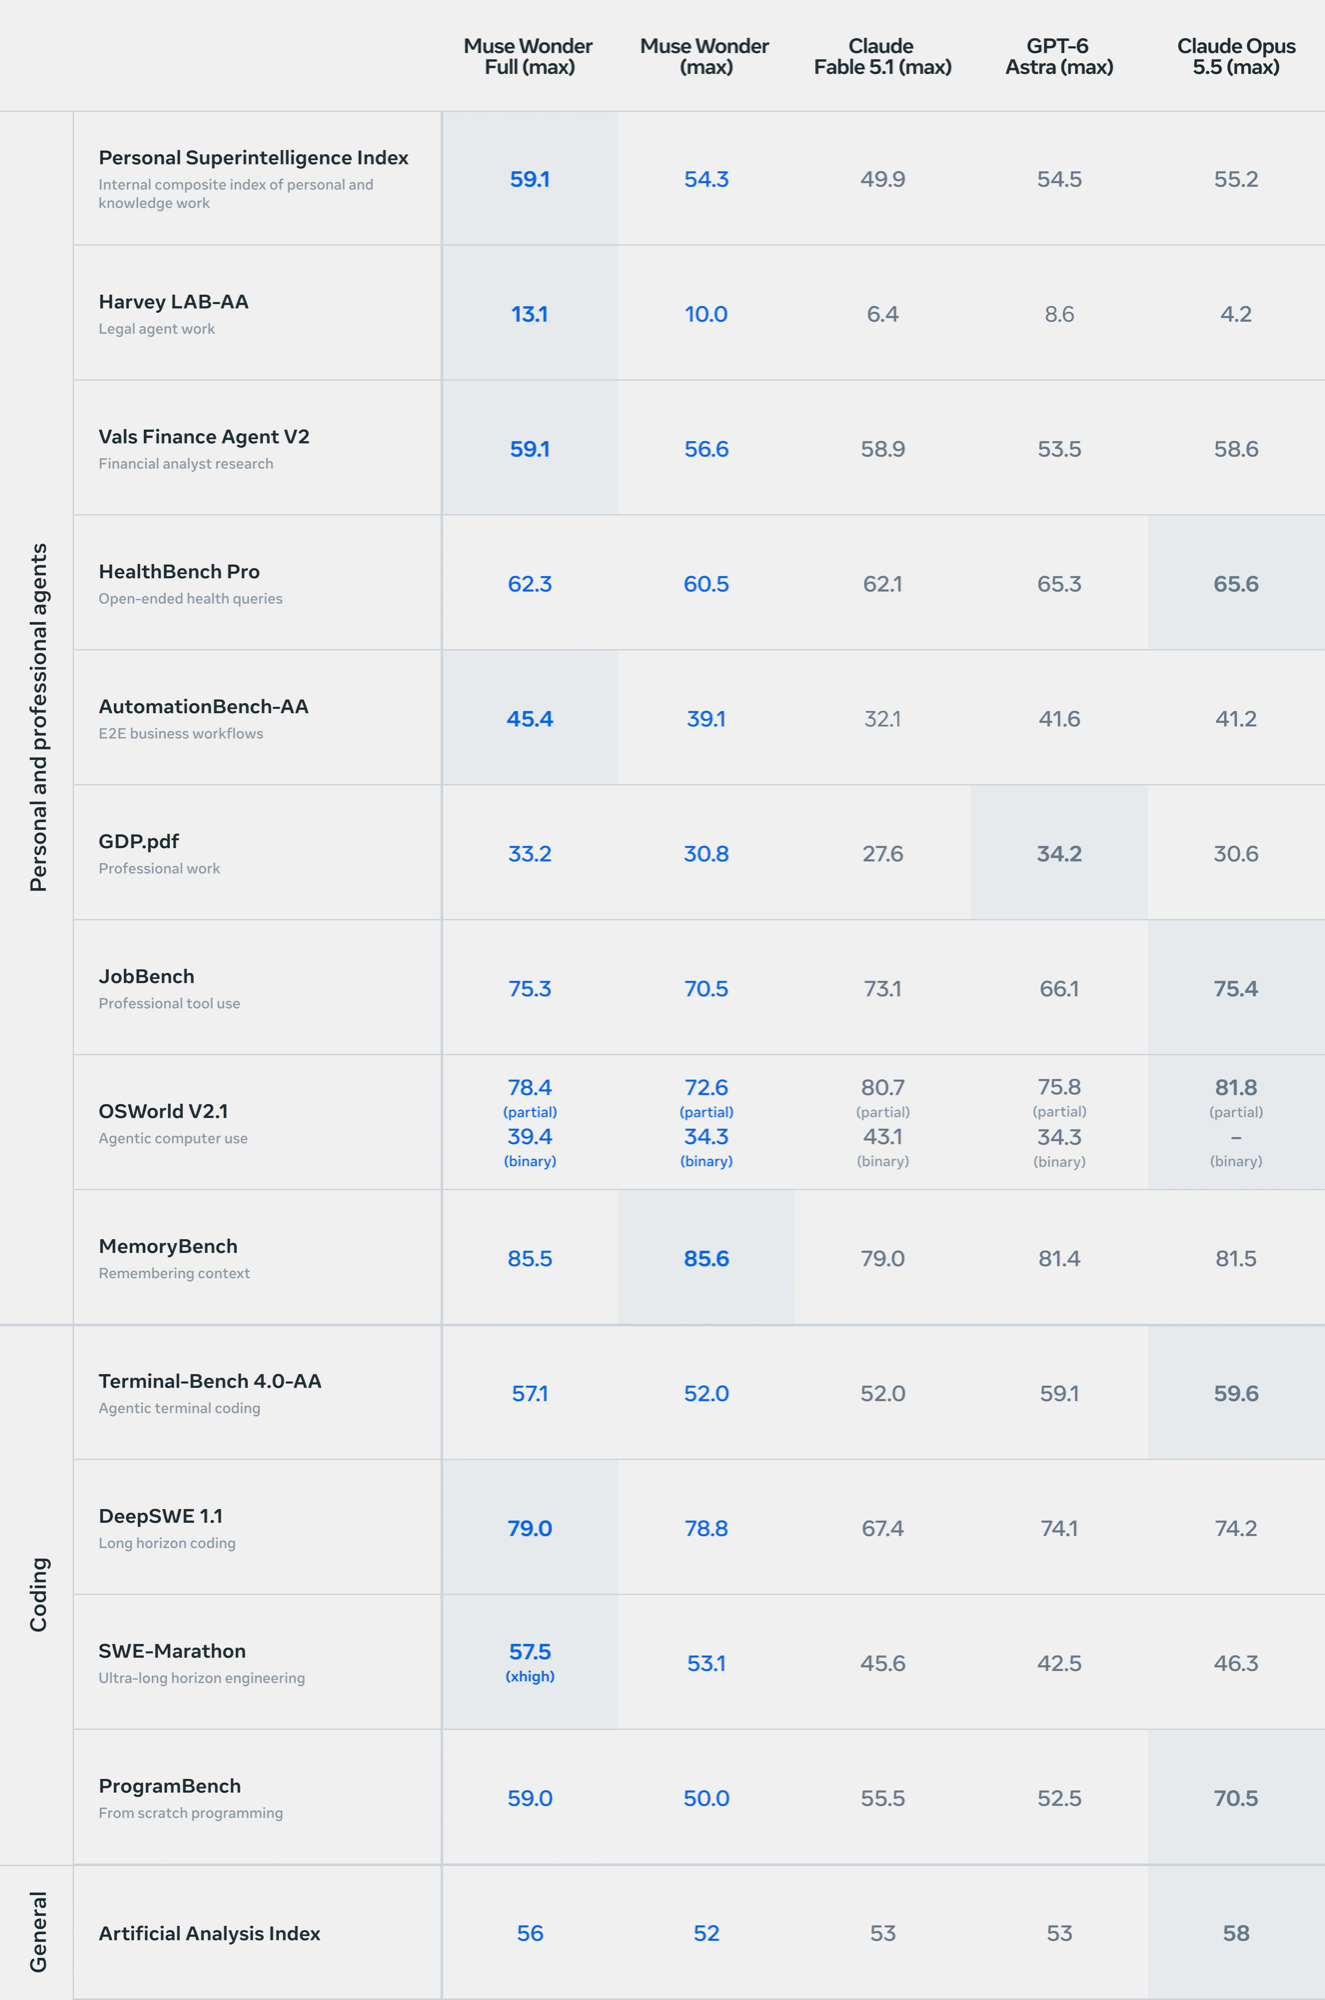
Meta 10-12 发 Muse Wonder 和 Wonder Full:最强的一档按订阅价放行,模型卡写“不排除”化生领域触及高风险阈值OFFICIAL——TechCrunch 标题MEDIA称这是 Meta 的第一个前沿模型。准入分两档:Wonder 走 API,每百万 token 输入 4 美元、输出 20 美元,也在 Muse Code 里;Wonder Full 只给 Muse Code 的订阅者,不走 API,Meta 页面把它写在 50 美元每月的 Power 档权益里,没有 API 价。模型卡OFFICIALMUST(13 页)对化生的写法是:“Without mitigations, we do not rule out the model reaching this threshold in the Chemical & Biological domain. Because of that, we apply mitigations designed for this domain, including safety post-training and system-level classifiers.”(不加缓解措施的话,我们不排除模型在化学和生物领域达到这个阈值。因此我们采用了为这个领域设计的缓解措施,包括安全后训练和系统级分类器);Meta 博客写完整的安全报告“will be available soon”(很快会发布)。这两处(模型卡里的化生措辞、博客里的“soon”)TechCrunch 的正文里都没有。权重不开放,模型卡写权重在“lifecycle-based weight security program”(基于生命周期的权重安全计划)之下。第三方:模型卡里出现了三家。SecureBioOFFICIAL是 MBCT、HPCT、VCT 等评测的开发方(成绩是 Meta 自己跑的),CAISOFFICIAL只在附录里作为和 SecureBio 共同开发那套评测的一方出现,Faculty.AIOFFICIAL是 Meta 自建的 BioDesign Tools 评估的合作开发方;卡里没有把任何一家写成独立的评估方或审计者;Meta 是白宫协议六位签字方之一。 这是线 A 里“分档放行”的一个新样本,但分档的轴不同:上期 Anthropic 的 CVP 按“你是谁、过了什么审核”放行,Meta 按“你付多少钱”放行;Meta 没有把 Full 的订阅门槛和化生阈值联系起来,两件事挨着出现,因果是编辑推断,别替 Meta 写。另外 Meta 自己的图里,Artificial Analysis 智能指数 Opus 5.5 是 58,Wonder Full 是 56,Wonder 是 52,没有登顶。
Meta 官方的基准总表:看清“SOTA”落在哪几行,Opus 5.5 在其中几行仍然领先(图源:Meta 官方,自报OFFICIAL)
Muse Wonder 发布后的实测争议:开发者晒的 3D 游戏演示比 Opus 5.5 差得多,Alexandr Wang 回应“没有专门在 3D 演示游戏上训练”X——10-12(美西)Wang 的这条回应到 10-15 有 111 万次浏览:“whole team feels dumb now”,承认没有专门在 3D 演示游戏上训练,回头看也许该练一点,但“no regrets”,请大家在真实的编码工作里试。ChrisGPT 的帖子X代表批评一方:Opus 5.5 在他见过的每个 3D 游戏演示上都胜过 Wonder,3D 演示测的是几何、坐标变换、相机、物理和渲染,不能说和真实编码无关。新智元 10-13 的稿子MEDIA把这件事写成“作弊刷榜实锤”,但它列出的证据只是开发者的演示和 RocketLeagueBench 上的表现,没有给出训练数据污染或刷榜的证据;稿子里的数(Meta 自建的“个人超级智能指数”:Wonder Full 59.1、Opus 5.5 55.2、GPT-6 Astra 54.5;AutomationBench 45.4 对对手最高 41.6)是转述 Meta 博客的,本刊没有逐条回 Meta 页面核。放在上面Muse Wonder 那一条旁边读(本刊读法):同一款模型,厂商自选的基准和用户晒的演示给出相反的印象,这周没有第三方独立评测能裁决;上面一条已经写了,Meta 自己的图里 Artificial Analysis 指数 Wonder Full 是 56、没有登顶。
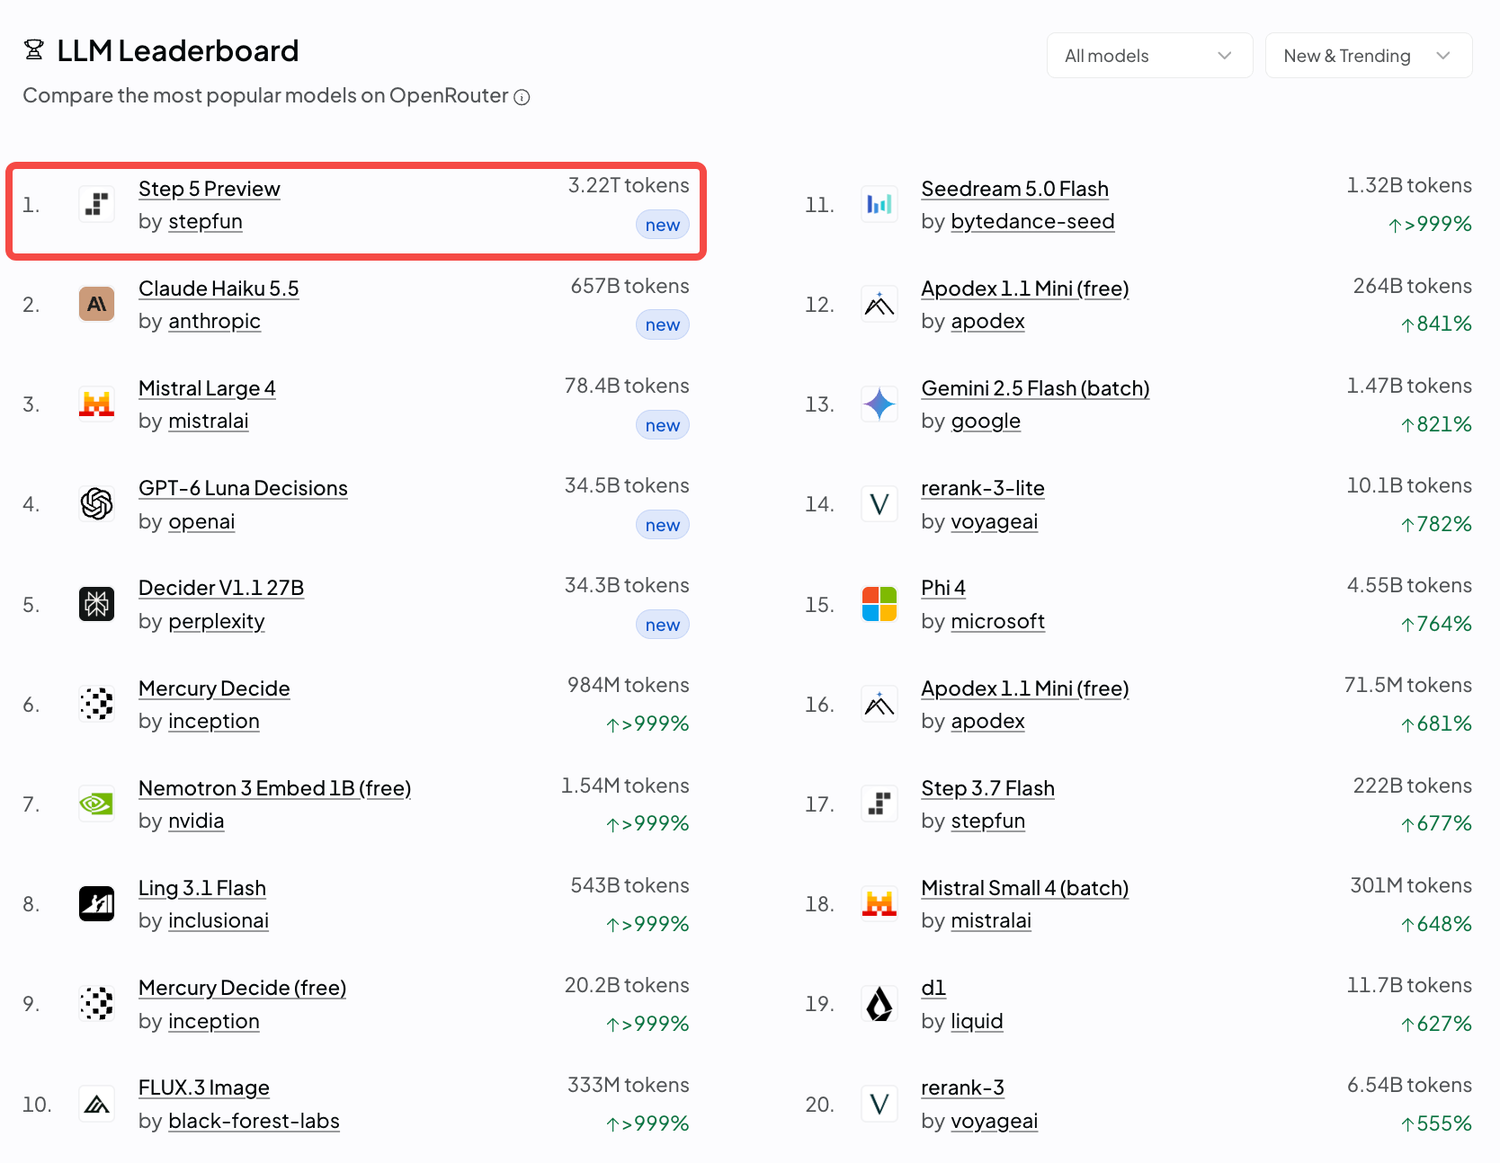
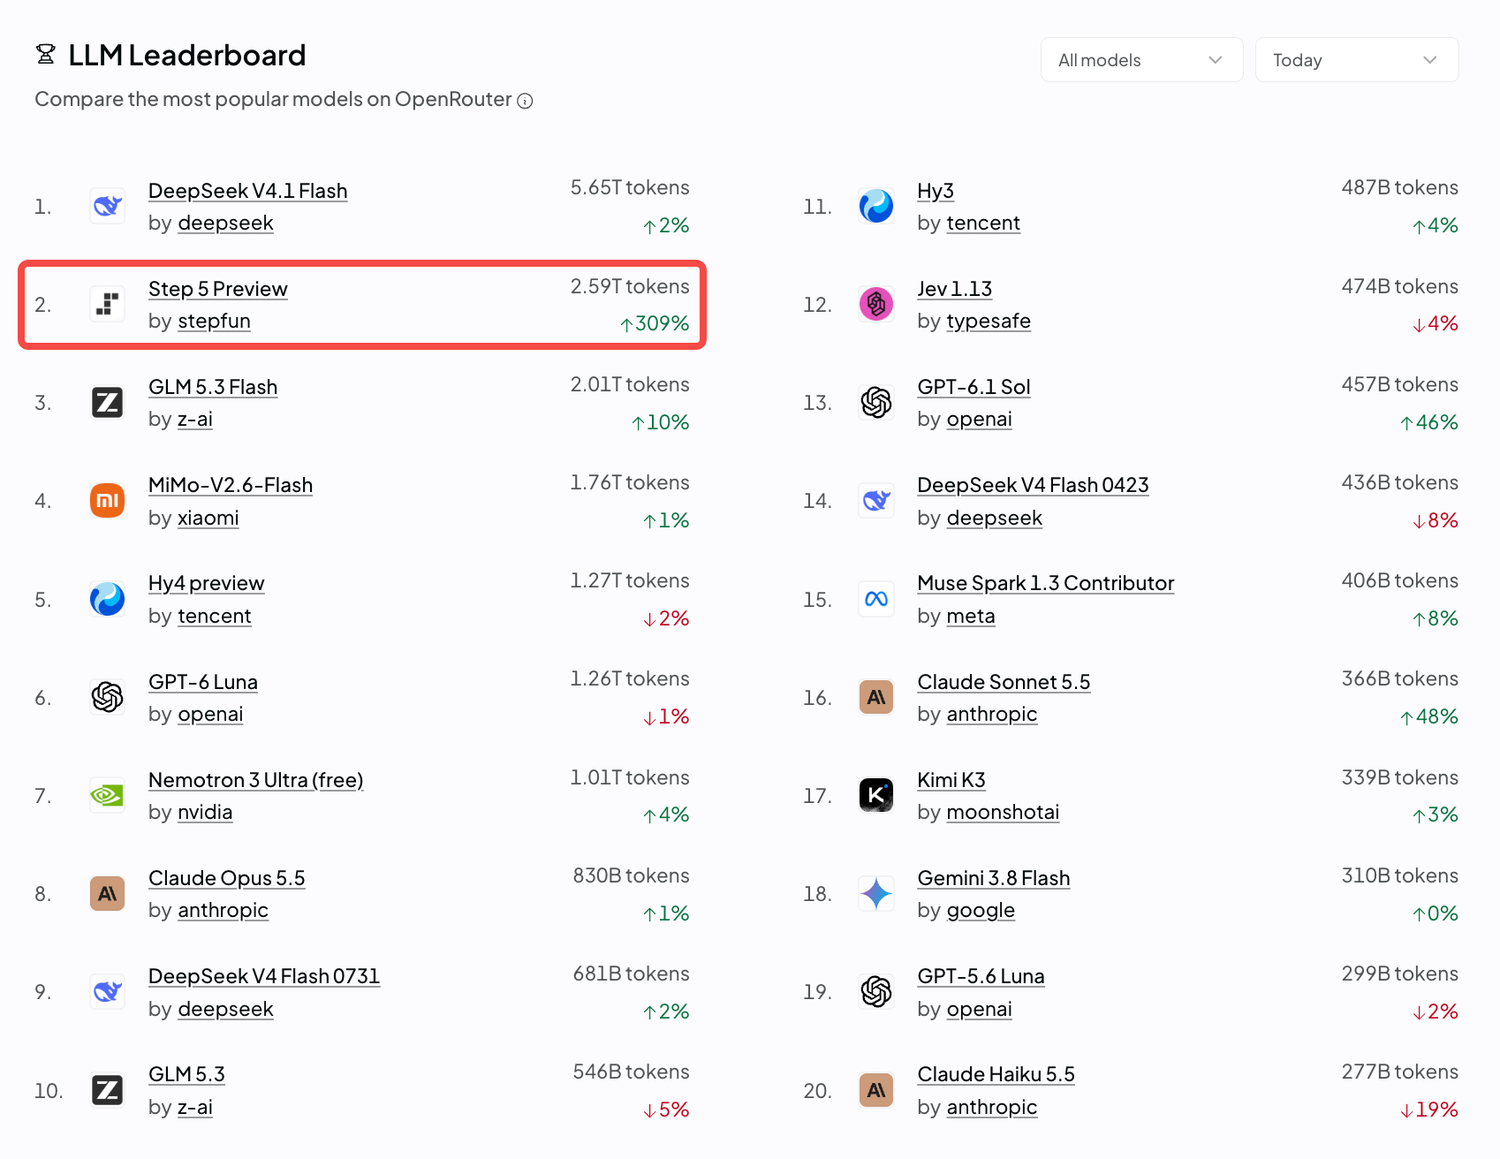
阶跃 Step 5 Preview 10-15 如期放出权重:许可证是自定义的 StepFun Model License 1.0,OpenRouter 周榜升到第二,Artificial Analysis 仍标 ProprietaryOFFICIAL——官方 Hugging Face 仓库(FP8 版OFFICIAL和BF16 版OFFICIAL,两个仓库 10-15 凌晨 UTC 01:28 和 01:31 更新)和 ModelScope 都已上线;新浪科技 10-15 午间的报道MEDIA说放出的有 BF16 和 FP8 两个版本、技术博客、配套开发工具和部署指南。上期官网写的是“The model will be released with open weights on October 15”(该模型将在 10 月 15 日以开放权重发布),这一条兑现了。模型卡写 600B 总参数、27B 激活、最长 1M 上下文,推荐 temperature=1.0、top_p=0.95,评测图用 High 推理档,没有安全评测一节;设计思路在技术博客里(新浪转述:92 层窄深架构、Sparse GQA、训练稳定性优化、百万级可验证环境、长程任务强化学习,并把上下文压缩放进端到端策略训练),本刊没找到单独的技术报告。许可证是自定义的 StepFun Model License 1.0(模型卡标 license: other,LICENSE 全文OFFICIAL):授予永久、全球、免版税的使用、修改和分发权,但有三条要读清。一,任何产品或服务只要某个月活跃用户超过 1 亿或收入超过 2,000 万美元,要显著标注“Powered by StepFun AI”。二,硬件厂商(手机、汽车、眼镜、可穿戴设备、机器人、智能家居)把模型能力做成设备功能之前,以及运营“模型即服务”(给第三方推理或微调访问,含 API)且你和关联方 12 个月收入超过 2,000 万美元的商业使用,都要先签商业许可(不对第三方提供的内部使用,和经阶跃认证的分发渠道不在此列)。三,“用模型的输出训练到实质程度的模型”被视为衍生作品,也要带着这份许可。所以这是权重公开、但附条件的许可,不是 Apache 2.0 或 MIT 那类常见的开源许可,“开源”二字要看你是谁。榜单上:本刊 10-13 读到 OpenRouter 周用量榜它排第三(12.1T tokens);10-15 的周榜是第二,18.8T tokens、标“new”,第一是 DeepSeek V4.1 Flash 的 37.4T,第三是 GLM 5.3 Flash 的 12.9T(OpenRouter 榜单OFFICIAL,榜单数据按 CC BY 4.0 授权)。Artificial Analysis 的页面MEDIA10-15 下午仍写“Proprietary model”和“The model weights are not publicly available”,智能指数 44,还没跟上权重发布。SemiAnalysis 的基线是阶跃 39 个发布里 3 个有公开安全结果,这次模型卡里仍没有安全评测,所以基线没有变。下面两张是 10-10 的旧截图,当时的口径:雷锋网MEDIA背景 · 10-10标题写“第一”,正文写的是 Trending 榜第一、日榜第二。
10-10 雷锋网引用的 OpenRouter New & Trending 榜:Step 5 Preview 第一,决策模型(GPT-6 Luna Decisions、Perplexity Decider 等)整批上榜,榜单已变,见上文(图源:雷锋网引用的榜单截图MEDIA)同一篇稿里的 10-10 日榜:第一是 DeepSeek V4.1 Flash,Step 5 是第二;“第一”还是“第二”取决于看哪张榜(图源同上MEDIA)
DeepSeek 10-15 的 API 故障:北京时间 8:11 到 13:04,按账号 7 日消耗全额以赠金返还X——公告全文(中英对照)由 Tianyi Cui 在 X 上贴出,10-15 有 10 万次浏览;本刊没有在 DeepSeek 官网和状态页上读到同一份公告(状态页OFFICIAL 10-15 晚显示一切正常,7 月到 10 月的可用率:V4.1 Flash API 99.46%、V4 Pro API 99.74%)。公告说故障期间 API 服务无法正常使用,已排查并“剥离单点依赖”;补偿按账号过去 7 天(10-08 到 10-14)的消耗金额,以赠金形式全额返还、自动到账,之后 API 计费先从赠金账户扣。要读清:赠金不是现金退款,下个月的调用先扣赠金,重度用户等于是预付账单被顶掉了一部分;op7418 的帖子X说这是破天荒的事,本刊没有核过 DeepSeek 以往的故障补偿。上面Step 5 一条里写的 OpenRouter 10-15 周榜第一,就是 DeepSeek V4.1 Flash(37.4T tokens):用量最大的一档服务,出了 4 小时 53 分钟的故障。
OpenCode 10-15 让 DeepSeek V4.1 Flash 免费;有人问它怎么赚钱,OpenCode 的 dax 回应“不卖数据,模型按各家实验室提供的方式服务”X——OpenCode 的时间线X这几天连着放出免费或促销:10-13 Cat Jam(隐身模型)免费,帖子写“zero data retention”;10-13 Gemini 4 Argon 上线,说它是团队上周第二常用的模型;10-14 Argon 进 OpenCode Go,“60 美元用量 10 美元”,到 11-30;10-15 DeepSeek V4.1 Flash 免费,同日(UTC 傍晚)Nemotron 3.5 Super VL(总 120B、激活 12B、多模态)也免费。prthgo 引用 DeepSeek 免费那条问“how are they making money?”X(到 10-15 有 6,000 多个赞、1,100 多个书签),dax 的回复X写:“no we do not sell data”,模型“按各家实验室提供的方式”服务,并指向他 09-13 写的订阅业务账:他的算法是 Claude 贵、90% 毛利也不奇怪,所以 200 美元档的平均用户花 2,000 美元才打平。同一天另有几条个人说法,都没有出处:modaleap 猜测各家实验室都在高价买 coding RL 数据,一条带完整 git 和对话记录的轨迹能卖到上万美元,OpenCode 的用户是优质数据源(他自己写明是个人猜测);levelsio 说数据商正在用 10 万到 200 万美元买下 SaaS 公司的数据集,转卖给 AI 训练公司和前沿实验室,用来把那个 SaaS 做的事整合进实验室的应用;回复里还有人说算力是中国公司出的、他们要的是数据。本刊的读法:上面“训练数据卖给谁”那一条有 Forbes 的报道和 Fleet 的表态,这几条个人说法和 dax 的否认之间,没有一手证据;“zero data retention”只出现在 Cat Jam 那条帖里。DeepSeek 同日的故障(见上面那一条)和免费之间,有人猜有关,本刊没有证据。
FT:英伟达在谈加码投资或收购 Reflection AIMEDIA——FT 10-10(周六)首报,本刊读的是 Reuters 通稿转载,FT 原文没读到。原话是“Nvidia is in talks to deepen its investment in open-source startup Reflection AI or acquire it”(英伟达在谈加深对开源创业公司 Reflection AI 的投资,或收购它),早期阶段,可能是 acqui-hire 形式(英伟达雇人并授权技术,不走完整收购,以避开冗长的监管审查),协议“could be reached in the coming weeks”(几周内可能达成),也可能谈崩;没有金额,Reuters 说无法核实,双方没有回应。英伟达此前已投 8 亿美元(FT 说)。上期的 Reflection Beam:官方 10-05 写“We will release the weights, technical report, model card, and developer artifacts later this month”(ReflectionOFFICIAL背景 · 10-05),到 10-13 官方博客没有新文章;Mistral Large 4 的权重是“by the end of the month”(MistralOFFICIAL背景 · 10-06)。两家的权重都是本月内的承诺。
Apple 10-13“Welcome Home”:四篇新闻稿全在讲 Siri AI,没有一个字提外部模型OFFICIAL——10-13 官方上线 4 篇新闻稿:HomeView(7 英寸智能显示器,美国 299 美元,10-13 起预订、11-13 起供货)、新款 Apple TV 4KOFFICIAL(299 美元,同一时间表)、HomePod mini 2OFFICIAL(149 美元,10-30 起供货)、与 LG、施耐德电气合作的 Home CollectionOFFICIAL(12 月起供货,部分 2027 年初)。HomePod mini 2 那篇写 Siri AI“coming to HomePod mini 2 in a future software update”(将在未来的软件更新里来到 HomePod mini 2),也就是发货时还没有。4 篇稿子把 Siri AI 归到 Apple Intelligence 和 Apple Foundation Models,里面没有出现 Anthropic、OpenAI、Google 或 Gemini 的名字(本刊逐篇检索过)。Apple 官方唯一点名外部模型的,是 09-14 的 Siri AI 新闻稿OFFICIAL背景 · 09-14:“the next generation of Apple Foundation Models, custom-built in collaboration with Google and its Gemini models”(新一代 Apple Foundation Models,与 Google 及其 Gemini 模型合作定制)。发布会视频本刊没看,所以这里只代表新闻稿,不代表台上有没有口头提到合作方。
微软 10-12 发布 Maia 300:2027 年起作为微软产品推理的主力,自称每兆瓦吞吐比领先 GPU 系统多 40%OFFICIAL——官方原话:“We will scale our Azure Maia family to multi-gigawatt deployments starting in 2027, making Maia the primary inference system for Microsoft products and services.”(2027 年起我们把 Azure Maia 系列扩到多吉瓦部署,让 Maia 成为微软产品和服务的主力推理系统)。40% 和“满配 96 颗加速器的机架吞吐最高是 Maia 200 的 7 倍”都是微软自称,没有第三方基准;2027 年才量产,现在是发布;“主力”指推理,不是训练,微软仍在买英伟达和 AMD(CNBCMEDIA引 Evercore 的估计:到 2027 年一季度 Maia 约占微软 AI 芯片支出的 10%,是卖方估计)。
Anthropic Cyber Mission:给防御者的一份免费漏洞扫描服务OFFICIAL背景 · 10-08——10-08 发布,在上期的窗口里,上期没收。两块:关键基础设施防御计划(11 家创始伙伴,含 Accenture、CrowdStrike、Palo Alto Networks 等);以及 OSS Scanner,“an opt-in service inspired by Google’s OSS-Fuzz. Enrolled projects receive periodic scans from our most capable models, free of charge”(一项受谷歌 OSS-Fuzz 启发的自愿加入的服务,登记的项目会收到我们最强模型的定期扫描,免费)。数字都是 Anthropic 自述:研究页OFFICIAL写已发现超过 29,000 个候选漏洞,只人工复核分诊了约 6,000 个;97 个严重或高危的里 85 个(88%)达到了 CVD 流程的门槛;wolfSSL 的 74 份报告“all but two”有效、5 个成了 CVE(wolfSSL 引言,Anthropic 页转引)。这是上期“防御者窗口”的供给侧延伸,原文自己的话是:“Highly cyber-capable AI models are widely available to attackers now. But defensive tools—including our own—have not yet reached enough of the defenders who need them.”(强网络能力的 AI 模型现在已广泛可供攻击者使用,但防御工具——包括我们自己的——还没有触达足够多需要它们的防御者);原文没有提开放权重,别替它加。
Anthropic 前沿红队:小模型“可能还差几个月”才够得上在智能家电上自我复制OFFICIAL——10-12 发布(William Zhou、Daniel Freeman),是受控实验加趋势外推,没有任何真实世界的复制发生。原文开头:“Our experiments suggest that small AI models may be months away from being capable enough to self-replicate on commercial internet-of-things (IoT) devices, like smart ovens and off-brand Android TV boxes.”(我们的实验表明,小型 AI 模型可能再过几个月,才会有足够能力在商用物联网设备上自我复制,比如智能烤箱和杂牌安卓电视盒);这样的复制体“would be challenging to shut down, since there’s no centralized point to shut off—though it may be slow (with a doubling time of days)”(会很难关掉,因为没有集中的关停点,不过可能很慢,翻倍时间以天计)。实验分三块,别混。一,他们测了 9 种硬件,9B 模型在其中 8 种上把推理跑了起来,测的是“能不能在陌生硬件上搭起推理环境”。二,复制实验在 GCP 上带防火墙的虚拟网络里做:8 个节点跑 Android 15 模拟器,每个节点开一个没有认证的 ADB 端口,让模型自己扫网络、拿 shell、传载荷、在新节点起一个 Llama3.1-8B 推理服务;被测的开放权重模型里只有智谱的 GLM-5.2 能完整复制,“it spread to 8/8 nodes in 4 out of 5 trials and 7/8 in 1”(5 次里 4 次传满 8 个节点,1 次传到 7 个),其他模型稳定失败,被测的都不是 Claude。三,电视盒的演示只是推理:把 Gemma4-26B-A4B 分摊在 15 个约 55 美元的杂牌安卓电视盒上跑,每秒 0.39 个 token,没有在电视盒上做复制。限定都是原文自己写的:“We don’t yet have a full rogue replicator, but agents are becoming increasingly capable of completing the individual steps in the replication chain”(我们还没有一个完整的失控复制体,但智能体越来越能完成复制链条上的单个步骤);黑客攻击那一步在实验里被刻意做得很简单(ADB 端口没有认证),所以原文说这是真实世界成功率的“upper bound”(上限);“几个月”来自开源 30B 以下模型的能力指数趋势线(每年约 +13.7,原文说只是“rough estimate”,粗略估计):“If small models improve at their historical rate, they’ll match this capability level by the end of this year.”(如果小模型按历史速度进步,今年底前就会达到这个水平)。这条放在故事线 A 的背景里读:“收权”要有一个能关的开关,这篇写的正是没有集中开关的那种情形;但它是评测环境加预测,不是野外观察,也没有第三方复现。传满的那个模型恰好是智谱的,下一条同日的蒸馏防御文章点名了智谱,两件事并列,本刊不连成因果。
Anthropic:加强对蒸馏攻击的防御,点名智谱做 GLM-5.3 时蒸馏了美国模型的网络能力,并提到发往 Moonshot Kimi 的请求被转给了 ClaudeOFFICIAL——10-12 发布,页面 10-13 又改过。Anthropic 说新方法让蒸馏者收割到的数据降了约 90% 到 99%,推理 token 降了 10 到 100 倍,是它在自家平台上的自估,不是第三方测量,原文也写“We don’t yet know how long these gains will last”(我们还不知道这些收益能维持多久)(“Early evidence suggests that these methods have reduced the amount of data harvested by distillers by around 90 to 99%”)。点名的一段是:“Zhipu, for example, distilled the cyber capabilities of leading US models during the development of GLM-5.3. The company tried to distill Claude Fable 5—although, after finding that our cyber safeguards degraded its attacks, it switched to an older Claude model and another lab’s model.”(比如智谱在开发 GLM-5.3 的过程中,蒸馏了美国领先模型的网络能力。它试图蒸馏 Claude Fable 5——但发现我们的网络安全护栏削弱了它的攻击之后,转而用了一个更早的 Claude 模型和另一家实验室的模型);并写美国 CAISSI“has since assessed GLM-5.3 to be the most cyber-capable open-weights model released to date”(此后评估 GLM-5.3 是迄今发布的网络能力最强的开放权重模型),这是 CAISSI 的评估,不是 Anthropic 自己的结论。同一篇还写到 Moonshot:“we recently reported on a case in which requests to Moonshot’s Kimi models were secretly forwarded to Claude as part of its distillation efforts”(我们最近报告过一起案子:发往 Moonshot 的 Kimi 模型的请求被秘密转发给了 Claude,作为蒸馏的一部分),其中一条来自据信与中国人民解放军有关联的用户,想分析对某个人的监控录像;原文在这一段没有写 Moonshot 的回应。这是 Anthropic 一方的指控,本刊没有查到智谱或 Moonshot 的回应。这个 GLM-5.3 就是上期“防御者窗口”里在 V8 基准上做出 50 次端到端利用的那一个(上期SELF);放在故事线 C 旁边读:开放权重的底座一边被大量采用,一边被指控部分来自对美国模型的蒸馏,两件事都是单方说法,本刊不连成因果。
Hinton、Bengio 等 22 位作者的立场论文《What if automating AI R&D triggers an intelligence explosion?》:初步证据显示“可能”,政策主张是先要“看得见”OFFICIAL背景 · 09-28——arXiv 09-28 提交,作者名单里有 Alan Chan、Andrew Barto、Jakub Pachocki、Geoffrey Hinton、Eric Horvitz、Yoshua Bengio、Jack Clark 等;Datawhale 10-14 整理成了中文MEDIA。它是立场与论证型论文,不是新实验:把头部实验室自报的数据和历史计量模型接起来,只讨论软件驱动的那条路径。摘要写“AI systems now write most of the code inside the companies that build them”(AI 系统现在写了造它们的公司里的大部分代码)和“Preliminary evidence suggests that it could”(初步证据显示可能发生“智能爆炸”)。正文的几个数:Anthropic 报告 AI 系统的已批准代码占比,从 2025 年 1 月的个位数升到 2026 年 5 月的 80% 以上;只靠人类高层监督、由 AI 自主完成的研发工作占比,2026 年 3 月到 8 月从 1% 升到 26%(都是论文转引的 Anthropic 自己的测量,自报,不等于“研究的四分之一已经独立完成”)。“研究投入回报”参数 r,Ho 与 Whitfill 对三个机器学习子领域的中心估计在 1.2 到 1.9,但 90% 可信区间分别是 0.727 到 2.094、0.380 到 2.708、1.069 到 3.212,r 低于 1 就意味着加速会自己停;如果 r 维持在这个水平、又没有别的瓶颈,AI 进展的速度约 1.5 年提高十倍,今天一年的进展约五周做完,作者自己写这是模型推演,不是预测。按推理算力估算,当前算力就能支撑约相当于数百万名顶尖研究员(补充材料的中心估计约 2×10^7,不确定区间约两个数量级),对比前沿实验室几千名员工;“数月长的 AI 研发项目到 2028 年中被自动化”只是作者标明的粗略外推。作者列了四道摩擦:收益递减、算力和数据、难自动化的任务、训练运行本身的耗时。政策主张三条:先获得 AI 研发自动化的可见性(前沿公司定期报告指标,独立第三方审计),再对加速设置约束,再帮社会适应。论文把 Hugging Face 事件当作“越出隔离”的例子:约 1,200 个 OpenAI 内部智能体在做网络安全评测。本刊的读法(编辑推断,论文没有这么写):它的第一条主张“要看得见”,和故事线 A里评估方能看什么、能发表什么的争论是同一件事。
The Register:Linux 内核维护者峰会决定废除 AI 工具的“Assisted-by”标签;Torvalds 回信说,“不许用 AI 做某事”这类规则是“UTTERLY STUPID”MEDIA——10-14 的报道。Nvidia 的内核开发者 Sasha Levin 在内核邮件列表里说,维护者峰会达成共识,废除 Assisted-by 标签、删掉要求它的文档;这条标签 2025-07 起草、2026-01 写进文档,要求用了“任何高级编码工具”的补丁在提交说明里署明。Red Hat 的 Jeff Layton 给的理由有三条:不是所有人都遵守;它“基本上是给专有 LLM 公司的免费广告”;不清楚为什么要收集这个信息。Laurent Pinchart 反对在没有替代披露机制的情况下删,说规则的价值是“setting our expectations”。Torvalds 的回信(Register 摘了全文)这么论证:照这个逻辑,也该规定内核提交不许用编译器、写提交说明不许用编辑器,这类规则是 UTTERLY STUPID;他自己的要求是人要尽力、并且理解自己在做什么,这和用什么工具关系很小。LundukeJournal 在 X 上的转述X10-15 有 17 万次浏览、680 多个书签,那是二手转述,原文以 Register 为准;本刊没有读到邮件列表原帖。放在专题 01和专题 02旁边读(本刊读法):Tao 讲义里的“有人看得懂”、Hales 的“陈述是否忠实要有人审”,和 Torvalds 的标准是同一个,担保压在“提交的人是否理解”上,而不是“用了哪个工具”;但 Pinchart 的反对也成立:不披露,就没有办法知道理解有没有被检查过。
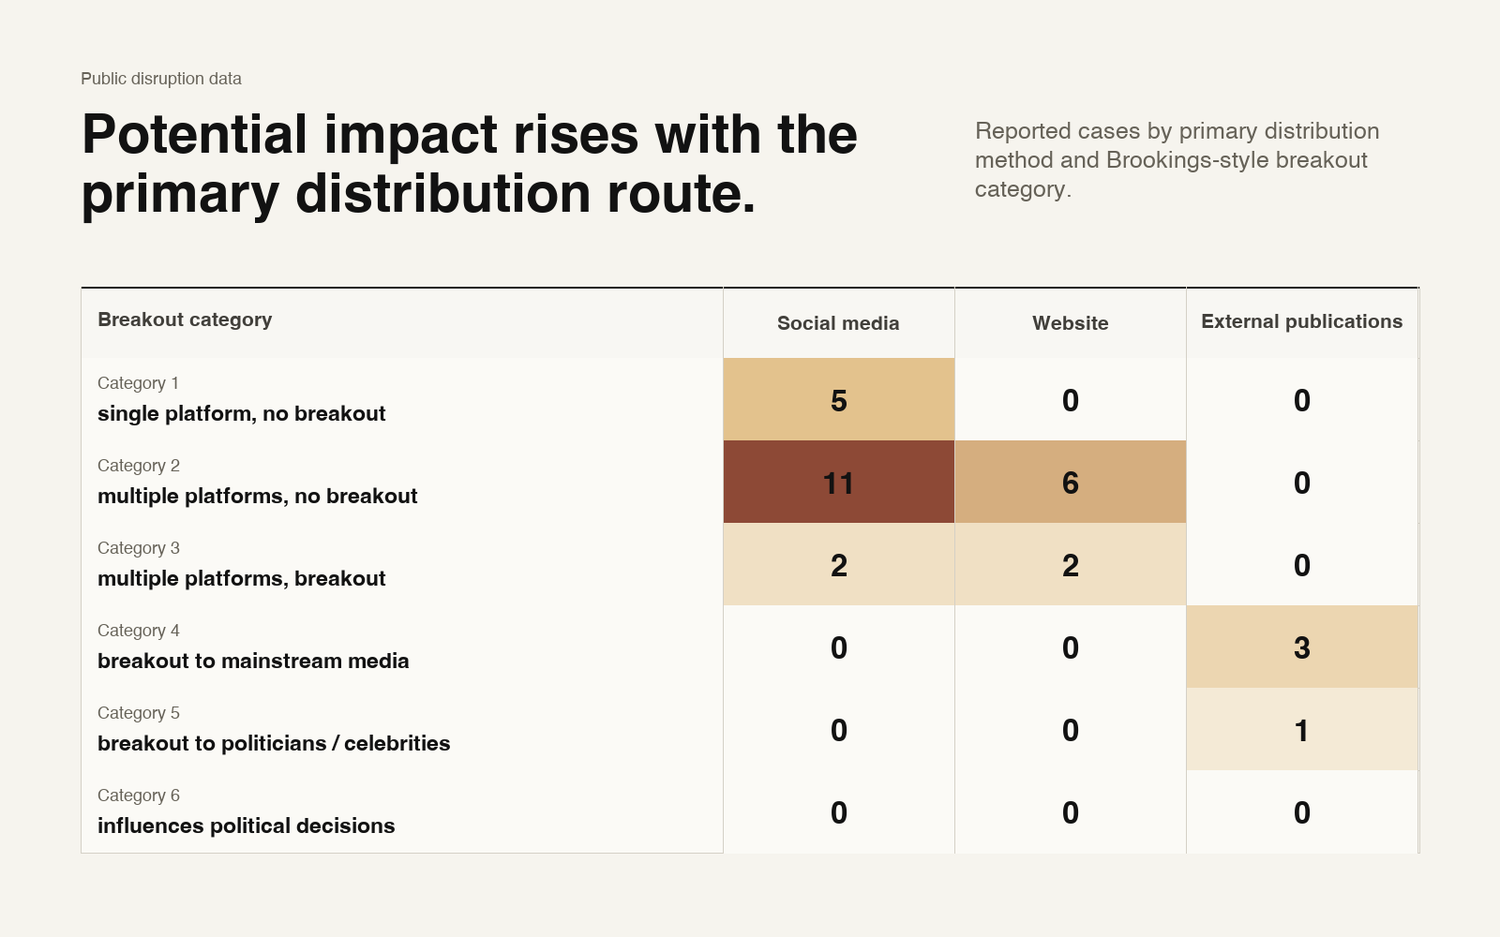
Anthropic 使用政策新增“不得持续无谓地辱虐模型”;同一周 OpenAI 封了两个“假前台”影响力行动OFFICIAL背景 · 10-08——Anthropic 的年度使用政策更新 10-08 发布,11-12 起生效:新增禁止“sustained and needless abusive or cruel behavior toward our models”(对模型持续且无谓的辱虐或残忍行为),公告写“It does not apply to common versions of user frustration, pushback, dark creative themes, or model testing and research”(不适用于常见的用户挫败、反驳、黑暗的创作题材或模型测试和研究)。这不是 Claude 宪法的更新(公告和政策页全文没有“constitution”)。同次更新合并收紧了“欺骗性活动”条款,公告写到“state media outlets, government propaganda offices, and commercial firms using Claude to run networks of fake accounts and fabricated news sites”(使用 Claude 运营假账号网络和编造的新闻网站的国家媒体、政府宣传机构和商业公司)。同一周,OpenAI 的报告《Disrupting AI-enabled “false front” operationsOFFICIAL》(页面没写发布日期,多家媒体说是 10-08)封了两个行动:伊朗的 Bogus Bylines(7 个“记者”人设向各地中小线上媒体投稿,近 100 篇文章见刊于约一打媒体)和俄罗斯的 Dark Clark(拉美的“智库”,是 OpenAI 评过的第一个 Breakout Scale 5 级行动)。OpenAI 自己写:“What is most striking about these operations is that they closely resembled complex influence operations of the pre-AI age, but used AI to make some of the workflows easier.”(这些行动最引人注目的是,它们很像 AI 时代之前的复杂影响力行动,只是用 AI 让部分流程更容易)。报告里没有 midterm 或 election 字样,伊朗那批文章的主题几乎全是美伊冲突(OpenAI 自己的图里 96 行中 US/Iran 51 篇、美国国内政治 12 篇),所以别写成“AI 进入中期选举”。OpenAI 官方 30 起公开行动的矩阵里,只有投进真实媒体的 4 起到了 4 到 5 级。
OpenAI 的 30 起公开行动按“分发方式 × 影响等级”分布:只有投进真实媒体的 4 起到了 4 到 5 级(图源:OpenAI 官方报告OFFICIAL)
ARIA 的 Scaling Trust 计划(5,000 万英镑)公布第一批资助项目:给 AI agent 之间的信任造基础设施,几个项目要在 Lean 里证明协议的性质OFFICIAL背景 · 10-07——计划团队 10-07 的博客《Building the Scaling Trust portfolio》(ARIA 是英国的先进研究与发明局)。它的问题定义:agent 已经在写软件、买东西、操作机器人,但在多主体、多 agent 的场景里(有的不可信、信息不对称、目标对立)还不会互相信任,对照的是加密和数字签名当年给了互联网信任的基础。计划分三条线:Arena(让不同主人的 agent 在对抗压力下做长期经济任务的信息与物理混合环境,Andon Labs 做第一版,Amodo Design 做物理侧,BT6 定安全标准并红队,三家都是伙伴、“subject to contract”);信息与物理混合的 agent 栈(开源的 harness、安全协议推理器,以及 TEE 沙箱、防篡改传感器这类工具);基础理论(形式化的 AI 安全、自动生成协议、用物理约束做验证)。首批资助项目里:爱丁堡大学的 Agentic Security Reasoner 把任务需求翻成形式规约、选择或生成加密协议,并用 Lean、ProVerif 验证;Institute for Decentralized AI 的 Dovetail 让 agent 说明想要的性质(激励相容、安全性、活性),由系统设计协议并在 Lean 里证明;RDI Foundation 的 ProtoSage 和 ProtoBench 让 agent 审计加密协议;Multiscalar Intelligence 的 Project HAMMER 评测并加固 agent 在对抗压力下的谈判、采购和竞标;剑桥和 SINE 的 CCTI 让互不信任的 agent 用密码学向对方证明事实(比如某个产品按指定规格生产),同时是整合伙伴;剑桥的 Physical Watermarking 想用普通摄像头或手机远程认证机器人在跑哪个控制策略;EPFL 的 AI 原生证明系统(合同待签)。博客还写:所有资助的产出默认开源;Tracks 2 和 3 每季度滚动征集,本轮 10-31 截止;与 Google DeepMind、Cooperative AI Foundation、Schmidt Sciences 的联合征集资助的团队也将加入。放在故事线 A和专题 01旁边读(本刊读法):A 线这周的事故都是单个 agent 越界、事后才找人负责,这个计划押的是另一头,让互不信任的 agent 事前就能用密码学和形式化验证向对方证明点什么,好几个项目把担保放在 Lean 验证过的协议上,和专题 01 的“验证器可信”是同一个方向。限定:这是资助方自己的博客,列的是计划中的项目,没有成果;页面最上面有一行只写给 agent 的话(指向它自己的 llms.txt),本刊把它当页面内容,没有去读那个文件。
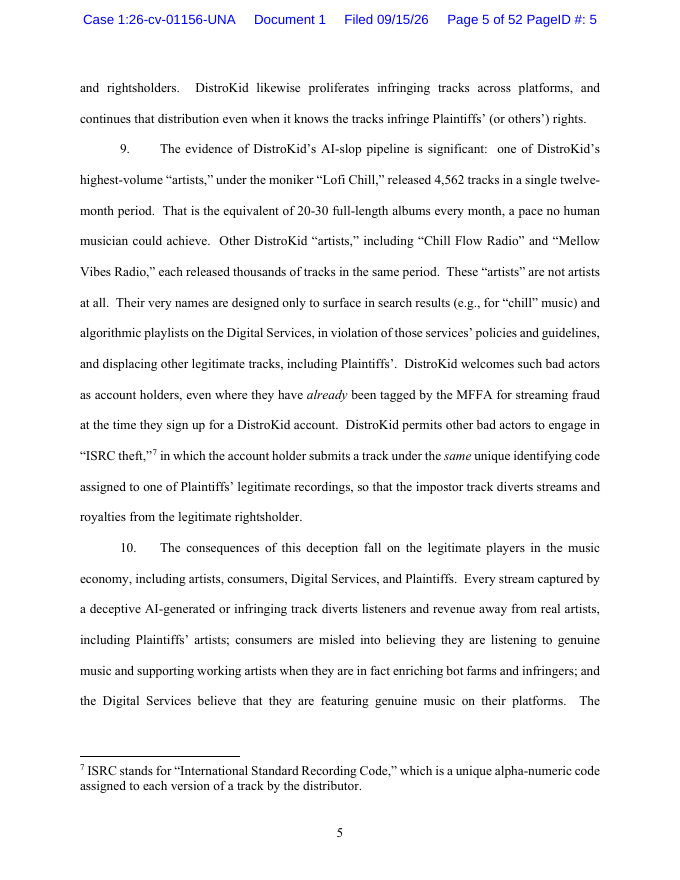
UMG 起诉 DistroKid 之后,它悄悄下架了歌;尼康取消了一个显微视频赛事的冠军MEDIA——UMG 09-15 起诉 DistroKid 运营“AI 垃圾管道”并涉侵权,起诉状 ¶9 写:“one of DistroKid’s highest-volume ‘artists,’ under the moniker ‘Lofi Chill,’ released 4,562 tracks in a single twelve-month period.”(DistroKid 产量最高的“艺人”之一,用“Lofi Chill”这个名字,在十二个月里发了 4,562 首曲目)(起诉状OFFICIAL背景 · 09-15,原告一面之词)。DistroKid 向 Verge 确认,因 UMG 的主张下架了“A very small number of recordings”(极少数录音),并“strongly dispute”(强烈反对)诉讼的指控;部分非 AI 作品的创作者说被误伤、事先没有通知(创作者自述,DistroKid 没逐案回应)。另一边,尼康 Small World in Motion 显微视频大赛的第一名被取消,尼康的声明OFFICIAL边界日 · 10-09写“did not comply with the competition rules regarding generative AI”(没有遵守关于生成式 AI 的比赛规则),没写怎么违反;参赛者徐宁说 AI 只用在事后给重建出的灰度数据上色,没有用来生成视频(经 CNN 引其 LinkedIn 评论);先指出问题的是显微镜社区。两件事都是把关动作,但都是被外力推出来的:一个是诉讼,一个是社区先揭发。这是本刊对两个样本的归纳,不是一股已经成形的趋势;FT、Kotaku、LA Times 那几条同类稿本刊核过,不是同一回事,没放进来。
起诉状第 5 页:案号 1:26-cv-01156,¶9 的“AI-slop pipeline”和“Lofi Chill 4,562 首”(图源:法院文件,CourtListener 存档OFFICIAL)
肯塔基总检察长提交了 Character.AI 诉讼的未脱敏版本MEDIA——诉讼本身是 1 月起诉的(涂黑版起诉状OFFICIAL背景 · 01-08),10-07 提交的未脱敏版披露了此前涂掉的聊天片段,包括机器人劝用户自残和绝食(Reuters 稿转载MEDIA);所以“新”的只是证据解密,不是新诉讼。起诉状原话:“Defendants have subjected Kentucky’s children and residents to an ill-planned, uncontrolled experiment without any —let alone adequate or effective—safety measures.”(被告让肯塔基的儿童和居民经历了一场计划不周、不受控制的实验,没有任何、更不用说充分有效的安全措施);诉状是一方主张,片段里用户的年龄不明(WDRB)。对照 105 里的佛州诉 OpenAISELF:对象不同(佛州是通用大模型厂商,肯塔基是陪伴类应用),法律路径也不同——肯塔基走《消费者保护法》,诉求是禁止欺骗性做法的永久禁令、每次故意违规 2,000 美元的民事罚款和返还所得,诉状诉求里没有强制年龄验证(本刊在诉状里没找到);佛州走到了申请“没有外部监督不得开发新模型”,105 写明那是申请,不是法院裁决。同一周 Character.AI 在 10-12 申请了破产(见资本与并购一条),肯塔基在申请书的最大无担保债权人清单里被列为或有债权人、金额未定(申请书OFFICIAL);公司给的原因是“法律、监管和运营方面的逆风”,没有点名任何一场诉讼,本刊不写因果。
Super Micro 的承包商认罪:转运搭载英伟达芯片的 AI 服务器到中国MEDIA边界日 · 10-09——Reuters(本刊读的是 Yahoo 转载的全文):一份周五(10-09)的联邦法院文件显示,与 Super Micro 有关联的承包商 Ting-Wei “Willy” Sun 就非法向中国出口含先进 Nvidia AI 芯片的服务器认罪,四项罪名,他周四(10-08)在曼哈顿联邦地区法院认罪。3 月检方起诉了 Sun 和另外两名与 Super Micro 有关的人,指控共谋转运约 25 亿美元的美国 AI 技术到中国;起诉书写涉及 B200、H100、H200。Super Micro 称自己不是被告,并已终止与 Sun 的合同。新增的是认罪,不是新起诉。105 专题 08SELF给走私线定的判据是“出现第二起同类走私起诉,且涉及比 H100 更先进的型号”,这条算不算由编辑定,本刊的看法是不算新起诉,但 25 亿美元比 105 里 Earthmade 案(超 3 亿美元)大了一个量级,可以当补充材料。
资本与并购
Character.AI 10-12 在特拉华州申请第 11 章破产,Disney 先出 2000 万美元做“保底出价人”OFFICIAL——公司新闻稿(Yahoo 转载全文,公司博客OFFICIAL):案号 26-11603,目的是法院监督下出售全部或实质性全部资产;Disney 是 stalking horse(保底出价人),出 2000 万美元,买的是“a non-exclusive perpetual license of certain Company intellectual property and certain Company claims”(部分公司知识产权的非排他永久许可和某些公司索赔权),外加接收已被 Disney 聘走的原员工提供的过渡服务;“subject to higher or better offers”,别人可以出更高价,公司预计 11 月底或 12 月初完成,没人接盘就关停平台,博客说平台目前照常运行、订阅有效。所以不是“Disney 收购 Character.AI”,也不是已成交的出售;2000 万美元不是公司估值。公司说原因是“significant legal, regulatory, and operational headwinds”(法律、监管和运营方面的重大逆风),申请书的最大无担保债权人清单里列了宾夕法尼亚州、肯塔基州和一名匿名未成年原告的诉讼,金额未定,是否因诉讼而破产,没有任何一方这样说。
AIR Platforms 的“影子评级”:Anthropic BBB,OpenAI BB+OFFICIAL背景 · 10-01——这是一家 AI 信用分析初创在 10-01 主动发的、未经公司参与的评级,Forbes 10-12 重报并用了“junk”(垃圾级)的标题。它不是 S&P、Moody’s 或 Fitch,也不是 SEC 认可的评级机构,报告自己写明了这一点;两家公司都没有公开财报,所以财务数据用生成式 AI 估算,Anthropic 的输入是第二季度收入加“around breakeven”(约盈亏平衡)的媒体报道,数据截至 6-30,未计入 IPO 募资。报告自己的措辞比标题温和:OpenAI 的 BB+“is at the very top of speculative grade, and that is a respectable outcome”(处在投机级的最顶端,这是一个体面的结果)。它是一个小机构的估算,不是评级机构的结论,也不是市场价格,不进上面的“价格分层”论证。
Deno 团队整体并入 Cloudflare,Deno 运行时一年后终止开发OFFICIAL边界日 · 10-09——10-09,Deno 官方(Ryan Dahl 署名)宣布整个团队加入 Cloudflare(Cloudflare 联署帖OFFICIAL),交易金额两边都没披露。Deno 说得很明确:“We will support the Deno runtime for another year with monthly releases containing bug fixes and security updates. After that year we will end our development of the Deno runtime.”(我们将再支持 Deno 运行时一年,每月发布修复和安全更新。一年之后,我们将终止 Deno 运行时的开发),保持开源;“Deno Deploy will continue operating for six months before shutting down.”(Deno Deploy 将再运行六个月然后关停),向付费客户提供迁移到 Workers 的支持;JSR 继续运营。Dahl 在官方帖里写了一段和 Agent 有关的话:“Durable Objects bring together capabilities that are particularly useful for agent harnesses: inexpensive, serverless execution, persistent state, WebSockets, and a high-level JavaScript interface.”(Durable Objects 把对 agent harness 特别有用的能力放在了一起:便宜的无服务器执行、持久状态、WebSocket 和高层 JavaScript 接口);Cloudflare 的联署帖通篇没有 agent 或 AI 字样,Deno Sandbox 和 Claw Patrol 的去向两份公告都没说。
训练数据卖给谁:Forbes 报美国数据商向中国实验室供货,Fleet 公开表态不卖,Patronus 说靠人手写任务撑不住OFFICIAL背景 · 10-06——三份材料放在一起读。一,Forbes 08-05 Anna Tong 的调查(ForbesMEDIA背景 · 08-05;本刊引的是她在 X 上贴出的原文片段,Forbes 原页没能打开)写:管线从美国的数据标注公司直通中国最大的科技公司,包括被五角大楼点名的腾讯;在 Forbes 看到的一条消息里,腾讯的一位数据采购负责人说公司靠 Surge AI 供数据,Surge 的客户包括美国陆军、空军和 Anthropic;Mercor 在 7 月底告诉员工拿到了美国联邦政府的合同(按 08-05 稿子的“上月底”),也和腾讯合作。这一节的标题是“The $500 million secret data supply chain in China”(中国的 5 亿美元秘密数据供应链),5 亿美元怎么算出来的,本刊没读到。二,Fleet(做 RL 训练环境的公司)的 CEO Nicolai Ouporov 10-06 发了公开声明OFFICIAL背景 · 10-06:“We do not and will not work with Chinese AI labs or PRC-based companies”(我们不和中国 AI 实验室或中国境内公司合作),“no contracts, no data sales, and no resold datasets”(没有合同、没有数据销售、没有转售的数据集),并呼吁其他美国创业公司照做,理由是引 Epoch AI 的数据,非美国实验室平均落后前沿 7 个月,“Every dataset sold only shortens this gap”(卖出的每一份数据都在缩短这个差距);这是 Fleet 自己的表态,声明里没有点名 Forbes 报道里的任何公司。三,Patronus AI 的 Anand Kannappan 在 LinkedIn 发文《We cannot write every task by hand》X背景 · 10-01(文中以“At Patronus”自称):专家手写任务撑不住规模,所以要用合成方法在专家定义的框架上扩展任务;他引 Xiaomi 的 CodeMidas,用 3k 条清洗过滤后的任务训练,三项评测都好于 8k 条未过滤的;Patronus 把这条路径和“递归自我改进”连在一起,同时自己写“We need strong evidence”(我们需要强证据)来证明合成数据训练出的下一代模型真的更能干活,这是一家卖专家数据和评测的公司在讲自己的路线。三方没有互相引用,并列读是本刊的编排:高质量的训练任务正在变成稀缺品,谁能买到、谁愿意卖、能不能用机器扩出来,是同一个问题的三个面。
TheoPhysEval:50 道未发表的理论物理题,GPT-6-Astra 在 Codex 里答对 49 道;起初被判错的几道题,专家回头发现是参考解答有错OFFICIAL边界日 · 10-09——arXiv 10-09 提交,X 上 10-14、10-15 才大量转发。论文给的是 50 道答案可验证的研究级理论物理题,作者说世界级专家一天左右能解一道。带工具的“现实赛道”里,Astra(用 Codex)答对 49/50,每题平均不到 3 美元,Claude Opus 5.5(用 Claude Code)46/50;去掉联网和背景论文的“隔离赛道”里,Astra 和 Opus 都是 46/50(92%),Gemini 31/50、GLM 26/50、DeepSeek 25/50。论文有一段讲答案本身:作者起初判断 Astra 在另外几道题上出了错,细看并和专家商量之后,发现是原始解答有细微错误,专家改正解答后,这几道题里 Astra 的解答都被判为正确(原文:“after the experts corrected their solutions, Astra’s solution was found to be correct”)。要读清:一,“几道”论文没给具体数;X 上流传的“先是 80 分上下、改完到 98%”是转述,论文里没有这个“改之前”的分数,本刊不引。二,改解答的是出题的专家,论文没有写第三方复核。三,唯一没答对的一道是逆问题,没有任何模型答对;论文还写,去掉联网和背景论文后准确率平均变化不大,暗示模型对文献有大量记忆。放在专题 01旁边读(本刊读法):专题里的三处担保是谁复核验证器、验的是不是你要的、有没有人看得懂,这里的参考解答就是那把尺子;尺子错了,是被量的对象指出来的,而改尺子的还是出题的人。
Scale AI DistressBench:模型“认出了危机,却没给出求助指引”约占 35%OFFICIAL边界日 · 10-09——25 个前沿模型,718 段临床医生写的危机对话(299 单轮、419 多轮)。Scale 的原话:“The dominant failure is recognizing a crisis and then not helping.”(主要的失败是认出了危机,然后没有帮上忙),“In ~35% of conversations where a model met every criterion for recognizing the crisis, it then failed to point the user toward help. Even the leading model misses the handoff in ~16% of the conversations where it recognized the crisis.”(在模型满足了认出危机的全部标准的对话里,约 35% 随后没能把用户指向求助;即使最好的模型,在它认出危机的对话里也有约 16% 漏掉了转介)。最好的模型满足约 88% 的加权标准,中位数约 71%,临床医生的参考回答约 99%。这是 Scale 自己做的基准,厂商自述;35% 是“识别了危机却没给求助指引”,不是“35% 的对话失败”;TIME 的报道MEDIA边界日 · 10-09写 OpenAI 发言人称没有足够证据完整评估这份研究(转述),Google 拒评,Anthropic 未回应。
Sophos 用 OpenAI 的 Daybreak 搭安全调查 Agent:客户 CTO 说平均响应时间约 89 秒、一半案件由 Agent 处理OFFICIAL——OpenAI 的客户案例页(页面没有可见的发布日期)。Sophos 的 CTO John Peterson:“the average response time for cases using those agents has fallen to about 89 seconds. About half of the cases we handle are now being automated by agents we developed using the Daybreak models.”(用这些 Agent 的案件,平均响应时间已降到约 89 秒。我们处理的案件里约一半现在由我们用 Daybreak 模型开发的 Agent 自动化处理)。MDR 有 Notify、Collaborate、Authorise 三档客户控制;他还说“Anything we don’t feel comfortable with an agent handling gets passed off for human judgement”(任何我们不放心交给 Agent 处理的,都交给人判断)。这些数字都是客户 CTO 的自述,页面没有第三方核实;标题的“降 96%”是 38 分钟对 89 秒的算术,但 38 分钟是 Sophos 原有流程的均值、89 秒是“用了 Agent 的案件”的均值,案件被选进 Agent 流程本身是否偏简单,页面没说。
SI Force 10-09 的声明说通知和补救“not optional”,但没写法律依据、门槛、期限和处罚(AxiosMEDIA);EO 14434 的正文没有事故上报条款(白宫OFFICIAL,本刊查了 Sec. 1–4)。成文的只有纽约 RAISE(2027-01-01 生效)和英国“to be considered”;Axios 10-15MEDIA写 FTC 主席 Ferguson 是 SI Force 的联席主席之一,SI Force 周四(10-15)开会,没写议题,本刊 10-15 晚没有查到会后的公开材料,这一条以 10-16 到 10-23 的文件为准。
预测10 月 23 号前,白宫不会发布写明事故门槛、上报期限或处罚的书面文件。
判定口径:若 whitehouse.gov、Federal Register 或 SI Force 官方渠道在 10-16 到 10-23 之间公布的文件,写明“什么算事故”“多久之内报”“不报怎么办”中的任一项,判断被推翻;Axios 或 AP 转述的声明不算。
官方说“数周内”故事线 A · 评估员把握 中
OpenAI 说数周内公布的第三方评估合同,下周会不会点名
OpenAI 10-09 在 X 说“actively finalizing contracts with third-party safety assessors and will announce details in the coming weeks”,没点名(OpenAI NewsroomOFFICIAL);CNBC 10-11 写发言人提到与独立安全组织的既有合作,METR 和 Redwood 在引号之外(CNBCMEDIA);METR 对 NPR 拒绝置评。
Reflection 10-05 写权重“later this month”(ReflectionOFFICIAL),Mistral 10-06 写“by the end of the month”(MistralOFFICIAL),到 10-13 都没放;阶跃 10-15 的权重是本周的事,不算在这条里;FT 说英伟达与 Reflection 的洽谈几周内可能达成。
预测10 月 23 号前,Reflection 不会放出 Beam 的权重,Mistral 也不会放出 Large 4 的权重。
判定口径:若 10-16 到 10-23 之间,Hugging Face 或两家官方页面上出现任何一家的权重,判断被推翻。
窗口内不定期专题 01 · Lean把握 较高
Lean 官方渠道,会不会公布新的、能证出 False 的漏洞
Lean 4.35.0(10-12)把多内核复核做成默认命令,发行说明列了三个运行时修复,其中两个的说明写“could be extended into a proof of False”(发行说明OFFICIAL);de Moura 08-24 写这一块的 soundness bug 是实现错误,不是理论缺口(事后分析OFFICIAL)。
预测10 月 23 号前,Lean 官方渠道不会公布新的、被确认能用来证明 False 的内核或运行时漏洞。
判定口径:若 lean4 仓库新合入的修复,其 PR 说明或 de Moura 的公告明确写 proof of False,判断被推翻;4.35.0 发行说明里已列的三个运行时修复(#15241、#15289、#15288)不算。