← 分享列表
AI Buzzwords
EP.112
· W47
11.14 — 11.20
每周 AI 情报 三条故事线 · 11 篇专题

新模型怎么玩,便宜模型到底能省多少,Agent的debug怎么做

客户的服务器可以在海外,买算力的人还得报上最终母公司的名字。程序员可以先找便宜模型修 bug,前提是有人看得出补丁修没修好。售后 Agent 把钱退了,回执却丢了,这时重跑,买家会不会收到两笔钱?这三件事,在本周的法规、账单和故障实验里都有了具体答案。

资料截至北京时间 11 月 20 日 10:36。Anthropic 首日收盘为 97.17 美元。APEC 三份配套文件全文待核。

本周专题目录 11 篇
本期必读 20 篇

延续 EP.111 下周看点SELF 的三个判断。各自仍在原来的观察窗口内。

上期判断结论本周证据
园区换手仍在观察期NVIDIA 披露附条件的 neocloud 协议及分阶段信用支持。接着看云厂商净增了多少租约、是否再有未完工园区换手,以及自有数据中心资本开支的指引。NVIDIA CFO 说明OFFICIAL
科研验证仍在观察期物理学家 Nathaniel Craig 公开了 Astra 参与研究的过程。Yang–Mills 复核汇编交代了外部假设并补了勘误。独立专家认领和公开复现仍是上期判断的判据。Nathaniel Craig 的科研协作记录OFFICIAL Yang–Mills 复核汇编OFFICIAL 本周又有一个可直接检查的例子。Vals 11 月 18 日披露,GPT‑6.2 Astra 用 94 分钟为 2006 年 Smoktunowicz 定理找到另一条 Lean 证明,按 API 标价计 21.58 美元。Vals 冻结命题并用独立 Lean 内核重验,再人工核对定理陈述。现成的证明可读可复验,仍是已知定理的形式化。Vals AI 的 Lean 验收报告OFFICIAL 带注释的 Lean 证明OFFICIAL
审查分级方向一致,待复核GitHub 公测按 PR 风险和复杂度调整审查深度。上期同时关心独立上下文和人工批准,GitHub 这次的公告只覆盖审查强度。GitHub Adaptive ReviewOFFICIAL

故事线 A · 算力准入

双人播客
本周判断楼建好、卡到货、客户能用,是三个时间点。这次美国的新规则要查到最后一步。这些先进芯片的算力,机房已经租给谁、接下来又准备租给谁?

假设你替一家软件公司去海外租一批 GPU。机房已经通电,客服也能报每月租金。轮到签字,对方却要你填最终母公司的地址,还得把几处互联机房能给你的算力加在一起。11 月 19 日,美国《联邦公报》刊出了这套问法。翻回上一期,我们盯的是租客会不会退租,这周轮到机房回答它敢把算力卖给谁。EP.111 下周看点SELF 美国联邦公报 91 FR 74970(正式 PDF)OFFICIAL

  1. 11-16BIS 公布远程算力规则。BIS 公告OFFICIAL
  2. 11-17NVIDIA 披露财报与算力采购承诺。NVIDIA 财报OFFICIAL
  3. 11-18Anthropic 敲定 IPO 发行价。Anthropic 定价公告OFFICIAL
  4. 11-19深圳领导人会议通过《深圳展望》,东道主公布成果清单。中国政府网刊载的《深圳展望》全文OFFICIAL 外交部会后成果清单OFFICIAL
  5. 11-19BIS 规则在美国《联邦公报》正式刊载并生效。美国联邦公报 91 FR 74970(正式 PDF)OFFICIAL
  6. 11-19ANT 首笔成交为每股 111.50 美元,美东同日收报 97.17 美元。美联社首笔成交报道MEDIA 纳斯达克 ANT 行情OFFICIAL

机柜上线之后,谁能用到算力?

  1. 项目获批马来西亚前三季度批准 86 个数据中心和云项目。这个数字记录的是本地投资审批。
  2. 机柜上线Nscale 确认首批 Rubin 机柜在运行。公告未披露租户可用容量。
  3. 客户可调用BIS 正式规则把客户总部或最终母公司的所在地、互联机房的合计算力纳入许可判断。

设备出口还要核对目的地的许可条件,客户拿到配额还要看具体的远程用量与适用规则。

三个不同来源的案例,分别说明投资审批、设备上线和客户准入。BIS 规则见《联邦公报》正式文本。马来西亚投资发展局项目清单OFFICIAL Nscale 部署公告OFFICIAL 美国联邦公报 91 FR 74970(正式 PDF)OFFICIAL

合同写了一个地址,还要往上查到谁

先翻正式规则的 § 744.24。出口、再出口或境内转让列管先进计算物项时,如果知道收货机房已经或将向总部或最终母公司在澳门或 D:5 地区的企业供应合计超过 1,200 万 TPP 的算力,就会触发许可。互联机房如果作为整体运行,要合在一起算。对生效前已在大量供给、并打算继续提供的业务,规则给了 90 天取得许可。商业推荐系统有单列的排除条件和报送要求。巴西、印尼、马来西亚、新加坡和泰国涉及的部分物项还有另外的许可条款。美国联邦公报 91 FR 74970(正式 PDF)MUSTOFFICIAL

租客把公司注册在吉隆坡,机房填表的人还要查谁控制它。两栋楼各写一份容量,也要先看它们是否连成一个系统。采购单上如果只有「买了多少张卡」,就得向供应方再要一份数据。规则要算的是总处理性能 TPP,卡的型号和配置都会影响这个数字。

马来西亚批过的 86 个项目,还得过后面的几关

马来西亚投资发展局 11 月 17 日交出一张清单。今年前三季度,批准的 86 个数据中心和云项目合计 1,235 亿林吉特,AirTrunk 的扩建和 Princeton Digital Group 的新园区都在其中。这是此前当地政府批过的投资。园区排好施工和供电,采购部还要问下一批卡什么时候到、能卖给哪些客户。马来西亚投资发展局项目清单OFFICIAL

中国外交部 17 日表明反对。泰国商务部 18 日说要先算一笔账,看看供应、投资和合规成本会怎么变,再向美国问清哪些业务要拿许可、哪些可以豁免。下一份值得看的材料,会是运营商发给客户的通知。通知上有没有写现有合同怎么续、额度如何算、什么时候开始按新条款签约,直接决定这张投资清单能兑现多少。中国外交部记者会OFFICIAL 泰国商务部通报OFFICIAL

英伟达这季卖了多少,还有哪些钱要等

NVIDIA 报了一个 1,158 亿美元的季度,其中约 93% 来自数据中心。下季度指引是 1,300 亿美元,上下浮动 3%,其中数据中心计算收入没有计入来自中国的部分。同周,供应链公告说景硕计划扩充专供 NVIDIA 的 ABF 封装载板产能,预计 2027 年下半年开产。一边是这季已经记账的销售,一边是要等到明年下半年的一条产线。再往后,还有租赁、信用支持和有条件的采购协议。顺着下面的表看同一个问题,这些钱是今天已经收了,还是得等哪件事发生才会动?NVIDIA 财报OFFICIAL NVIDIA 供应链扩产公告OFFICIAL

NVIDIA 同一批披露里,哪一笔已经进账
项目公开金额什么时候看它兑现
本季数据中心收入1,076 亿美元已经记入当季财报,同比增 110%
云协议和未来租赁1,020 亿美元看服务交付、租赁何时开始
另列附条件 neocloud 协议320 亿美元跟踪协议条件及对应项目进度
俄亥俄园区信用支持最高 1,050 亿美元敞口逐步累积,披露时现金支付为零
表内一项是已确认收入,三项是不同性质的承诺或信用敞口,直接相加会把不同的账混在一起。NVIDIA CFO 说明MUSTOFFICIAL

机房今天要用电,签下的 50 兆瓦哪年能到?

Quaise 17 日宣布,Google 签了俄勒冈 Project Obsidian 的 50 兆瓦地热购电协议,最早 2030 年开始供电。第一阶段用常规钻井。公司研发的毫米波钻井要等第二阶段才打算用。Google 19 日谈 The Dalles 机房时,把这份协议、现有园区自 2022 年以来超过 80% 的无碳电力比例,以及新设的 1,000 万美元社区能源基金放在一起。三笔账要分别看。Quaise 公布的 50 MW 购电协议OFFICIAL Google The Dalles 园区与社区基金公告OFFICIAL

50 兆瓦如果全年满发,约是 4.38 亿千瓦时。真正到手的电量还要看每小时发了多少、什么时候并网,以及合同覆盖的用电时段。在并网之前,即使机房新装了卡,眼下的用电也得靠现有电网解决。社区基金可以帮住户承担账单或改善用能,供多少电则要看机组。我的判断是,这份合同先给了项目一个确定买家,也给 Google 留了一份几年后的供电选择。要判断它何时能支撑新增算力,接下来比签约数字更值得看的是并网进度和投产后的实际发电记录。Quaise 公布的 50 MW 购电协议OFFICIAL Google The Dalles 园区与社区基金公告OFFICIAL 几种供电方式怎么比较,见 本刊深潜《数据中心的电从哪来》SELF。

Anthropic 募资这一页,后面跟着一张算力账单

把 Anthropic 最终招股书翻到封面。每股 83 美元,9.8 亿股,基础发售合计 813.4 亿美元。里面约 793.8 亿美元是公司新股的毛额,约 19.6 亿美元归卖旧股的股东。钱都还没扣发行费用,也不含可额外配售的 1.47 亿股。定价高过此前 70 至 78 美元的区间。Nasdaq 把 ANT 的挂牌安排在美东 19 日。Anthropic 定价公告OFFICIAL SEC 最终招股书 424B4OFFICIAL Anthropic 修订招股书OFFICIAL Nasdaq 挂牌资格确认函OFFICIAL Nasdaq 上市通知OFFICIAL背景 · 2026-11-11

敲钟后过了两个多小时,买卖单才撮合。美联社和 Yahoo Finance 均报道,ANT 首笔成交为每股 111.50 美元,较 83 美元的发行价高约 34.3%。到了北京时间 20 日 05:00,常规交易收在每股 97.17 美元。比 83 美元的发行价高 17.07%,比第一笔成交低约 12.9%。同一天的涨跌会有两个答案,得先看拿的是发行价还是开盘价。美联社首笔成交报道MEDIA Yahoo Finance 当日交易报道MEDIA 纳斯达克 ANT 行情OFFICIAL 纳斯达克常规交易时段OFFICIAL 美联社首日交易数据MEDIA 《华尔街日报》中文网收盘帖

再往后翻,招股书里还有一笔很快就要付的钱。从 2026 年 9 月底算起的十二个月,公司预计要为合同义务支付约 707 亿美元,其中约 42 亿美元对应尚有前置条件或提前终止权的安排。招股书还列出一笔按同样每股 83 美元计、总额 260 亿美元的同步私募,买方包括 Google、NVIDIA、AMD、微软和台积电等。把 IPO、私募和应付账款并排看,公司何时把钱募到手、何时得付给算力和基础设施供应商,各有一张时间表。SEC 最终招股书 424B4OFFICIAL

服务器要过许可,深圳会场谈的是数据怎么走

深圳会场出来的《深圳展望》全文有两处值得翻。谈跨境数据的段落把便利流动、数字交易的信任和隐私保护放在一起。接下来一段谈数字与新兴技术,提到 2026–2030 年 APEC 人工智能倡议。会后成果清单列出《亚太经合组织贸易数字化合作框架(2027—2030)》《亚太经合组织互联互通蓝图》和《亚太经合组织关于亚太地区新兴技术促进就业和繁荣的声明》。领导人文件把无纸贸易和跨境电商列入合作方向,也明确亚太经合组织遵循自主自愿、非约束性和协商一致的原则。中国政府网的会后通稿也确认会议通过了三份配套文件。目前能读到《深圳展望》的全文,三份配套文件还要找到原文才能逐条核对。中国政府网会后通稿OFFICIAL

清单上还有跨境数据验证平台倡议和数据跨境流动合作中国中心。后面就等具体项目能不能让一张电子单据跨境核验。外交部《深圳展望》中文全文OFFICIAL 中国政府网刊载的《深圳展望》全文OFFICIAL 外交部会后成果清单OFFICIAL 外交部 APEC 领导人会议通稿OFFICIAL

中方在会上宣布提供 2,000 万美元支持 APEC 务实合作。另在工商峰会上,《深圳倡议》把发展中经济体和小企业能不能用上 AI 提了出来。做跨境业务的人可以把两份文件摆在合同前面读。一份谈怎样让数据流转、降低交易摩擦,另一边的 BIS 条文回答设备供应方能不能让某个客户远程用卡。数据在不在同一个司法辖区,和算力在不在同一家机构控制下,需要各自核实。领导人会议中方发言OFFICIAL 工商领导人峰会《深圳倡议》全文OFFICIAL 11-19 会晤公告OFFICIAL 美国联邦公报 91 FR 74970(正式 PDF)OFFICIAL

扩展阅读

从设备交付到核对硬件证据
  1. 部署与分配

    确认何时能用、算力分给谁。

  2. 运行训练

    用真实集群和同一基准看训练速度。

  3. 核对硬件证据

    检查权重线索和电路改动各验证到了哪一步。

阅读正文 · 5 篇

部署与分配

首批 Rubin 机柜上了线,客户能用多少?

Nscale 11 月 18 日披露,首批 Vera Rubin NVL72 机柜已上线,接进了自家的云管理系统和 RoCE 网络。Nscale 还没说机柜装在哪、装了几柜、能租出多少算力。它计划在未来几个月继续部署。Nscale 部署公告OFFICIAL 另一种分配方式见橡树岭的 Lux。11 月 16 日投入科研使用,以 AMD Instinct MI355X 挤入 TOP500 第 14 位。按合作安排,每年约 350 万节点小时,由美国能源部的 Genesis Mission 与 AMD 各使用约一半。项目披露的是分配额度,实际用掉多少还要看运行数据。橡树岭国家实验室 Lux 公告OFFICIAL

同样叫 Rubin,2028 年的卡还没交货

在 SC26,NVIDIA 展出的 Rubin HPC 是 Rubin 平台上为仿真、稀疏数据和科学计算做的一款 GPU。厂商给的规格是单卡逾 50,000 个 CUDA 核心,配第七代 NVLink,预期 2028 年才有货。工程团队今天若要跑一次求解任务,能用的是届时实际交付的数据中心实例。比较两条 Rubin 新闻时,先找型号和可用日期,再找相同网格、精度和求解器下的用时。NVIDIA Rubin HPC 公告OFFICIAL

运行训练

换一套软硬件,模型训练跑到了哪一步?

Xing4 团队披露了昇腾集群的预训练和性能剖析。MLCommons 同周给出了大、小集群在同一基准上的结果。想知道多装卡快了多少,以及哪些试验量的是不同东西,见 专题《卡堆到一万张,训练快了多少?》SELF。

核对硬件证据

权重里能读出哪一代芯片

Unemployment Labs 从公开权重保留的初始化模式推断,部分 DeepSeek、Kimi 和 MiniMax 模型使用过与 Blackwell 相符的初始化硬件。李博杰 11 月 13 日公布独立复现,在 265 个权重发布版本中有 185 个读出硬件特征,其中 25 个版本带 Blackwell 级特征,对应 16 次不同初始化。这能帮人看出模型最初在哪一类芯片上初始化。芯片放在哪、后来用什么接着训练、设备是否拿到相应许可,都得另外查。Unemployment Labs 权重指纹报告OFFICIAL 李博杰的独立复现OFFICIAL

让模型改电路,先看改动验到了哪一步

OpenAI 在 18 日的技术稿里说,模型改写了 AMD 旗舰 GPU 电路模块的 SystemVerilog 描述。和 AMD 已经多年优化过的基线相比,在功耗、性能、面积(PPA)的比较中最高改善 14%。团队用 Synopsys 工具核对重写前后的电路行为,AMD 已把部分改动放进一版送厂的设计。公开材料里的实物验证来自 OpenAI 自研 Jalapeño,涉及不同计算模块的标准单元面积。采购方要估一批机器的吞吐,还得等 AMD 成品上同一负载的结果。OpenAI 芯片设计技术报告OFFICIAL

接下来怎么看 接下来找机房发给客户的服务更新。通知要是写明哪些客户能续租、几座机房的额度怎么算,就能知道通了电的机房到底还有多少算力能拿出来卖。园区里有什么,见 《蛋糕的物理学》SELF。如果租约真的改了,客户能否迁到别处,见 《当智能成为生产资料》第八章SELF。

故事线 B · 任务成本

双人播客
本周判断把模型调用、重试和请人检查的钱都加起来,再除以按时做对的活。这样才知道交出一份能用的结果,平均得花多少钱。

假设你把同一个 bug 交给两个代码 Agent。第一个交来补丁,你跑完测试就能合并。第二个问了几轮、又重跑了一次,最后也过了。财务部只给你看两家的 token 价表,你却需要知道哪个更便宜地交出了能合并的代码。Databricks 把内部的合并请求和隐藏测试拿出来跑,正好给了一个能对账的例子。Databricks AI IndexOFFICIAL

  1. 11-16Qwen4-Max 正式版上线。阿里云 Qwen4-MaxOFFICIAL
  2. 11-17GPT‑6.2 Astra 降低 API 单价。OpenAI 6.2 发布说明OFFICIAL
  3. 11-18Gemini 4 Neon 发布,标准档定价公开。Google 发布 Gemini 4 NeonOFFICIAL
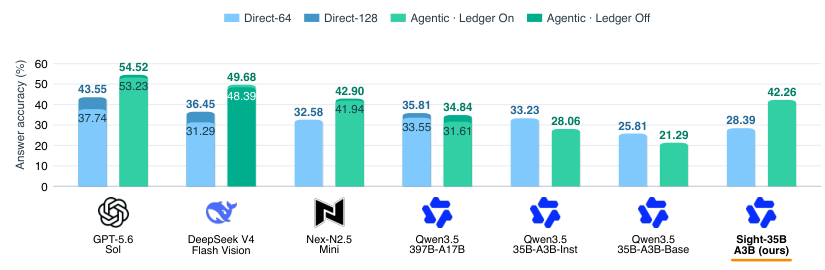
一次编码任务的平均成本 Databricks 的内部任务里,两款模型通过率都是 89.1%。GPT-6 Luna 平均 0.05 美元,Claude Opus 5.5 平均 1.62 美元。 GPT‑6 Luna $0.05 Claude Opus 5.5 $1.62 同一套题 · 两款通过率均为 89.1%
Databricks 内部编码测试,每次任务平均美元费用。

看账单前先在价表上圈出日期

11 月 17 日,GPT‑6.2 Astra 的标准 API 降价。按每百万 token 算,输入从 10 美元降到 8 美元,输出从 50 降到 40,缓存输入从 1 降到 0.40。Sol 沿用上一代的价格。Artificial Analysis 当日测得 Astra 综合分高了一些,编程 Agent 指数持平。假如团队每次部署前都要让 Agent 跑完同一轮检查,就先问这轮里究竟读了多少旧上下文、写了多少新东西。OpenAI 6.2 发布说明OFFICIAL Artificial Analysis 发布日测评MUSTOFFICIAL

Google 第二天给 Gemini 4 Neon 的标准档开价,输入 3 美元、隐式缓存 0.15 美元、输出 15 美元,思考 token 算在输出里。Carbon 和 Argon 的价表有一道日期分界。11 月底前输入 2、输出 10 美元,12 月 1 日起变成 4 和 20。在本月和下月各跑一次同样的任务,账单可以不同。Google 发布 Gemini 4 NeonOFFICIAL Gemini API 标准档价格OFFICIAL

CursorBench 4.1 从真实会话里挑了需求不完全明确的多文件任务。Neon High 得 63.7%,平均每题 6.54 美元。Carbon High 是 61.5%、8.52 美元,前者在这套题里少花约 23%。可把 Neon 拨到 Extra High,分数升到 65.4%,平均费用也到了 10.67 美元。下次拿这张表来选模型,先看它跑的是什么题、开的是哪一档,再翻当天的价表。CursorBench 4.1 原始榜单OFFICIAL

还要看是哪一层在收费。DeepSeek 从北京时间 18 日中午起,让模型自己触发搜索和抓网页时,只收 token 费。你要是直接调用 Search 或 Fetch API,每千次成功请求仍各收 0.75 美元。一份报价单如果只写「带网页搜索」,这两种接法就很容易混在一起。DeepSeek 搜索和抓取官方价表OFFICIAL 全家桶 API 开放了什么,以及两种接法怎么验,见 专题 · 搜索快了,答案也更好吗?SELF。

同样 89.1%,一边五美分,一边一美元六角二

Databricks 用自己的合并请求出题,把验收用的测试藏起来。GPT‑6 Luna 和 Claude Opus 5.5 都通过了 89.1%,单次尝试的平均花费分别是 0.05 和 1.62 美元。看表时先盯住同一个分母,每发出一单就记一次费用,做砸的也算。采购前可以再把错题单独拿出来。两套的通过率相同,漏掉的未必是同一批 bug。一个总栽在团队最在意的那类问题上,便宜也得算上改错的工时。Databricks AI IndexMUSTTECHREADOFFICIAL

省下一轮强模型调用,值多少钱

Fireworks 先让 MiniMax M3.1 Flash 交卷,隐藏测试判它没过,再把题交给 Opus 5.5。账面上的节省来自那些第一轮就过的题。上线时用户不会附送隐藏测试。团队得决定用现成测试、程序检查,还是抽给工程师。主专题按 Fireworks 的通过率算了每道尝试题约 0.15 美元的余量,谁来验、验多久,都得从里面出。Fireworks 双模型路由实验MUSTTECHREADOFFICIAL

同一模型换个运行环境,账单也会动

RUNTA 和 Baseten 把模型和 harness 交叉搭配,GitHub 也在同模型、中档推理强度下横比三种 CLI。这里的 harness 是把提示、工具和执行循环接起来的运行环境。它跑了几轮、读过的内容能复用多少、半途超时后要不要重来,都会影响账单。专题《模型一换,最省钱的运行环境也换了》SELF GitHub Harnesses 发布记录OFFICIAL

同一份长文档,第二次来还要从头读吗

用户早上上传一叠合同,下午回来追问一处条款。如果模型版本和前缀仍然匹配,服务器可以复用早上读过的部分。AWS 11 月 16 日让 SageMaker 实时推理尽量把请求送回读过那段内容的服务器。18 日,ElastiCache 又开放了共享缓存,同组里的另一台 GPU 服务器也能接着用已经算好的 KV 缓存。前者换的是人往哪条队走,后者让换队的人也能带上旧笔记。SageMaker 路由发布说明OFFICIAL AWS 分布式 KV 缓存技术稿OFFICIAL

AWS 公布过两项最好成绩。自己托管模型的推理费最多降约 40%,等到第一个 token 的时间最多缩短约 80%。采购前先问,自己的客户隔多久回来、每次会发多长的提示、服务器还记得多少旧内容。如果每次输入都短而且不同,远端读缓存和维持缓存节点也要花钱。实际测试可以把同一批请求拆成首次、回访和中途换节点,分别记首 token、完整响应时间与 GPU 和缓存账单。AWS 分布式 KV 缓存技术稿OFFICIAL

小模型读合同,大模型能直接接着答吗?

AWS 那组实验是在同一套模型的服务器之间共享缓存。OneTriangle 这次试着让两款模型交接。先用 Qwen3.5-4B 读提示,把它留下的 KV 缓存转换成 Qwen3.8-27B 能接着用的状态,再由大模型写答案。发布帖给出百万 token 时最高 10.8 倍的首 token 加速,不能把这个峰值直接贴到 Qwen 这组的成绩上。Qwen 这组公开的 QuALITY 长文理解对照中,转换组得 0.84,大模型自己从头读得 0.94。做合同问答,可以先拿同一份材料查条款编号、金额和引文位置,再把命中率和首 token 延迟放在一起看。少等几秒,值不值得让模型漏掉那个数字?OneTriangle CEO 的发布帖 OneTriangle 的跨模型缓存成绩单OFFICIAL

对话中途改一个字,前面省下来的计算还在吗?

同一个 Agent 连续查几轮资料时,GPT-6.2 的 Responses API 能复用符合条件的旧推理记录。OpenAI 说明,记录和当时看见的对话前缀绑定。应用如果回头改掉一条旧工具结果,改动点后面的推理记录可能被丢弃,缓存也可能从那里失配。要改写 Agent 的工作方式,可以用同一条长任务做两组回放,一组在末尾追加更正,一组修订早先的输入。两组都要用更正后的事实交作业,再一起看新处理的 token、缓存命中、回答是否仍用了旧事实。先把答对这关过了,才值得为缓存改接口。OpenAI Developers 的 Responses API 说明帖 OpenAI API 文档 · 保持前缀不变OFFICIAL

扩展阅读

从查用量到核对交付成本
  1. 查用量

    先看 token 花在读旧内容还是生成新内容。

  2. 选执行路径

    决定在哪家服务、什么时段运行。

  3. 减少计算

    复用仓库经验,或改推理和索引的计算方式。

  4. 验收与归账

    核对省下的调用费和交付结果。

阅读正文 · 7 篇

查用量

token 花到哪了?大多用在重读旧内容

研究者整理了十周的真实开发日志,一共 42 个会话、752 段任务,API 报告的 token 中 94.8% 是读取已缓存的上下文。每生成一个 token,对应约 260 个缓存读取 token。论文用两套方法估算这批工作的用电,结果约 250 和 10 千瓦时,两套方法都没有在这种长缓存场景下做过实地校准。量电时应记清设备和实际功率。只看 API 账单,可以先把缓存读、重算、子 Agent 的调用拆开,别拿一列输出 token 去解释整个星期。42 个会话的 token 日志研究OFFICIAL

选执行路径

同一个请求,该找哪家、什么时候跑?

Hugging Face 把语言模型请求交给 OpenRouter,按价格、速度和可靠性挑供应方。Perplexity 11 月 17 日公布的 Orchestrator API 另提供自动选模型、按供应商状态与延迟分流,以及同一模型跨供应商重试。Google Cloud 则为支持的异步 Gemini 调用提供五折价格。Hugging Face 路由公告OFFICIAL Perplexity Orchestrator API 公告OFFICIAL Deferred tier 文档OFFICIAL

OpenAI 11 月 17 日也在 Responses API 公测后台时间窗。支持的模型按标准档计,选择两小时或八小时,模型 token 单价分别低 30% 和 40%。窗口从系统接受请求开始,以这一次响应为准。要是收到响应后还得查资料、再跑一次模型,用户等的是整件事交付。比较不同排队价时,把每轮等待和计费的重试记下来。OpenAI Responses API 后台时限与价格OFFICIAL

减少计算

同一个仓库,少花在重复摸索上

微软研究院与加州大学伯克利分校用 TokenEconomizer 复用同一仓库的经验,把重复发现的规则写成短笔记,缩减未用工具说明,并在反复失败时提醒换路。6 个仓库、277 道 SWE-bench 题中,5 组模型与 Agent 配置的平均单次成本降 18.4% 至 30.9%,已计插件自身模型调用,首次通过率有 4 组上升。刚开始积累经验的几题有时更贵。Microsoft Research TokenEconomizer 实验MUSTOFFICIAL

读提示和写答案,可以分给两种芯片吗?

Cerebras 用 AMD Instinct 做预填充、CS‑3 做逐 token 生成。公司披露,GPT‑OSS‑120B 的共享端点在该配置下每兆瓦吞吐约为纯 CS‑3 方案的 5 倍,生成速率持平。这是厂商在一个端点上的算力效率数据。每次任务的交付时间和价格还要单独测。Cerebras 拆分推理说明OFFICIAL Crusoe 与 dstack 在冰岛云节点上部署智谱 GLM‑5.3,并在固定的 64 张 GB200 上回放编码会话。48 个并发 Agent 时,合并部署更快,拆成预填充与生成两组可继续扩到 192 个并发 Agent。带着自己的平均并发和峰值再看单点吞吐,才知道该选哪种服务。Crusoe 与 dstack 的并发实测OFFICIAL

向量算快了,结果还能和原来对上吗?

Exa 与 AWS 11 月 18 日披露,他们有约 300 亿份优先处理的文档要重新算向量。把 Inferentia2 上的实现一点点调好后,同样时间里能处理约 1.5 倍的文档。评测要求新向量对参考模型输出的余弦相似度达到 0.999,并用 30 分钟满载测试确认表现。这里的收益是该嵌入流程的吞吐,任务价格还取决于设备成本和利用率。Exa 与 AWS 嵌入工程记录OFFICIAL

验收与归账

能省下的 token,可能还在帮你修错

另一份研究回放约 6,000 次编码任务,在同一补丁连续两次通过自测时提前停。预注册复验中模型开支省了 23%。这次复验还没能证明,早停后交来的补丁质量能跟原来一样。复用已经读过的材料,和让 Agent 提早收工,要分开测。编码 Agent 提前停止研究OFFICIAL

公司花的钱,能对到哪项工作吗

微软在 11 月 17 日的 Ignite 主旨演讲上发布 Agent 365 Business Analytics,并开始向 Frontier 客户开放。主管可以按服务和用途看用了多少、花了多少。系统还跟踪任务办成的比例、用户满意度,以及员工有多少工作时间得到了 Agent 的辅助。主管如果想知道哪类工单最费钱,可以先对着这些分类查,再回到后台抽样核实任务结果。微软把花费和业务指标放到同一个界面,指标的判定仍得按团队的验收规则来。Ignite Book of NewsOFFICIAL 微软 Agent 365 Business Analytics 文档OFFICIAL

接下来怎么看 换供应商时,拿同一批要交的活跑一遍。记录按时通过的数量、重试次数和人工真正花掉的分钟数。便宜一半的输出价格能不能兑现,跑完再看。关于硬件成本的变化,见 《推理成本的下限正在消失》SELF。 主专题算一算验收还有多少预算。

故事线 C · Agent 回归

双人播客
本周判断让 Agent 在同一个项目里再做一次昨天返工的活。它说了什么、后台变成什么样、需要谁批准,这三项都应有记录。

同事给 Agent 留了一句「帮我给这个项目开个测试环境」。过一会儿,Agent 回「已经好了」。同事点开后台,什么也没多出来。这回应该怪模型没听懂、文档写错了参数,还是账号确实没权限?Vercel 和 Together 把这样的请求当作测试,从第一步点进去,一直查到后台有没有留下新东西。EP.111 下周看点SELF Vercel 的 Agent 回归测试OFFICIAL Together AI 工程实践OFFICIAL

  1. 11-16Vercel 与 Together AI 公开用端到端任务测产品的做法。Together AI 工程实践OFFICIAL
  2. 11-17GitHub 公测 Copilot Evals。GitHub Copilot EvalsOFFICIAL
  3. 11-18Foundry 更新长任务恢复和语音 Agent。Ignite 后续 Foundry 发布记录OFFICIAL
一项真实任务,接着重复跑同一题,接着验收与回归 一项真实任务 重复跑同一题 验收与回归
一项真实任务可以变成持续重跑的验收用例。

Agent 说已经建好了,后台怎么没有?

Vercel 用 Harbor 跑完整的用户任务,Together 用真实请求查工具说明和 Skills 能不能让 Agent 少走弯路。就用上面那个测试环境当例题。录像能看出它找没找到按钮,请求日志能查出它有没有填错项目,最后直接查后台记录。把文档重写之后,账号、模型、工具权限都按原样留下,再给它同一句话。这样才知道是改对了说明,还是刚好换来一个碰巧能做对的模型。Vercel 的 Agent 回归测试MUSTTECHREADPICKOFFICIAL Together AI 工程实践MUSTOFFICIAL

上次改错了环境,这次还会吗?

GitHub 给 Copilot Evals 开了公测。团队可以给某个 skill、自定义 Agent 或 MCP 工具录入真任务和通过条件,在本地比较新旧配置,运行前需要人工批准。Adaptive Review 另按 PR 的复杂度与风险调审查档位。假如上次 Agent 把改动写进了默认环境,就把那句请求留着。下次给它同样的账号权限再跑一遍,然后打开后台,看看这次到底改了哪套环境。GitHub Copilot EvalsOFFICIAL GitHub Adaptive ReviewOFFICIAL

GitHub 18 日还给 CLI 2.105.0 加了 PR 事件监听预览。Agent 发出 PR 后可以等审查提交、检查完成或分支更新的消息,不必不断问服务器「好了吗」。事件来了也有个问题。新的补丁也许已经推上来,旧提交的绿灯只能说明旧补丁。在回归题里把事件和提交 ID 一起对,才能发现这种错用旧结果的情况。GitHub CLI 事件流变更日志OFFICIAL

Agent 交来补丁,审查规则听谁的?

Claude Code 从补丁要合进去的分支拿 REVIEW.md,也可以从默认分支读。这样,Agent 即使在自己的 PR 里顺手改了规则,这轮审查也照团队原来的要求来。连续三轮没过,再请人接手。加一条新检查时,先看看它会拦住哪些补丁、有没有拦错,再让它真的挡住合并。Claude Code 团队的验收门禁MUSTOFFICIAL 量子代码也碰到同一个问题。一次评测审计只改评分规则,就把同一批答案的成绩改了九十多个百分点。专题《AI 写出量子电路,怎么知道它做对了?》SELF

客户又遇到同一个错,怎么测它真的修好了?

一个客户每周都因为同一种错误回来找客服。微软在 Ignite 演示的做法是先翻 Agent 跑过的记录,找出哪些错一再发生。再请懂业务的人写明遇到这单该怎么办,让 Agent Optimizer 试着改设置,最后拿同一批工单比新旧版本。整理线上故障的功能已经正式可用,请专家标注、自动建议怎么改和优化费用还各在不同的预览范围。Copilot Home 正式可用,Autopilot 则向 Frontier 客户分批开放。微软和 Salesforce 同日公布的 Copilotforce 插件进了公开预览,Teams 内的 Sales Cloud 仍在试点,受支持的写回动作要由用户确认。Microsoft IQ 与 FoundryOFFICIAL Ignite Book of NewsOFFICIAL Copilot 发布明细OFFICIAL Microsoft 与 Salesforce 联合公告OFFICIAL

11 月 18 日,Foundry 讲清了三种功能分别管什么。长任务恢复已经正式可用。程序崩了,重启时会再跑一次处理函数,做到哪一步得由应用自己记下来。还在公测的内存快照能省掉启动时的重复加载。启用快照之后,会话空闲超时,原来的内存和本地文件会丢。出站网络控制已正式可用,能由沙盒外的规则决定 Agent 可以连到哪里。跑测试时可以分别让进程退出、让一轮会话空闲超时,以及尝试请求一个禁止访问的测试地址。三个问题往往需要找不同的负责人。语音 Agent 也已有正式发布说明。Ignite 后续 Foundry 发布记录OFFICIAL Foundry 托管 Agent 上线说明OFFICIAL Foundry 语音 Agent 正式可用OFFICIAL

要追更新的发布状态,可以沿微软的直播公告和技术博客继续看。Ignite 官方直播公告OFFICIAL

Agent 换了模型,之前调好的那套还管用吗?

双人播客

想象一套客服规则已经用了一年。前台的模型换了,负责上线的人不想再调一遍,还希望昨天那些难题原样能过。Google 用换模型和换题集的办法试过旧配置,Meta 问的是另一件事,记住的办法能不能训练进模型。两组结果得分开看。

Google 测旧配置和旧实验记录能带走什么

Google 团队固定题集和数据划分,把为 Claude Opus 5.5 优化过的运行配置交给 Gemini 3.8 Flash。四类任务的起始成绩都低于 Gemini 使用初始配置时的成绩。在另一组编程实验里,研究者固定模型,从 Terminal-Bench 2.1 换到 TB4。两组从同一套优化过的配置出发,使用相同的迭代轮数和候选预算。带上历史改动的原因、预期和评测结果后,10 组配对实验有 9 组最终成绩更高,平均高 2.36 分。下次换环境,把每条旧规则当初解决了什么一起带过去,再拿新任务跑一遍,看看哪条该留、哪条要改。Google 团队的 SIM 迁移实验OFFICIAL

Meta 测记忆策略能不能学进模型

Meta 用 Kimi-K2.6 寻找更合适的记忆读写指令。在数据库、代码库和 Spectrum 三项持续学习任务上,发现的指令平均得 56.0 分,最佳人工指令是 44.6 分。接着用较好指令跑出一批轨迹,把其中的指令换回通用版本,保留模型原来的操作和回答,再拿这些轨迹微调。用通用指令测评,得分是 43.1。用通用指令生成的轨迹做同样的微调,得分是 37.6。这支持在三项任务里把部分记忆策略学进模型权重。Google 研究的实验记录则留在优化器可以查阅的外部记忆里。Meta 的 Self-Improving Memory 实验OFFICIAL

旧规则先拿新客人的题试一次

ARISE 从办砸了的任务里找例子,让模型写下下次该怎么做,把相近的经验合成几条能查到的规则。写完再用事先留作考试的题跑一遍,表现好才留下来。测试涵盖 14 个业务领域、5 款模型;用 Claude Opus 4.6 做归因和合并时,论文报告 SOP-Bench 提高 10.9 个百分点,τ²-bench 提高 5.8 个百分点。ARISE 不改部署模型的权重或工具。换模型的当天,可以给新版本同一套旧规则,外加一组训练时从未看过的客诉。旧规则若把新问题也处理得更好,才留下来。ARISE 论文OFFICIAL

换模型时,固定题集

把相同的旧任务、输入快照、工具版本、权限、评审规则和时限给三组配置。先跑旧模型加现用配置,再跑新模型加初始配置,最后跑新模型加旧配置。后两组的差距能回答旧配置对新模型还有没有帮助。用同一批题重跑几次,分开记做对多少、做对一道花了多少钱,以及九成五的任务多久能做完(P95)。开跑前先约好最多能接受多少退步,检查账号权限和关键写入时,两边用同一套规则。

换题集时,固定模型

旧题留着,检查原来能做的事还能不能做。新题分两份,一份拿来调设置,另一份先收起来,等设置改完了再用它验收。比如退款流程加了一次人工复核,验收时先查旧任务还能不能完整退款,再查新任务是否停在审批点,以及进程重启会不会多退一次。把每项改动的原因、通过和失败的用例一起记下来,下次换环境可以针对它重测。

本刊怎么看 换模型先用同样的题和旧规则测,换题集再把留出的旧题一起跑。Agent 可以建议下次怎么改,最后能不能上线,还是由团队照原定的验收规则决定。

把上线故障提前搬进测试环境

11 月 17 日,Anthropic 工程团队复盘 9 月上线的 Claude Docs。上线前,他们用了约两周让 Agent 在预发布环境里反复压测和演练故障。文档多久能打开算一项,点了保存再掉线、重新进来字还在不在又算一项。难以撤回的动作留给人批准。按公开 API 价算,团队估计整段工程期的推理值约 12.5 万美元。这个数字只对应模型推理,没把产品工程师工作的价值换算进去。Claude Docs 工程复盘MUSTTECHREADOFFICIAL

为测结账,上次还得从登录一路点过来

如果 bug 总在菜单深处才出现,每次改代码就先从登录、建项目、导入文件一路点过来。9 月的 StatePortal 论文给了一个做法,把这段准备变成可恢复的检查点。论文用了 10 个应用里的 61 道题。同样让 GUI Agent 看着屏幕点,把它直接送到已验证的起点,完成率从 0% 涨到 10.4%。完整系统还能走应用预留的入口来做最后一步,完成率到了 27.5%。研究另做了 1,361 次检查点重放,98.90% 重现原有判分,全程不用再叫模型。只看后台状态仍会漏掉界面故障,文章用画面和程序状态各查一遍。StatePortal 论文与 DeepStateBenchOFFICIAL背景 · 2026-09-29

开发团队可以先给一个天天要查的故障存现场,比如余额已扣、订单还显示处理中。每次上线先恢复到这里,看看页面和后台是否一起走到下一步。从登录开始的整条路径仍有自己的测试,检查点把最费重复工夫的那段准备剪掉了。

扩展阅读

从分配权限到改进下一轮
  1. 定身份和工具

    先确定谁能用哪些工具、以谁的身份操作。

  2. 跑一遍任务

    在真实界面或模拟器里走完操作。

  3. 查交付结果

    逐项看容器、回归测试、后台流水和代码合并。

  4. 调整下一轮

    用成功和失败记录决定继续委派什么、先修哪里。

阅读正文 · 11 篇

定身份和工具

同一个退款按钮,Agent 用谁的账号按?

LangChain 19 日公测 LangSmith Tool Gateway,把工具请求先送到一个入口。经办人查自己的客户记录,可以用经办人连好的账号。夜里自动跑的任务,也可以用专门给 Agent 的凭证。公告展示了如何在写入前请人确认。打开调用日志后,团队能看到工具名、用户、结果和耗时。接回前面的退款例子,让两个权限不同的账号各试一次,记下那一步是谁批准的,再到支付后台看钱有没有退。LangChain 的 Tool Gateway 公告OFFICIAL LangChain 联合创始人的帖子

两个部门用同一个 Agent 模板,它能看同一份文件吗?

Ignite 期间,微软 19 日补了一份 Foundry Autopilot 的技术说明。想象工程和财务都需要一个 Agent 跟进项目。开发者先写模板,规定它会用哪些 API 和 MCP 工具。管理员批准模板后,两个团队各建一份实例。每份实例有自己的 Entra Agent 用户账户和负责人,项目、邮箱和资料库要另授权限。一个角色学会去 SharePoint 写记录,采购单和财务文件也不会因此对它自动开放。微软 19 日 Foundry 团队 Agent 说明OFFICIAL

这和前面的 LangSmith 放到一起看,LangSmith 问每次调用该用谁的凭证,Foundry 还要有人长期管理这份实例。我的判断是,最容易被漏掉的验收在第二天。先给发版 Agent 一份临时读权限,用它发一份周报。再撤掉权限,测试下次无人值守的运行还能读到什么,群里来了新成员时它又会不会把旧结果发出去。把能用哪个工具、能读哪份文件、能把结果发给谁分开验,事后才说得清哪里出了问题。微软 19 日 Foundry 团队 Agent 说明OFFICIAL LangChain 的 Tool Gateway 公告OFFICIAL

浏览器能接管,工具也得能重验

Foundry 的托管浏览器支持实时查看、人工接管和会话留痕,私网接入仍在预览。多个 Agent 共用一个工具箱时,Foundry 支持集中维护工具版本,通过一个 MCP 入口复用,并可查看不同 Agent 的成功率和错误。正式可用的 Dev Pack 则让 CLI、VS Code 工具和 Copilot 插件共用项目文件。团队升级共享工具时,可以拿原有任务重跑一遍,也能回看人工接手时停在哪一步。Foundry 浏览器工具与人工接管OFFICIAL Foundry 共享工具箱公告OFFICIAL Foundry Dev Pack 公告OFFICIAL 延伸阅读见 站内深潜:Agent 住进浏览器之后怎么量边界SELF。

跑一遍任务

手机上那条熟路,能不能只教 Agent 一遍?

想查港大附近的酒店,可以先在小红书找名字,再打开携程查同一家。港大团队的 PhoneGo 会先把 App 的常见页面和跳转记成一张图。遇到走过的路,直接照着点;页面变了、认不出来,再请视觉模型看屏幕。作者在同一台手机上试的是另一道小红书题,查怎么预约参观港大。两边都找到了答案,按图走用了 17 步、64 秒,逐屏交给视觉模型用了 32 步、146 秒。手机负责操作,陌生页面的截图会发给你配置的模型服务。App 改版后,先重跑旧任务,再查卡住的地方是不是导航图过时了。PhoneGo 真机对照与实现GITHUB PhoneGo 0.4.2 发布记录GITHUB PhoneGo 分享原帖

把模拟器折起来,支付按钮还按得到吗?

Claude Code 桌面版开放 iPhone Duo 模拟器测试的公开 beta。Agent 能折叠和展开模拟设备,再检查两个布局。给它一张结账工单,可以要求先填购物车,切换姿态,再继续结账。两种布局都查按钮有没有被挡住,切换前填好的东西是否还在,最后在测试后台查是否只生成一张订单。Agent 多了一种能操作的环境,发布前还可以把这一条变成每次都重跑的回归题。Claude Code 的模拟器发布帖 Claude Code 文档 · iOS 模拟器OFFICIAL

查交付结果

Agent 说跑完了,容器里留下了什么?

阿里云 11 月 18 日披露,用相同的 Qwen3.7 Plus 比较 DeepSeek Harness 和 Codex。AgentLoop 在 10 道 Terminal‑Bench 2.1 题上检查执行完的容器状态,再按任务完成、合规和执行过程评分。两套 harness 各有 8 道题计为通过。同一道题中,DeepSeek 的产出通过验证,运行超时把得分封顶在 0.5。做回归时可把产出验收和运行时长各留一列。阿里云 AgentLoop 评估实践MUSTOFFICIAL 检索如何做对照,见 专题 · 搜索快了,答案也更好吗?SELF。

固定输入之后,CI 和性能回归各能验什么

Attest 作者 11 月 15 日用一个模拟退款 Agent 演示,在 CI 回放固定的模型响应,检查工具调用及最后留下的状态。这适合稳定地重放已知故障,模型升级还要重新实跑。Accelerate Bench 则给 32 道 CPU 优化题配独立验收。作者重跑发现,同一份源码只改构建和运行设置,实测速度就可在基线的 0.29 倍到 2.12 倍间变化。做速度回归也要把编译和运行设置随结果一起保存。Attest 作者的 CI 回放演示OFFICIAL Attest 合成退款任务演示GITHUB Accelerate Bench 预印本OFFICIAL

代码最后合进去了吗?

一篇利用 Fable 5 短期下线的预印本跟踪 297 位 Fable 使用者,并用 8,908 位开发者作对照。七日 PR 合并率估计提高 1.4 个百分点,区间为 −1.4 到 +4.3,跨过零。这个样本只测了特定人群和产出指标。想知道自己的工具有没有帮忙,最好直接看团队定好的验收用例和交付结果。Fable 5 下线自然实验预印本MUSTOFFICIAL

调整下一轮

同样要做几个小时,哪些研发活可以交给 Agent?

OpenAI 11 月 18 日对自家已委派任务做了回顾。3 至 10 月,原估人工需 2 至 4 小时的任务,无人工干预成功率估计由 23% 升到 46%,4 至 8 小时那组由 13% 升到 35%。团队会改变交给 Agent 的任务,结果也随样本构成变化。按任务类别看,监测训练运行约 79% 能独立完成,写推理和服务栈代码约 25%。10 月中位研究员的日用量按公开 API 标价折合 2,400 美元,报告未给实际结算额。OpenAI 内部研发委派报告MUSTOFFICIAL RSI-Infra Bench 的预览版给了另一种测法。每道真实训练任务限时 10 小时,允许 Agent 多轮自测,时间到了再单独验速度和训练结果。这样可以区分找到优化点、把改动做完、最终验收三个环节。RSI-Infra Bench 预览报告OFFICIAL

失败记录最后改的是配置,还是模型

Prime Intellect 11 月 18 日公布 Model Factory,把托管训练、推理部署和评估放在同一套管理界面。Prime Traces 能记录一次任务调用过的工具、经过的步骤和失败的位置,团队可以挑出其中一些例子,用在下一轮训练里。拿退款举例,如果问题出在支付服务没回执,先改状态查询和对账。如果是模型总把取消订单读成退款,才有理由把案例留作训练,再拿从未见过的工单检验。微软的 Agent Optimizer 可以先提配置修复。无论改的是设置还是模型,上线前都用事先留好的工单再跑一遍。看看旧毛病修没修好,原来能办成的事有没有被改坏。Prime Intellect Model Factory 公告OFFICIAL Ignite 后续 Foundry 发布记录OFFICIAL

接下来怎么看 等下一次更换模型或者工具版本,把失败过的旧请求原样交回去。只要再出现一次重复退款、未经批准的写入,或一单重启后始终没人认领,就留着事件和后台记录开一张故障单。长任务的另外几种量法见 《LHT:当评测开始用「小时」做坐标轴》SELF。 到 Epoch 专题看什么能自动验、什么需要人签字。

便宜模型先跑,省的钱够不够验收?

双人播客

有一张旧仓库的工单等着修。你能请贵的模型通宵做完,也能先让便宜的试一遍。后一种听起来合算,直到你发现还得请人看补丁。Fireworks 手上有每道题的隐藏测试,能知道该不该换人。拿这份公开账单算一遍,看看真实团队最多能花多少钱把第一道关守住。Fireworks 双模型路由实验OFFICIAL

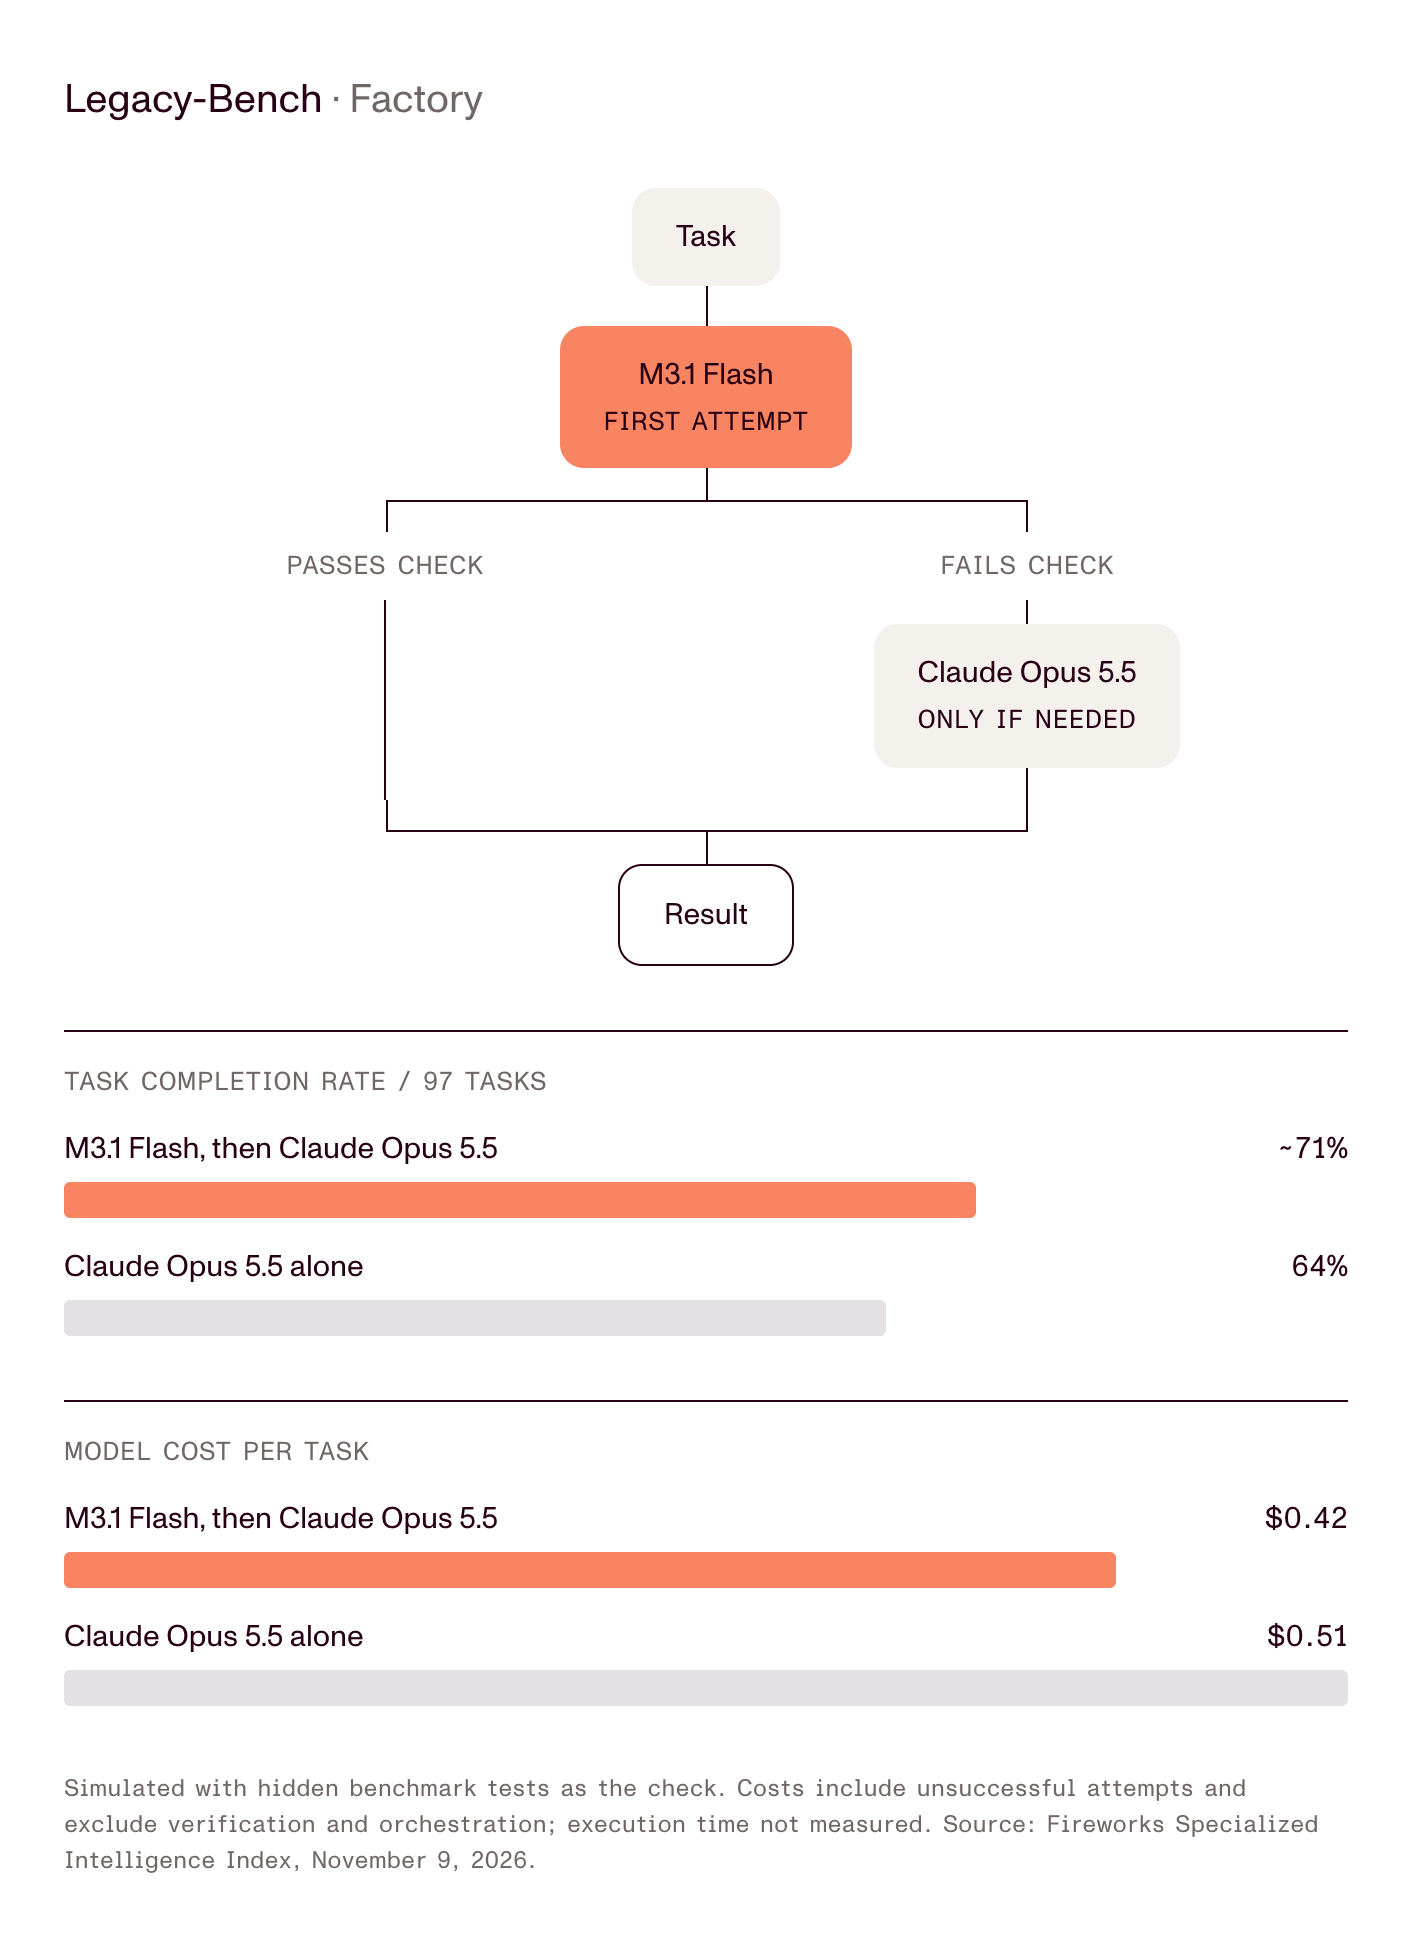
0.15 美元怎么算

Fireworks 用 Legacy-Bench 的 97 道旧代码维护题做了接力模拟。单跑 Opus 平均每道尝试题花 0.51 美元,通过率约 64%。接力平均花 0.42 美元,通过率约 71%。用这组公开的约数计算,把每道尝试题的平均费用除以通过率,就把失败题花的钱也计入了每道通过题。这样算,单跑每通过一道约花 0.797 美元,接力约花 0.592 美元。把单跑每道通过题的成本按 71% 折回每道尝试题,再扣掉接力已经花掉的 0.42 美元,就是验收和编排能用的余额。

每道尝试题的验收预算 = 0.71 × (0.51 ÷ 0.64) − 0.42 ≈ 0.146 美元,约 0.15 美元。

不同验收与编排费用下,每道通过题的成本(美元)
接力每道尝试题多花接力每道通过题单跑每道通过题
$0.00$0.592$0.797
$0.05$0.662$0.797
$0.10$0.732$0.797
$0.15$0.803$0.797

什么条件下成立

Fireworks 知道每题的隐藏测试结果,才知道哪道题该升级。它公开的账单只记模型调用。这里沿用单跑 Opus 的每道通过成本作比较,把接力通过率固定在 71%,单次尝试的模型费固定在 0.42 美元。验收、编排和人工复核要摊到所有尝试题上。换了判错方式,要重新量通过率、升级次数和长尾等待。 若接力通过率掉回 64%、模型费用仍是 0.42 美元,额外预算就剩 0.09 美元。真的多花 0.15 美元时,接力每道通过题的成本已略高于单跑。Fireworks 双模型路由实验OFFICIAL

Fireworks 的 Legacy-Bench 实验图,比较直接用 Claude Opus 5.5 和先用 MiniMax M3.1 Flash 再转交的通过率与平均成本。
看 97 道 Legacy-Bench 维护题的数据。单用 Opus 约 64% 通过、每道尝试花 0.51 美元。先用 Flash、失败再交给 Opus,约 71% 通过、每题花 0.42 美元。正文的 0.15 美元由这两组约数推算。 Fireworks,原文 Legacy-Bench 实验图

验收错一次会发生什么

有些错一眼看不出来,有些好补丁反而会被规则拦下。坏的漏过去,账面上就多了一道假装完成的题;好的被拦,又要花一轮强模型的钱。另一篇实验让 Agent 对同一补丁自测两次再决定停不停,模型费省约 23%,复验仍没能证明质量不下降。编码 Agent 提前停止研究OFFICIAL

用模型验收也可以接力。9 月的 JEV-as-a-Judge 预印本留了 1,610 对文本答案给裁判,低置信的 31.5% 才转交 GPT‑6。总体判对 93.4%,单跑 GPT‑6 为 92.5%,费用为后者的 41.4%。但样本里 83% 是 RewardBench。遇到更难的 JudgeBench,约 65% 得找大裁判。拿这结果给代码验收定预算时,先数数自己的难题。测试能直接判对的部分,还是交给测试。JEV-as-a-Judge 预印本OFFICIAL背景 · 2026-09

一张工单什么时候该交给下一棒?

  1. 小模型先修记下这一轮调用费和用时。
  2. 用独立测试或人工验收在这里记验收的钱和等待。
  • 按时通过交付补丁。抽查少数看似过关的题。
  • 没过或超时交给强模型,重新验收。把两轮费用都记上。
Fireworks 的实验用隐藏测试判失败,超时是另一篇论文比较的转交条件。两份实验的费用单位分别是 API 美元和 GPU 小时。Fireworks 双模型路由实验OFFICIAL SWE-bench 超时接力实验OFFICIAL

等小模型多久,才值得换人

有些活是交给 Agent 排队干的,等一会儿也没关系。Boxi Zhou 等人用 SWE-bench Verified 全部 500 道题做了另一份对照。作者先收集每种模型单跑的轨迹,再模拟 GLM‑4.7‑Flash 先跑,失败或超时后由 GLM‑4.7 重新开工。小模型最多有 120 分钟。与单跑大模型相比,总量从 2,585 降到 2,160 GPU 小时,省了 16.4%,解题率没有下降。容易的题单独看省约三分之一。SWE-bench 超时接力实验OFFICIAL

这账换成用户等待就有另一面。走到第二轮的任务,已经等了小模型一程,还得从头等大模型。实验隐含了两项很划算的条件,约 91% 的题是容易或中等难度,交卷后也有测试可判对错。你要是正在和 Agent 对话排 bug,拿后台一批工单的结果来估交互延迟,多半会少算那一段等待。上线可以固定住最终验收,然后让小模型分别跑短窗口和长窗口,把按时通过的那一列与 GPU 开支一起看。SWE-bench 超时接力实验OFFICIAL

上线该怎么对账

Databricks 的另一组编码题里,Gemini 3.8 Flash 的 token 单价较低,平均却跑了 140 轮,每题花 11.97 美元。选型时可以拿同一批任务对测,给两边用相同的验收标准和时限。把模型、工具、验收、失败返工和人工开支都加起来,再除以按时通过的独立任务数,同时记下升级比例和尾部延迟。测试反馈快、答案容易验的任务,先试接力最容易测出账。Databricks AI IndexOFFICIAL

本刊怎么看 这组题的预算是每道尝试约 14.6 美分。验收加编排贴近这个数时,先拿真实失败样本和长尾时延重算。

卡堆到一万张,训练快了多少?

双人播客

一个机房有多少卡,好写进新闻。难回答的是,多买一批之后,哪段训练真能缩短。MLPerf Training v6.1 同周摆出了 DeepSeek-V3 的 10,240 卡提交,也给了同一代设备在更小规模上的成绩。Xing4 则拿出两类昇腾集群的记录。一次是为了找到哪一环慢做的实验,另一次是模型实际预训练时用的配置。MLPerf Training v6.1 分析OFFICIAL Xing4 训练技术报告OFFICIAL

十倍的卡,到训练时钟上剩几倍

MLCommons 按 NVIDIA 的 Closed 成绩做同一代 GB300 的对照。256 卡到 1,024 卡,卡数乘四,测得用时缩短到约 1/3.9。从 1,024 卡到 10,240 卡,卡数再乘十,用时缩短到约 1/5.8。两段都变快,后一段每加一张卡带来的收益小了。换成 Llama 3.1 8B,小模型在 Vera Rubin 的 72 到 512 卡之间,卡数接近七倍,用时只缩短到约 1/1.9。MLCommons 用这一组解释批大小够不够把更多卡喂饱。MLPerf Training v6.1 分析TECHREADOFFICIAL 单看第二段,假设所有设备在各自记录的达标时段内一直分配给这次训练,卡时约为 10 ÷ 5.8,即原来的 1.72 倍。这是按基准用时算出的占用量,账单还要看电力、节点价格和租用时间。

卡与卡之间传什么,比一共有多少卡更值得看

以专家混合模型为例,一个 token 根据路由被送去少数几个专家。虽然不需要每张卡都算完整模型,专家分到几张卡上以后,卡之间要先发 token、再收计算结果。两个 10,240 卡 GPU 提交都把频繁交换放在机柜内的 NVLink 域,跨机柜再传流水线中间结果和梯度。Google 的 8,192 芯片提交在同一个 ICI 切片里组织专家组。这是三种配置如何跑同一题的记录,采购时还要把功耗、网络以及调度等待带回自己的园区。MLPerf Training v6.1 分析OFFICIAL

三类训练证据能回答的问题
记录这次确实量了什么还要问什么
MLPerf 同代设备扩卡DeepSeek-V3 在相同基准规则下,不同 GB300 卡数的达标用时换成自己的模型、批量和网络之后,曲线会在哪里变平?
Xing4 性能剖析1,024 张 NPU 上的每步时间和算子开销三项单独验证的优化一起上,收益还能留下多少?
Xing4 生产预训练团队报告 2,850 亿参数版本用了 8,192 张昇腾 910C完整训练的有效吞吐、停机重启和总节点时是多少?

1,024 卡看优化,8,192 卡看训练能不能跑

星辰报告把预训练的权重、优化器状态和长序列放在两级网络上调度。同一 SuperPoD 内做更频繁的数据交换,跨组用更粗粒度的同步。在 1,024 卡剖析中,基准的每步时间是 31.8 秒。三项改动各自对基准减少约 9.1%、6.9% 和 15.2%,作者逐项测,三个比例不能直接相加。8,192 卡是 2,850 亿参数模型的生产预训练配置。报告同时谈到开放的 29B 版本,也提到仍在进行的万亿参数训练,读表时别把这三种规模当成同一个模型。Xing4 训练技术报告MUSTTECHREADOFFICIAL

两座机房隔着一条慢线,训练怎么接着跑?

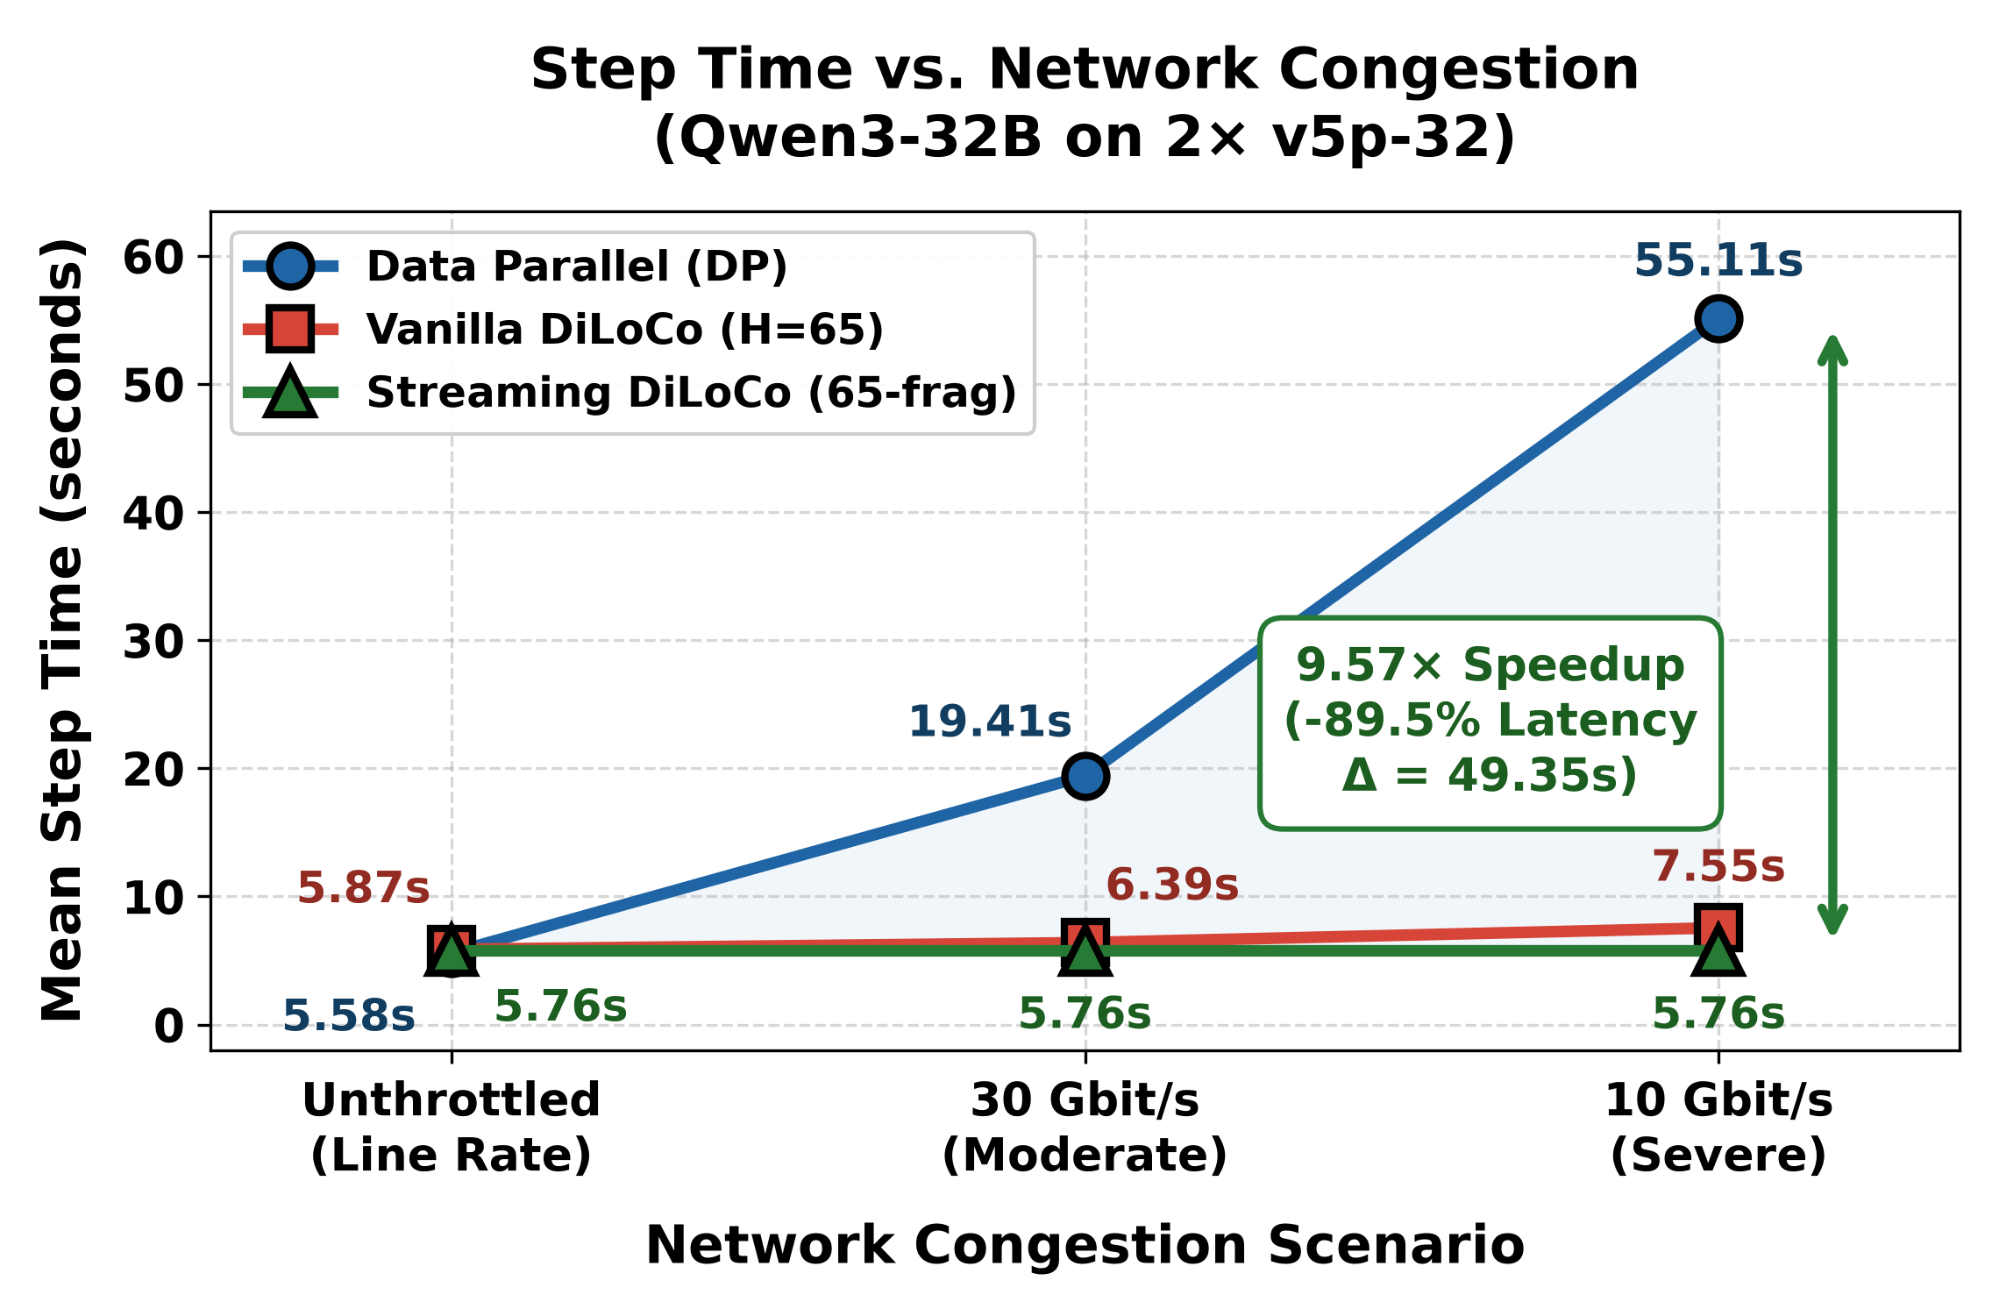
手里差一批卡时,隔壁城市刚好还有空集群,能不能拉进来一起训练?Google 19 日公布了 MaxText 的 Streaming DiLoCo 实验。普通数据并行每步都要和远端对齐梯度。DiLoCo 先让各地自己跑一段,再交换这一段里权重怎么变了。Streaming 版把要交换的内容再分块,一边训练一边传下一块,免得等到第 65 步才把整份更新一口气塞进带宽。Google MaxText 的跨机房训练实验MUSTTECHREADOFFICIAL

Google 用 Qwen3-32B、两组 TPU v5p-32,主动调低两组之间的带宽。不限速时,几种方法每步都在约 5.6 到 5.9 秒。限到 10 Gbit/s,普通数据并行慢到 55.11 秒,DiLoCo 要 7.55 秒,Streaming DiLoCo 是 5.76 秒。9.57 倍的差距来自这条受限链路,换回畅通的链路,差距就很小。

这让异地闲卡更有机会派上用场。算一笔训练账时,还得追到同样的数据、同样的验证损失,看两边各要多少步、总共用了多少卡时。如果每一步快了,却要多跑很多步才追平,省下的等待也可能被吃掉。等这两笔卡时都算出来,才知道异地的卡值不值得租。Google MaxText 的跨机房训练实验OFFICIAL

Google 把三种训练方式放到不限速、30 和 10 Gbit/s 三种链路条件下对比平均每步耗时。
先看不限速一栏,三种方法挤在一起。再看 10 Gbit/s,逐步同步梯度的那一组高了很多。这张图量每步耗时,开跑到达标要多久还需再量。 Google Developers Blog,MaxText 实验图 2

下一次公开披露,追哪三个数

拿到两份集群成绩,先问是不是同一个模型、同一批数据、同样的达标目标。再记三件事。从开跑到达标等了多久,所有卡加起来跑了多少小时,中断又白跑了多少步。加卡可能让模型更早达标,也可能用掉更多卡时。

本刊怎么看 训练集群的可用性要用任务说话。把扩卡曲线和最后一次能恢复的检查点一起公布,比单报峰值卡数更容易判断下一批设备值不值。

模型一换,最省钱的运行环境也换了

双人播客

同一个模型,用两个命令行工具跑同一张工单,账单也可能差一截。RUNTA 和 Baseten 排了 62 道终端任务、5 款模型、22 个运行配置,每种组合跑四次,共安排 27,280 次运行。每次都重新开一套独立环境,推理开到最高档。原本以为选定模型之后选个顺手的工具就好,这张表里,换五款模型,一共出现了五个各自最省钱的运行环境。FrontierHarness Eval v1.1OFFICIAL

先分清上榜的是每道题,还是每道过关的题

把平均每题花费排一遍,Codex CLI 配 GLM-5.3 排首位,配 Kimi-K3 则到第 16 位。换成每道通过题成本,它配 GLM-5.3 约 0.803 美元,配 Kimi-K3 排第十。两个名次出自同一数据,却回答不同的采购问题:需要把一天所有来单跑完,还是需要尽量多交出过关的结果。站在后者的账本上,失败题同样要付钱。FrontierHarness Eval v1.1MUSTTECHREADPICKOFFICIAL

一笔失败费,能追到账单的哪几行

按作者纳入评分的运行和 API 标价,失败用了 52.7%,超时用了 11.8%,两者合计 64.5%。有些失败在时限前就交了最终答复,因此客户端看起来像正常结束。作者在一对 DeepSeek 配置里还看到,Cline CLI 的缓存输入占 86%,OpenCode v1 占 97%,前者总输入也更多。要找差额,把调用次数、每步新增长度和缓存命中一起记,单看缓存率看不出来一题重跑了多少次。FrontierHarness Eval v1.1OFFICIAL

工具还没用,为什么先读了十四万 token 的说明?

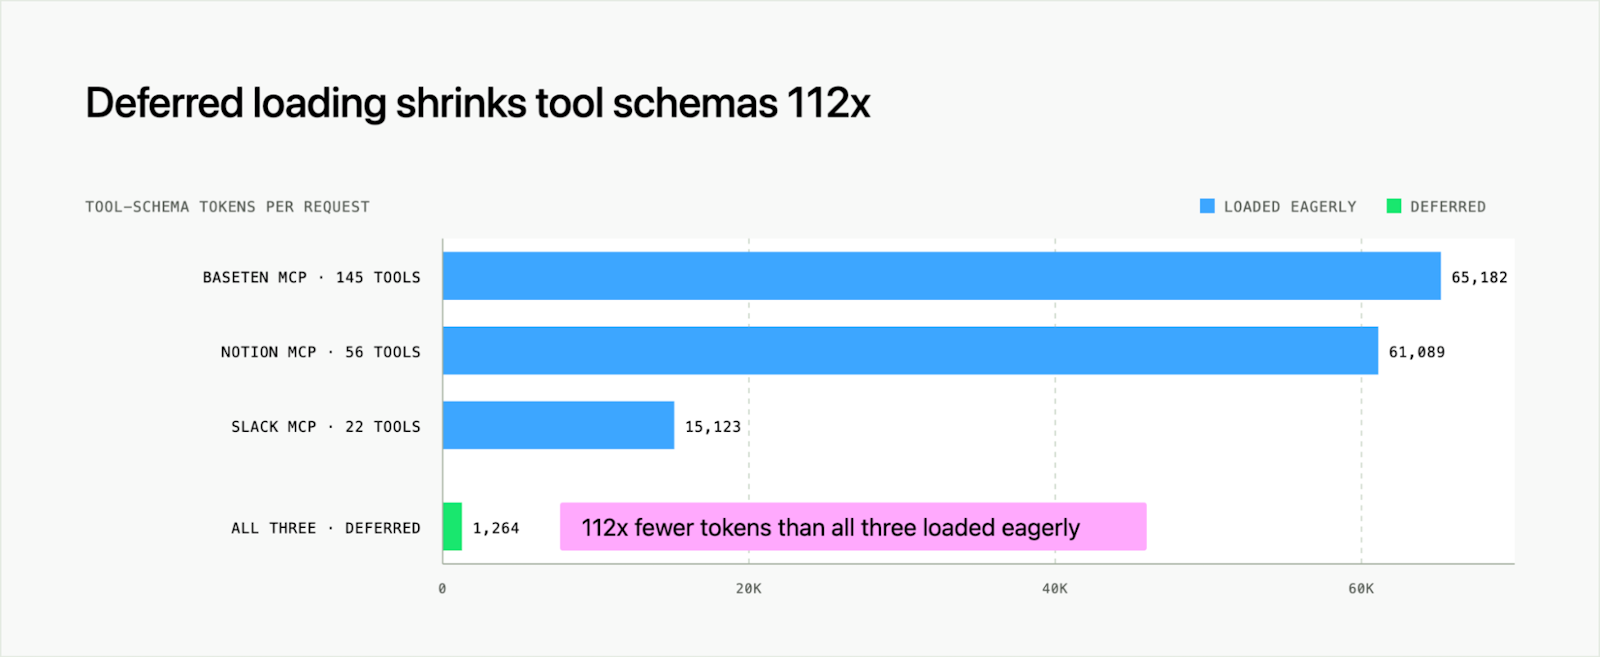
让 Agent 修一行代码,它可能先收到 Slack、Notion 和其他工具的完整说明。Baseten 在 Claude Code 连了三个 MCP 服务,工具说明一开始约占 14.1 万 token。改成按需加载,先给工具名和一个搜索入口,找到要用的工具才把说明接到对话末尾,起步约 1,300 token。旧前缀还能命中缓存。缓存省去的是重算旧内容,新 token 生成时仍得回看那些旧内容,所以少带一本说明书,热缓存也能受益。Baseten 推迟加载工具的实验TECHREADOFFICIAL

他们让同一个 GLM 5.3 做 8 套基准里抽出的 55 道题。编码题平均费用降 62.5%、耗时降 26.2%。多工具任务的平均费用降 51.1%、耗时降 14.9%。个别基准反而慢一点,工具用得特别多的一组里,一开始就把工具说明给齐更有效率。这个差距很可能随你接了多少工具、每道题又用几个工具而变。

我的判断是,常做的任务只调用两三个接口时,先动工具说明,往往比急着换模型更划算。验收时要看办成一项任务花多少钱。比如本来能完成的退款题,缩了说明后找不到对账工具,省下的几分钱最后很可能被人工返工吃掉。把没找着工具的次数、最慢的一批要等多久、最后办成了几件事一起记下来。Baseten 推迟加载工具的实验OFFICIAL

Baseten 对比事先加载全部工具说明与按需加载时,开始交给模型的工具说明 token 数。
这里缩短的是开场时塞进去的工具说明。别把工具说明少了多少倍,直接抄成每道工单会少花多少美元。 Baseten,原文的工具说明对照图
  • 52.7% 失败
  • 11.8% 超时
  • 35.5% 通过
RUNTA 纳入评分的运行,按 API 标价折算的费用分布。分母是花费。FrontierHarness Eval v1.1OFFICIAL
更换运行环境的成本试跑
固定项比较项怎么算过关
同模型、同服务商开同一批任务,比较工具回合、缓存和超时每道通过题的总花费,失败与超时照样入账
同一运行环境换模型相同权限、同一批题和时限,保留工单级结果确认高频任务改善,困难任务的尾部耗时可控
换计费档或短任务编排分开测冷缓存与热缓存,下游人工验收仍计时省下的钱能覆盖返工,还能在原定期限内交付

榜单先挑几套,拿自己的新题再比一次

作者从 62 道任务重抽样 4,000 次。GLM-5.3 那组的 Codex CLI 有 99.6% 仍排首位,Kimi-K3 那组最常排在前面的 Alma 只占 25%。报告估计一些通过率的 95% 区间宽约正负十个百分点。排位靠得近的几套可以都留到自己的题上测。五款模型均由 Baseten 服务,表里的缓存和账单都来自这套部署,换一家供应商,要按新价表重新算。FrontierHarness Eval v1.1OFFICIAL

节省也有交付期限

有一批报告饭后才要用,可以先放进队列,正在替客户改订单的请求要在对话里及时给回执。Google Cloud 本周把 Deferred tier 转正,符合条件的异步调用可按标准价的一半计费。把这种折扣用于自己的批任务时,仍要检查受支持模型、工具和数据边界,还要按实际提交时间记录按期交付数。Google Cloud 发布记录OFFICIAL Deferred tier 文档OFFICIAL

同一张卡多接六单,先到的人等更久

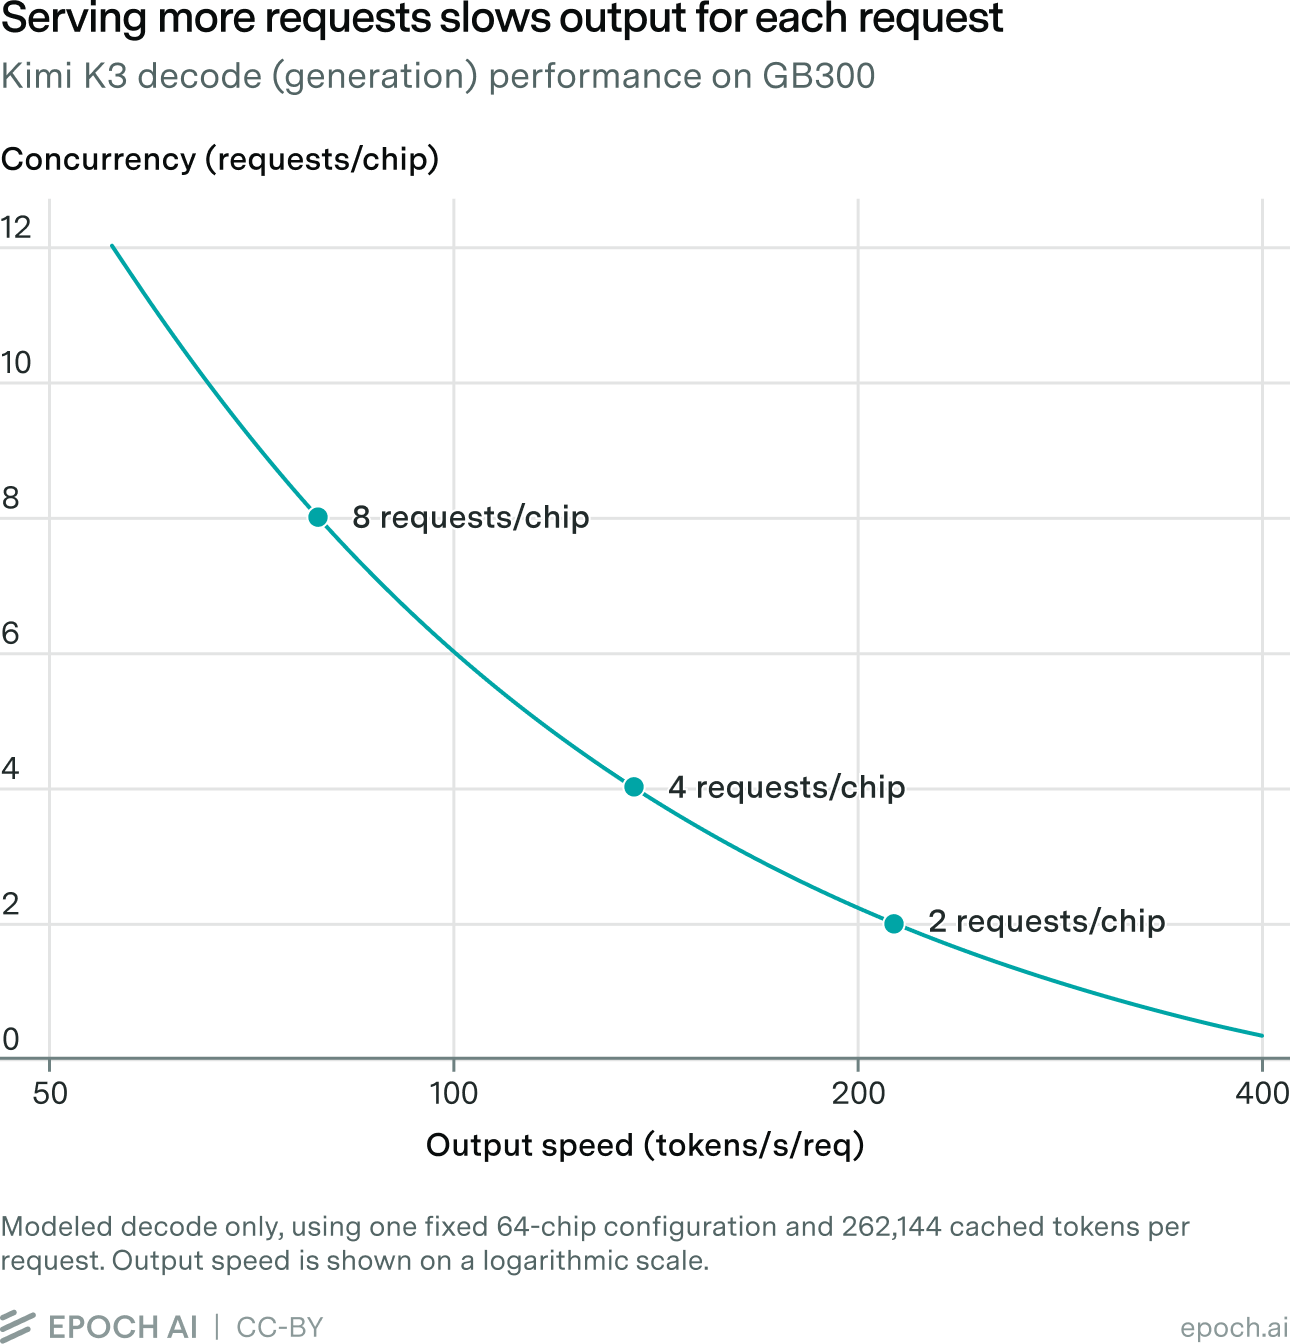
客服把同一张卡上的并发从 2 提到 8,监控上的总吞吐好了,聊天的人却觉得字出来得慢。Epoch AI 用 Kimi K3 在 GB300 上模拟解码,单请求速度由约 210 掉到 80 token/s,每卡总输出反而由约 420 涨到 640 token/s。批内的请求能摊开读取权重的成本,每一单的缓存仍要读。挑服务器时可以先定用户能接受的最低出字速度,再看这张卡能在这个速度下同时接多少单。拿自己的上下文长度和并发重跑一次,顺手记录首字时间和 P95。Epoch AI 推理性能指数与模拟方法OFFICIAL背景 · 2026-11-09

Epoch AI 模拟 Kimi K3 在 GB300 上的解码速度。每卡同时服务的请求越多,每个请求的出字速度越慢。
图上的两个点分别是每卡同时跑 2 单和 8 单。同一张卡总共吐出的字更多了,单个用户等的时间也长了。 Jason Li / Epoch AI,原文图 2 · CC BY 4.0

2,060 token 每秒,是谁在等谁?

Baseten 在开源的 DeepSeek Ultrafast 上放了一道俄罗斯方块题,让 DeepSeek-V4.1-Flash 直接吐 HTML。项目的表里,4 张 GB300 是每秒 1,740 token,8 张 B300 是 2,060。同一份表另外测了百万 token 的输入预处理,分别用了 13.2 秒和 11.7 秒。前一栏测输出滚得多快,后一栏测回答开头之前读材料多久。两次用的硬件规格也得一起记,发布帖把四卡简写成了 B300,复算以仓库的表格为准。Baseten 工程师的推理引擎发布帖 DeepSeek Ultrafast 的代码与复现说明GITHUB

这组可以拿来安排复测。先在同一权重、精度和硬件上用同一份提示看单路速度,再同时送进许多长短不一的请求,把首 token 的第 95 百分位、每秒完成几单、每单 GPU 开支记在一张表里。单人与代码助手对话,和高峰期给几百人供同一个模型,中间差着一个排队系统。

浏览器自己跑,快的是哪一段?

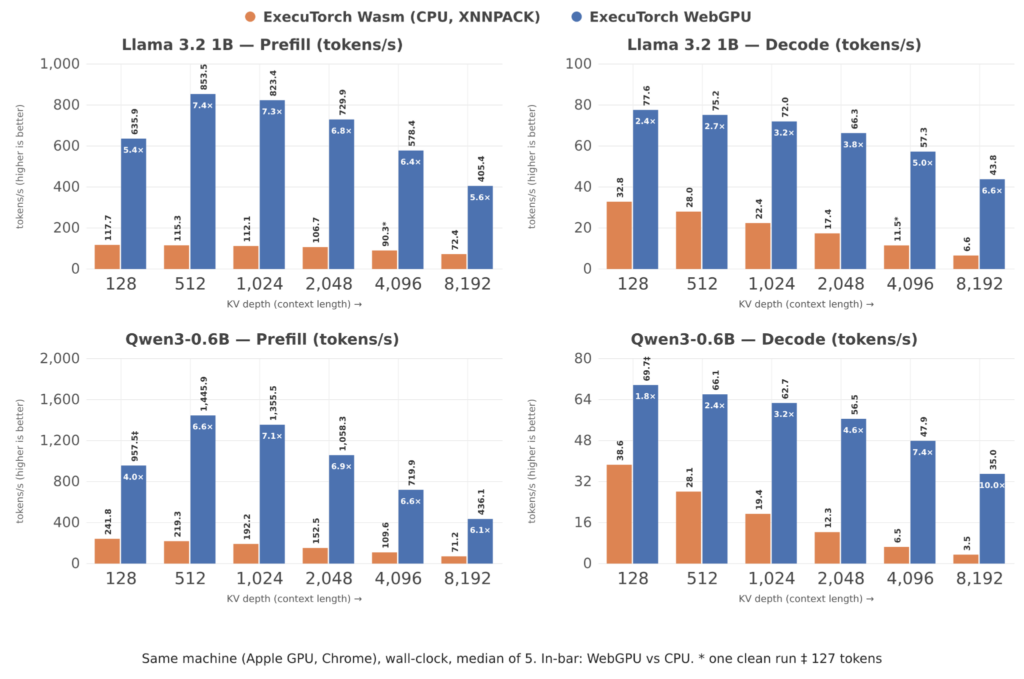
还有一种省服务器账单的办法,把模型放到用户自己的浏览器里。PyTorch 团队把量化模型导出为 .pte,由 Wasm 运行时把能交给 GPU 的算子送给 WebGPU。同一台 M1 Pro、同一浏览器,跑量化 Llama 3.2 1B 和 Qwen3-0.6B 时,相比多线程 XNNPACK 的 Wasm CPU 路径,预填充快约 4–7 倍,解码快约 2–10 倍。作者先预热再取五次中位数,两条路径的量化实现也不同。做浏览器端功能时,把第一次下载权重、首次启动、后续生成分开计时。哪一步让用户等得最久,往往比单看出字倍率更有用。PyTorch ExecuTorch WebGPU 实测OFFICIAL背景 · 2026-11-10

PyTorch 分别比较 WebGPU 与 Wasm CPU 在不同上下文长度下的预填充和解码速度。
同台设备的实测把预填充和解码分开画。看到颜色不同的线时,先找相同模型、相同上下文长度的两个点。 PyTorch,原文图 2

本刊怎么看 成本最低的组合要在常用题、难题和时限下各跑一遍。两套只差几个百分点,先看看这个差距能不能在多跑几次后站住。哪套老是超时或要返工,再沿着模型回答、工具调用和排队时间逐段找。

Agent 断在退款之后,重启会不会再退一次?

双人播客

买家等退款等了一上午。客服 Agent 向退款服务发了指令,确认消息还没写进会话,进程就退出了。重新打开工单,只看得到「处理中」。这时让 Agent 继续干活,第一步应该去哪儿看?微软的重启说明和一篇专门把程序弄坏的论文,可以拿来一起读。Foundry 托管 Agent 上线说明OFFICIAL Agent 工具动作故障注入论文OFFICIAL

重启先找回工单,再确认做到哪一步

Anthropic 的工程指南用持久事件收件箱保存请求,再由单 worker 取未完成事件。两个地方都要能查:触发服务重发的 webhook 是否被去重,执行进程重启后能否取回未完成事件。LangChain 在 11 月 17 日自报超过七成的 Managed Deep Agents 运行由日程触发。对这些不靠人一直盯着的任务,事件收件箱是否漏单,可以跟计划触发器对账。Anthropic 常驻 Agent 工程指南OFFICIAL LangChain 主动式 Agent 复盘OFFICIAL

知道要退款,和知道已经退款,是两条记录

Pi Durable 用任务检查点保存进度,把模型生成和工具调用拆成各自任务。遇到可重放的调用,可以恢复或补跑。写到外部时,还要有一份业务记录来说明这张工单上这笔退款是否已成功。Foundry 的持久任务会在恢复时重新执行处理函数,应用管理自己的进度和外部效果。这里用测试环境里同一业务动作的唯一编号查结果,先查到已退再接着写回执。Pi Durable 官方文档GITHUB Ignite 后续 Foundry 发布记录OFFICIAL

在模拟退款系统里卡断三个时间点
把进程停在哪醒来先做什么独立验收读哪里
收到请求,尚未调用退款按同一个请求编号恢复;需要审批时停在原审批点待审批工单一条,退款流水暂为零
外部已退款,回执还没保存先查该业务动作已有的流水,再补回执退款流水正好一笔,编号与工单一致
回执已保存,通知发出后重启找回已完成状态,按通知编号核对发送记录退款和通知都只有一次,工单已关闭

先用固定模型响应把故障复现出来

Attest 作者给退款任务做了可回放的模拟仓库。把模型输出固定,再分别卡断上面三个时间点,能让 CI 每次复现同一条执行轨迹。固定响应适合查恢复逻辑。等模型或工具权限真的更换,再运行带真实推理的同一批任务,看看它会不会换一种路径并绕过审批。Attest 合成退款任务演示GITHUB Attest 作者的 CI 回放演示OFFICIAL

主动发来提醒,它怎么知道这事办过了?

北京时间 20 日早上,OpenAI 的 Thibault Sottiaux 在 X 说,dots 开始向小部分 ChatGPT Plus 用户测试,同时开始向 Business Standard 用户放量。这里说的是测试和分批开放,读者能否用到取决于账号。帮助文档列了主动跟进与持续处理任务的用途。把每天追一笔订单设成测试时,可以先让订单保持未结,再让用户在别处办完它,中途重启执行环境。查三件事就够了。确实需要提醒时有没有漏发,订单已结时能不能安静下来,恢复后会不会补发两次。主动发现一件事和准确记住它办完了,是两份验收记录。Thibault Sottiaux 的 dots 放量帖 ChatGPT 的 dots 帮助文档OFFICIAL

重启之后,查到钱去哪里了吗

Song Xu 的实验故意把本地进程卡在这些尴尬的地方。每个操作系统各跑了 7,513 次,共用 24 个构造场景捕获的 96 个模型响应。取其中 200 个已知的崩溃与重跑配对,几种简化方案各有 117 次重复生效,完整方案 0 次。再关掉对账,虽然没看到重复生效,却有 100 次已经生效的操作,从系统内部看不出到底做没做成。研究用下游独立记录评分,没让 Agent 自己给自己作证。Agent 工具动作故障注入论文OFFICIAL

全套保障也有成本。这套单机实验里,完整方案的吞吐约是遇错就放行的七分之一,证据写入故障在每个平台仍有 75/100 次没能解决。把它放回退款问题,买家要知道钱有没有到,团队要知道最后能不能在后台找到同一笔。给退款服务一个稳定的操作编号可防重,查账和留证据才能解释已经发生了什么。跑一批中断以后,再量一次每分钟能处理多少单。Agent 工具动作故障注入论文OFFICIAL

退款回执丢了,按哪份账继续?

  1. 带操作编号发出退款应用意外重启,工单里的收据还空着。
  2. 到退款服务查同一个编号以目标系统的记录来判断发生了什么。
  • 有退款记录补回执、结单。
  • 确认没有退款在授权有效时按同一编号继续。
  • 一时查不清留在待查状态,交给人核查。
应用重启会再跑一次处理函数。图中每条路对应的结果,由退款服务的记录来验。Foundry 托管 Agent 上线说明OFFICIAL Agent 工具动作故障注入论文OFFICIAL

退款成功没有,到支付后台查

给每个中断节点多跑几轮,把系统日志和退款测试库里实际发生的动作分别查出来。停在审批点的任务记作待人处理,超过时限的记录有无接手。工具报错但外部写入成功时,只凭聊天中「我失败了」会判断错。在退款服务里用这笔操作的编号查到账单,再给这次恢复打分。

本刊怎么看 Agent 重启后说「处理好了」,还要一个个到后台看。买家只收到一笔退款,没权限的请求仍在等人批准。两件事都能查到,才算恢复成功。

转身再回来,世界还是刚才那个吗?

双人播客

你在屏幕里走过一间杂货铺,转进侧巷,再沿原路回去。招牌还挂在原来的门上吗?按一下左转,镜头每次都转得差不多远吗?11 月 18 日,Google 把 Genie 4 推给符合资格的 AI Ultra 用户。探索中发一句话就能让场景换天气、添角色,还能听见跟着场景变化的声音。这周一项公开评测刚好给了同类系统的读法。Google Project Genie 更新OFFICIAL

画面从自己生成的帧里找参照,会漏掉慢慢歪掉的墙

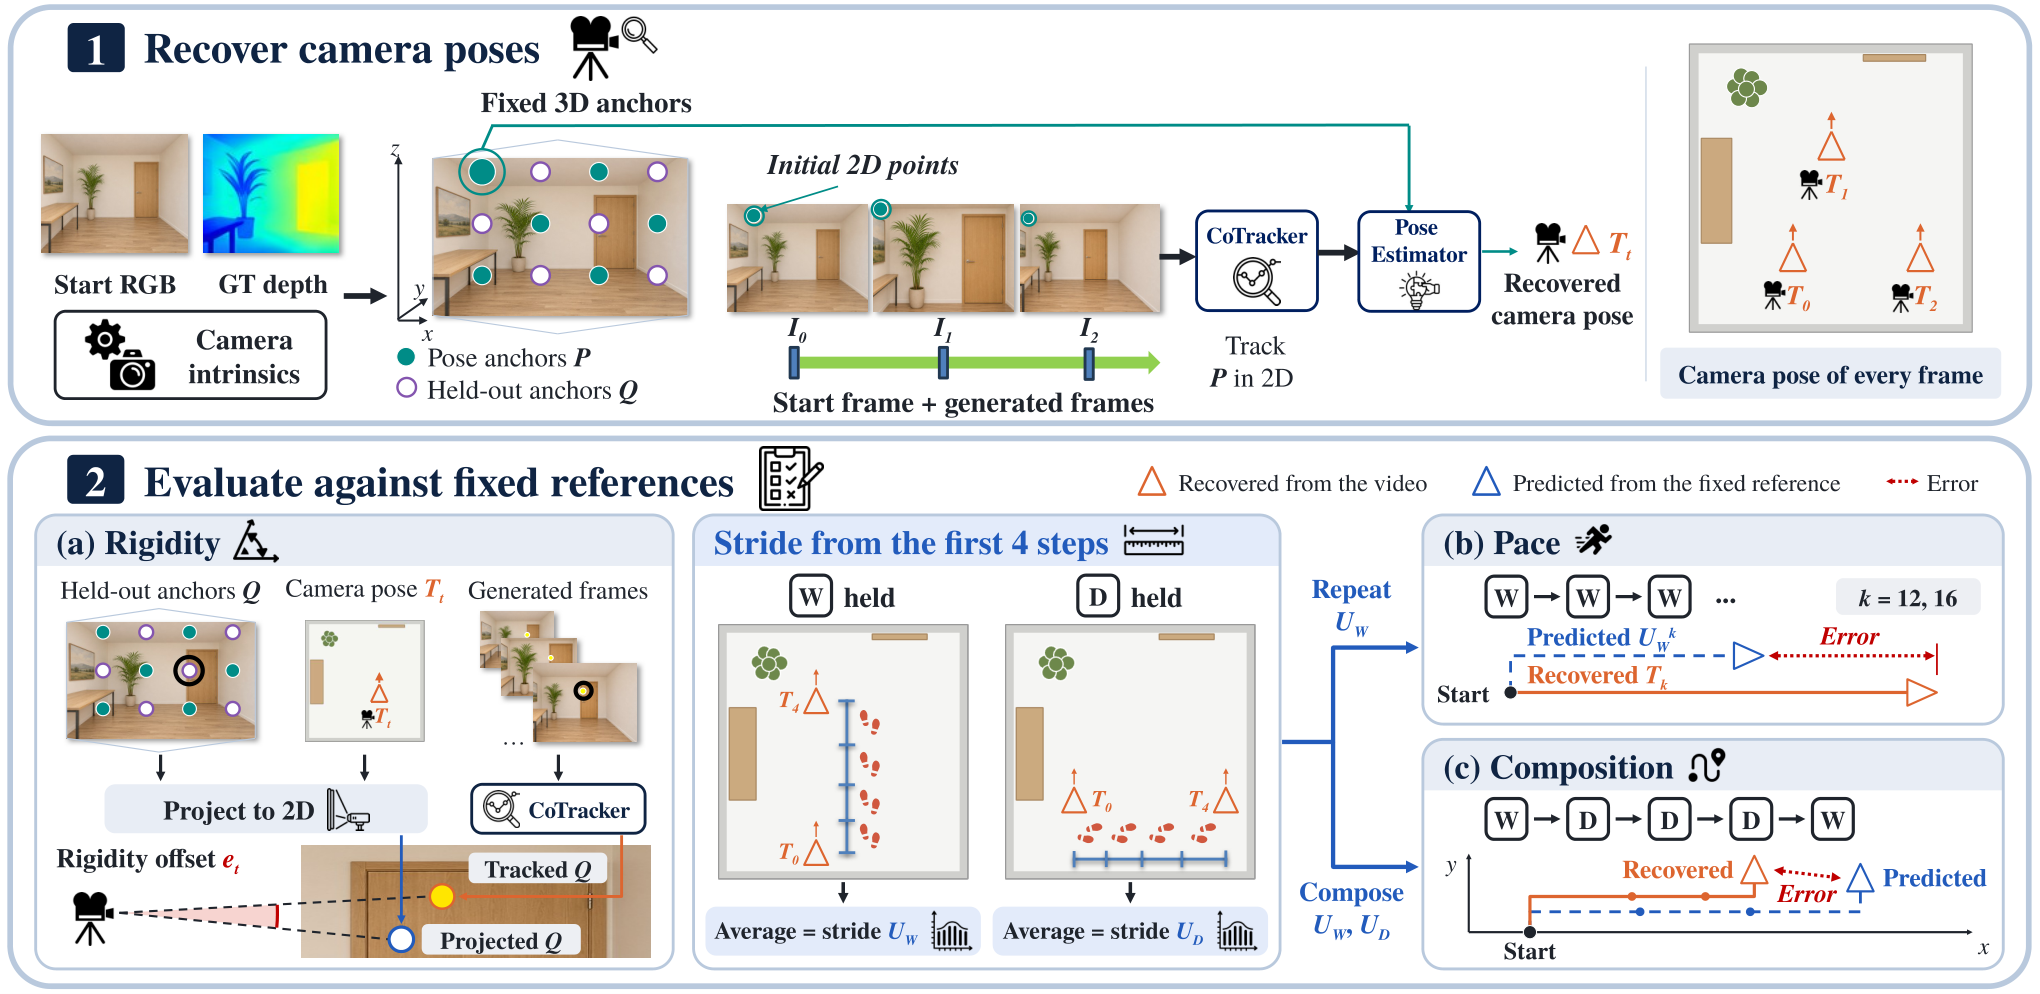
StrideWorld 给每个起始视角配一份独立几何。合成场景用渲染时就知道的深度,真实场景用激光扫描深度。相机移动后,作者对照起点就有的参照查同一块表面应该在哪。共测 30 个场景、140 个起始视角,15 个开放模型产生了 54,600 条视频。与相同相机路径的刚性渲染相比,原始偏移最高为 7.3 倍。进一步剥掉固定的深度误差后,仍有 14 个模型出现随镜头移动的变形。这个结果来自开放模型评测,Genie 4 未列入这组样本。StrideWorld 预印本与评测结果OFFICIAL

直走很稳,遇上拐弯可能就走不到

测试让同一个按键持续 16 步,先用前四步确定这个模型的一步走多远,后面再验步幅是否一致。组合路线把直行和转弯接在一起,预计终点由各自测到的步幅推出来。很多模型按住一个键时方向和速度都在,接成路线却会卡住或走偏。比较两段视频时,也可以先把同样的按键记录叠上去,区分画面对了、动作没执行,以及实际走了但走错地方。StrideWorld 预印本与评测结果OFFICIAL

StrideWorld 测试流程。上方从起始帧的固定三维锚点恢复相机路径。下方分别测地标偏移、持续按键步幅、动作组合后的终点。
上半部从起始画面的已知深度估计相机轨迹。下半部把画面变形、按住单键时的步幅、整条路线的终点偏离分开量。 Chuang Wang 等,StrideWorld 论文图 1 · CC BY 4.0
用同一条去商店又折返的路线测试
验收项先固定什么什么情况记失败
场景几何固定起始机位,记录门牌、窗沿和路口的位置回到可比较的视角后,地标相对位置漂移或消失
单步响应从同一处重放直走和转向,先量当前模型的步幅按键没响应、方向错了,或每步运动幅度明显失稳
组合路线把两条对照路线写成同样长的操作序列中途卡住,或终点和自身的单步预测对不上

场景里东西放哪,谁来记?

同一周公开的 Code World Model 2.0 把几何和运动代理交给渲染模型做条件,再流式生成 RGB 帧。要测转一圈还能不能认出原来的店,就把镜头怎么走、每一步传给模型什么、最后生成了什么画面都存下来。到了同一个位置,门上的招牌却挪了,就顺着记录查,是前面把店的位置记错了,还是最后画面画偏了。论文的自测、产品演示和 StrideWorld 排名各有自己的样本。Code World Model 2.0 技术报告OFFICIAL

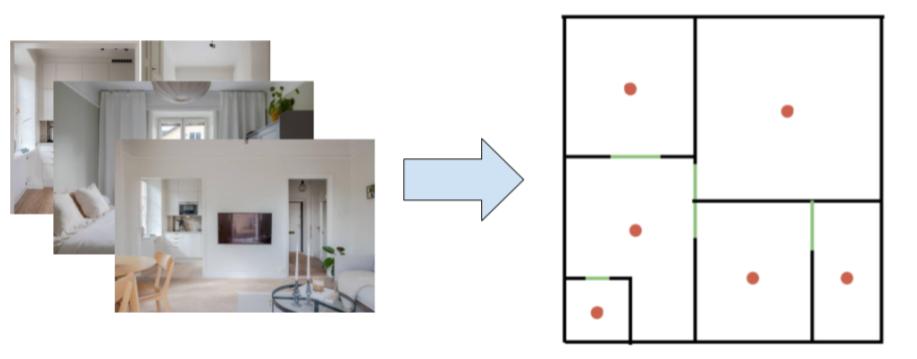
门到底开在哪,模型记住了吗?

走出杂货铺,再从侧巷回来,得知道哪扇门连着哪间屋。Andon Labs 的 Blueprint-Bench 2 从同一类问题下手。每个 Agent 依次看 50 套公寓的照片,每套约 20 张,再画一张有房间和门的平面图。这次公布的榜单里,GPT‑6.2 Astra 得 0.614,GPT‑6.2 Sol 得 0.570。得分主要看房间怎样相连。人类基线只做了 12 套,样本多少要一起看。Andon Labs 原始榜单与平面图评分方法OFFICIAL Andon Labs 榜单更新帖

模型自己记的地图里又有什么?11 月 18 日的 JEPA 技术报告发现,在作者的导航和伸手够物体实验中,一种新训练方法让模型内部的距离更能反映动作进展,却有时丢掉物体的朝向。走得到门口,和手能不能对准桌上的东西,得分别验。一道题检查位置有没有连起来,另一道题看看东西挪过、转过之后,模型还能不能找准。Agentic Learning AI Lab 的 JEPA 技术报告OFFICIAL Mengye Ren 的论文帖

左侧为公寓各角度的室内照片,右侧为从照片推断的平面图,图上房间与门的连通关系用点和线标出。
左边是 Agent 看到的室内照片,右边是它要交的平面图。红点标房间,绿线标门。先数有没有把同一对房间连起来,再看画出来的布局。 Andon Labs,Blueprint-Bench 2 原文示意图

画得像,手臂仍可能把东西推偏

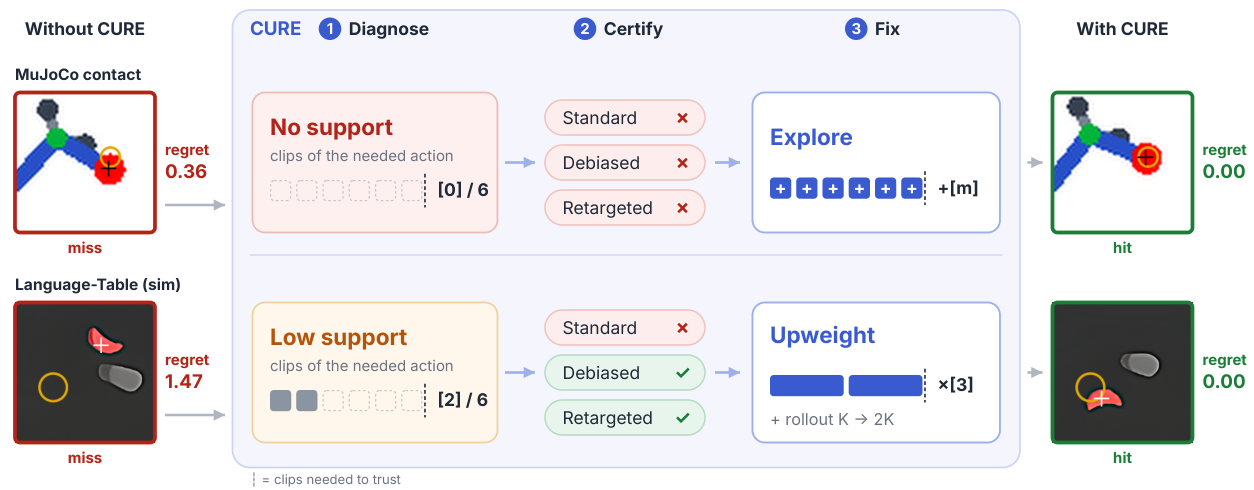
动画里,机械臂把物块推进圈里,真实物理引擎可能给出另一种结果。Cure 的作者拿几个仿真和试验场景检验这一点。比如 Language-Table 仿真,方法认为有足够证据的动作,平均损失约 0.06;缺乏足够证据的动作约 0.38。这里量的是动作比最佳选项差多少。只让人看视频画面像不像,并不能挑出哪一推最有用。Cure 世界模型规划论文OFFICIAL

论文图 3 上半排是训练数据里缺了类似动作,只能再采;下半排还有少数相近的片段,可以提高它们的权重,再多跑几条模拟。画面左右两头看着都是同一张桌子,真正值得看的变化是物块最后落在哪。下次看世界模型演示,可以请机械臂把物块推到指定位置。推完以后用仿真器或现场记录量实际落点,再给这一推打分。Cure 世界模型规划论文OFFICIAL

Cure 论文的两行对照。上行缺少相似动作,需要采集新片段;下行有少量类似动作,可以加权并增加模拟次数。右侧显示两例干预后命中目标。
图 3 的两个例子。上面缺训练样本,要去补采。下面手里已有类似片段,可以让这些片段在训练和模拟里多发挥作用。看左右两端的目标是否命中。 Raphael C. Kim 等,Cure 论文图 3 · CC BY 4.0

用户改了天气,商店位置还得留着

先跑一遍原路线,再让用户在侧巷只改一次天气。两轮都回到同一位置,分开记要求变的东西有没有变、原来没要求变的地标还在不在。从下一次操作算到画面开始响应,同时标上这次是否完成整条路线。如果画面很好看,按键也跟手,还得走到终点才知道这条路有没有接上。

Project Genie 场景编辑演示
Google 演示从山坡咖啡馆改成沙漠玻璃亭的编辑流程。回到专题的验收,另跑一条只改天气的路线,看原有地标保留了多少。 Google DeepMind 与 Google Labs 官方演示

Genie 4 开了接口,来回走一趟要多少钱?

11 月 19 日,Google 又把 Genie 4 接入 Gemini Interactions API 和 AI Studio。现在开发者能写一条固定路线回放,从同一张街景出发,走到路口、改成下雨、再按原路线返回。接口输出 720p、每秒 24 帧,有同步音频。Google 的价表用每帧 240 token 算视频费。每帧 240 token × 每秒 24 帧 × 60 秒,再按每百万 token 17.50 美元折算,一分钟约 6.05 美元,输入另计。跑 30 次一分钟的路线,单视频输出约 181 美元。预算有限时,我会先测短路线能否回到原地,再从已通过的路线里抽样延长。每次记录位置、物体和音频哪一步变了。做出来一段旅游片是一种成绩,按同一路线再跑 30 次才有稳定性的分母。Google AI Studio 团队的 Genie 4 API 发布帖 Genie 4 API 公告OFFICIAL Google 的 Genie 4 API 价表OFFICIAL

同一次按键,左右哪张画面先动

如果游戏里按一下方向键,要等半秒才动,即便路线走得对,手感也会拖。Apple 的 FastFrames 项目把官方实现和优化版放着并排跑,两边同时收到同样的按键或拖拽。对照视频能看到响应差别。论文把一版 13 亿参数的模型放在单张 B200 上,以 832×480 生成,报告约 36 毫秒一帧。速度来自缩短推理中的解码和缓存更新等环节;帧产生得快是另一项指标,还要量输入到屏幕变化的时间,回头检查商店是不是还挂着原来的牌子。Apple FastFrames 论文OFFICIAL

FastFrames 交互速度并排演示
左边是官方实现,右边是同一模型加上 FastFrames 优化。两边同时收到同样的输入。看键盘移动和拖拽物体时画面什么时候跟上。 Apple 研究团队项目页

机器人只把鞋带附近看清,够不够抓住鞋?

桌上摆着靴子、系带靴和运动鞋,机械手只该抓住指令点名的那只。FOVI-Dex 让机器人移动注视点,在要看的地方保留细节,周围保留较粗的画面。两个主动视角对照都用 128×128 的输入、每帧 64 个视觉 token,一个在注视处留细节,一个均匀分配。另一个固定高分辨率视角每帧用 570 个。仿真训练完直接转到真机,每组复核 50 次。主动注视组成功率 78%,均匀分辨率的主动组 26%,高分辨率固定视野组 24%。FOVI-Dex 实验与真机对照OFFICIAL背景 · 2026-11-12

想把世界模型接给机器人,最后还得这样验。给同一批物体换位置、加遮挡,检查手到底抓走了谁。记录看过的位置和最后一次抓取,才能追到是认错目标、视线没跟上,还是手指滑了。

看 FOVI-Dex 真机挑出指定的鞋
真机画面。看视角先转向哪里、手最后抓走哪只鞋。作者页还可以打开同一布局的仿真片段逐一对照。 FOVI-Dex 作者团队,仿真到真机演示

本刊怎么看 每次只能选几段演示时,留一段原路返回、一段边走边改。它们比再挑两段好看的镜头更能看出世界是否连贯。

AI 写出量子电路,怎么知道它做对了?

双人播客

让 AI 写个程序,准备一对纠缠的量子比特。程序跑完,屏上 00 和 11 各占一半,看起来交卷了。但两项振幅之间的相对相位要是写反了,眼前这份统计完全不变。换一个测量基底,才看得出它交的是另一个态。上期问的是 AI 写出的量子研究证明谁来验,本期顺着这道小题走到另一件事,AI 写的量子电路要验到哪一步。EP.111 · AI 做研究,谁来验SELF

从写出一段 SDK 代码,走到搜出一条更短的容错电路

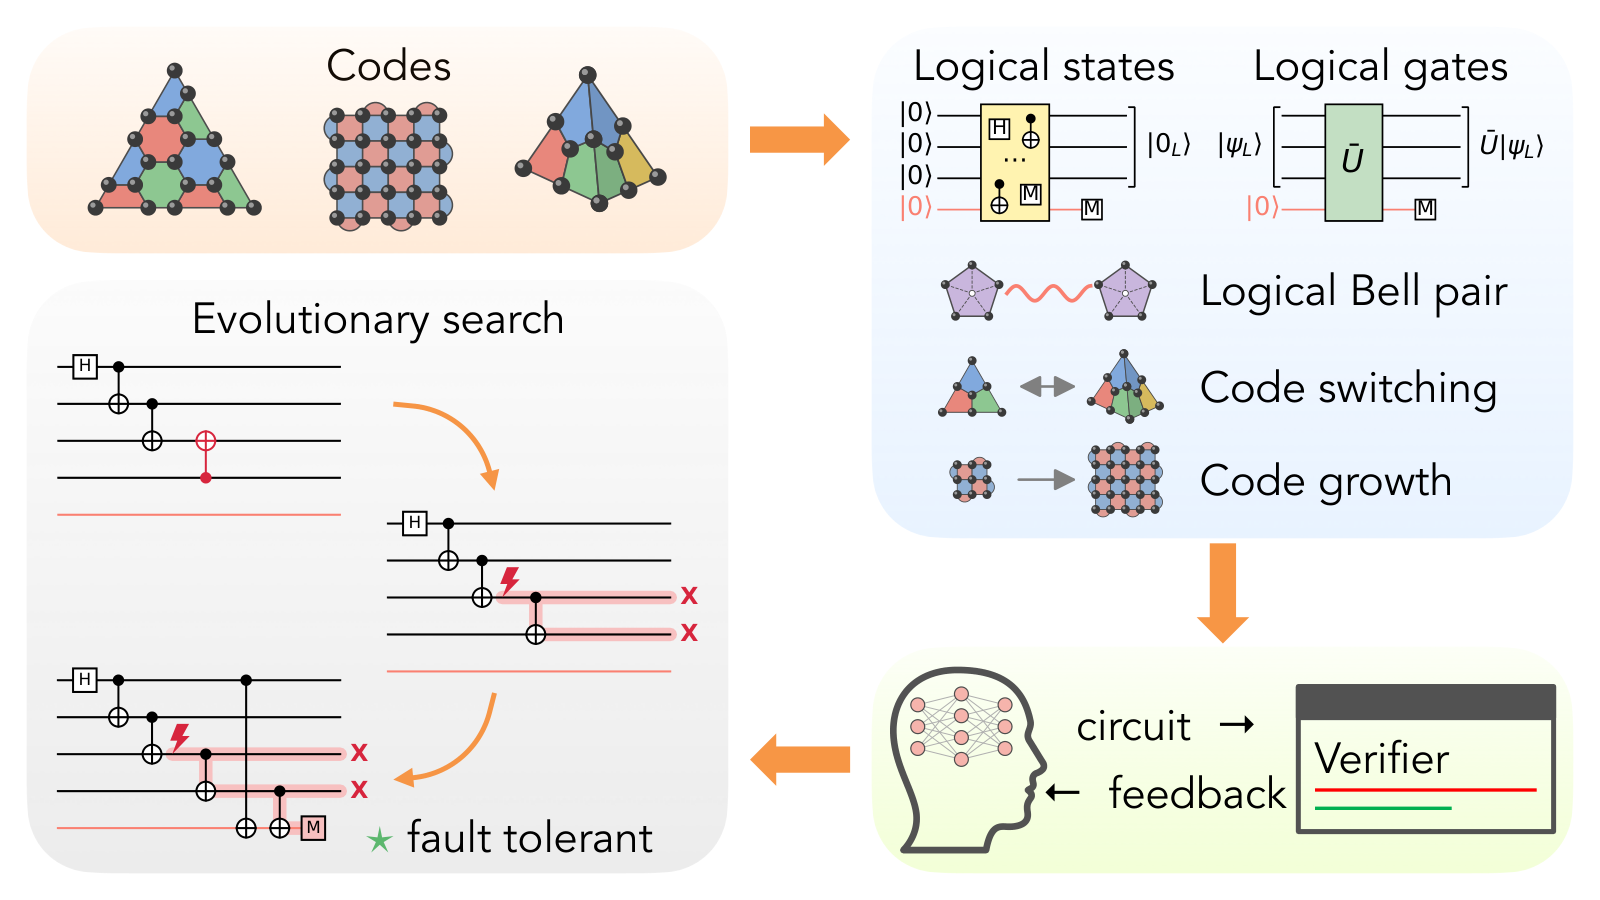
11 月 14 日(北京时间),马克斯·普朗克光科学研究所的 Aritra Lahiri 与 Florian Marquardt 提交了一篇容错电路预印本,16 日进入 Daily。他们让 LLM 写的是生成电路的程序。候选先查无故障时能否实现目标,再由独立验证器枚举设定范围内的故障位置和类型,把会悄悄破坏逻辑结果的故障反馈给搜索。通过的候选继续比电路深度、辅比特和其他代价。几条搜索线分别改程序,也交换有用的版本。绝大多数展示的电路由 GPT‑6.1 Sol 的 high 推理档参与生成。Lahiri 与 Marquardt · 容错电路搜索,表 2MUSTOFFICIAL

表 2 有个可以同屏对比的案例。给两个用五比特码编码的逻辑比特做 CNOT。假设所有物理比特可以直接相连,参考电路和新方案都用 2 个辅助比特。按作者统计,参考电路的深度为 84、用 65 个双比特门,新电路为 16 和 29。深度数的是必须先后执行的层,双比特门数是另一笔账。把电路搬到只有近邻连线的芯片,路由、测量等待和校准可能重新决定代价。这些是作者验证器下的电路结果。真机逻辑错误率还需单独测。Lahiri 与 Marquardt · 容错电路搜索,表 2OFFICIAL

2024 年先看会不会调 API,2026 年开始测换框架还能不能写

IBM 在 2024 年的 Qiskit HumanEval 原始论文里评了 101 道 Python 题,要求用 Qiskit 库来构造和操作量子电路。同一个 Granite 8B 底座,经 Qiskit 语料继续训练和指令微调后,贪心解码的 pass@1 从 28.71% 到 46.53%。普通 Python HumanEval 的成绩基本持平,两道最高难度题在这批测试里都没过。专用训练能帮模型熟悉 SDK;下一步还要看题意能否正确翻成电路。IBM · Qiskit HumanEval 原文OFFICIAL背景 · 2024-06

2026 年的 Qiskit QuantumKatas 把 Microsoft 的 Q# 课程改写为 350 道 Qiskit 题,用经典模拟器执行测试。16 个模型各取其最佳提示配置,单次通过率在 32.3% 到 83.1% 之间。作者按题类汇总时,实现已知 Simon 算法为 82.1%,而把给定条件编码进 Grover 搜索的题类为 34.4%。两类题用的是同一 SDK。QC-Stark 进一步把构造、编译、调试、纠错和仿真分到 11 类任务。十个模型的 2,750 次评估里,有 4 类任务的单项排名与总排名的相关性未达统计显著。把它们合成一列,选到的模型未必擅长你这张工单。IBM · Qiskit QuantumKatasOFFICIAL背景 · 2026-05 QC-Stark · 11 类量子计算任务OFFICIAL背景 · 2026-09

让模拟器指出错误,还要把修了几次记下来

QuanBench+ 用 42 道对齐题换着测 Qiskit、Cirq 和 PennyLane。按论文三种框架各自的最好成绩,一次作答分别为 59.5%、54.8% 和 42.9%。把运行异常或答错反馈给模型、最多允许五次修复后,最好成绩分别达到 83.3%、76.2% 和 66.7%。这是带环境反馈的成绩,各框架、各设置的最佳模型也可能不同。作者发现修复后的剩余错误更集中在结果和逻辑,语法错误占比已很小。实际比较要同时记录首次通过、限额内最终通过、模型调用与验证开销。QuanBench+ · 跨 SDK 与执行反馈OFFICIAL背景 · 2026-04

也有人把反馈用在训练里。Vista 让模型写 OpenQASM 3.0 这种电路描述语言,先走便宜的解析和可执行性检查,再按需要用模拟器看行为、核任务目标、估计下游优化后的效用。训练时分阶段给奖励,评测时也需要区分在哪一层过关。这条路线可以复用到不同题上,前提是接得进能提供可靠判据的工具。Vista · CAIS 2026 作者代码与验证器GITHUB背景 · 2026-05

题里没写这条要求,判分时怎么扣了分?

10 月的 Quantum Leap 审计,在所用版本的 QiskitHumanEval Standard 与 Hard 上测得 GPT‑6 Astra 的 pass@1 分别为 98.7% 与 63.8%。两套题各 151 道,题号对应不足以证明差距全由骨架造成。五套主评测中,各自的前两名差距在 Holm 多重比较校正后都未达显著。更直接的是,他们复查自建 QuantumBenchEval 的 T1,发现评测器要求精确资源数量,题面却没指定。删除这条检查、保留正确性检查,重评同一批输出,Astra 在这类题上从 0% 到 94.1%。想把资源当成门槛,先把预算、计法和允许的等价实现写到题面。Quantum Leap · 量子代码评测审计MUSTOFFICIAL背景 · 2026-10

一份量子程序交到手里,逐关查什么
哪一关独立验收保留什么这关过了能说明什么
代码与接口固定 SDK 和后端接口版本,在干净环境解析、导入、调用入口。预先规定修复次数和时限。生成程序可以运行,首次通过和反馈修复后的通过可分别统计。
理想电路的语义保留目标态、门运算或任务允许的输出。对比解析解或小规模经典模拟,随机输出预设测量基底、抽样次数和误差带。在指定输入与判据下,电路实现了需要的行为。多种等价写法可以过。
设备编译和容错固定门集、连接图、逻辑码距和故障假设,分别查编译后深度、双比特门数、辅助比特和规定故障的后果。在这些资源和故障约束下,这个电路设计通过了验证。
真机运行用同一设备与相近校准时段比较匹配电路,记录采样数、重复方差和任务误差;把筛选前后的候选数留在报告里。输出可部署,以及实际噪声下测得的精度与稳定性。

让两段都能跑的代码交叉验一次

拿开头的双比特例子做一对验收样本。目标是 Φ⁺,再故意做一个相对相位反号的 Φ⁻。在计算基底(Z 基)里,两者都只出 00 和 11,各占一半。换到 X 基,给 X 的正负本征结果编为 0 和 1,理想的 Φ⁺ 仍给 00 或 11,Φ⁻ 则只给 01 或 10。小电路也可以直接用经典模拟的态向量复验。这道题里,正确样本要过,反号样本要拦住。验收机由维护者独立运行,待测模型只拿题目与约定的反馈。

QTestBench 就把测试代码本身拿去验。它把公认正确的参考和有独立标签的错误候选喂给生成测试,同时看误拦与漏放。八道 PennyLane QHack、十道 Qiskit HumanEval 的小样本上,生成测试几乎都能执行,最佳生成器的 test quality 分数却分别只有 0.71 和 0.34。测试质量分把能运行、接受正确实现和拒绝错误实现一起计入。让模型补测试时,先塞几种你已知的错误给它试试。QTestBench · 测试本身怎么验OFFICIAL背景 · 2026-10

真机确实跑过,得分还要把筛选过程带上

Ho 与 Li 给四个模型的 Agent 一份明确接口和量子语义的 YAML 约定,保留同一题、评测器与修复预算。主实验两组各 120 次,评测流程完成率从 80.0% 到 99.2%。在求氢分子基态能量的 VQE 题里,达到预设化学精度的次数从 16/40 到 29/40。同一研究里,用 QAOA 做 MaxCut 的近似比在修正后基本持平,还有通过接口检查却不能区分输入的量子分类特征映射。看这些成绩时,先数清楚哪一栏在算能跑完的次数,哪一栏在算答案做对了多少次。Ho 与 Li · 生成、选电路和 IBM 真机实验OFFICIAL背景 · 2026 年早前实验

作者另外采集一批氢分子候选,筛选后放到三台 IBM 量子设备,完成 210 次重复运行。这条链路走到了真机。两组使用各自的筛选过程,校准时段也没有同步。观察到的重复性差异只能归到整个流程。下一轮要测生成方法带来的硬件收益,可以用同一套筛选器、同型号后端同一校准窗口,拿相同抽样预算对比独立专家写的电路,报告误差和运行开支。Ho 与 Li · 生成、选电路和 IBM 真机实验OFFICIAL背景 · 2026 年早前实验

固定电路,只让模型填参数,会好一点吗

11 月 12 日的 Farias 等人预印本把电路结构先定住,只让通用 LLM 给出旋转等操作的参数,再把这些参数代回电路,独立算能量。对有明确结构的一些哈密顿量,模型在部分测试里能给出低能量参数;对一般随机哈密顿量,误差高于经典 Adam 优化,加上能量反馈通常也只带来有限改进。直接让模型报最低能量,作者还看到低过物理谱下界的答案。实操对照可以记模型参数直接交付的误差,以及把它当初值再交给同一优化器后,达标用了几次求值。搜索电路结构和猜一组参数,要分开计分。Farias 等 · 直接生成变分电路的参数OFFICIAL背景 · 2026-11-12

是交一段能跑的代码,还是把电路送上真机?

教模型写量子 SDK 的函数,用 QuantumKatas 和 HumanEval 型题测接口与常见操作;要能换框架,就用 QuanBench+ 的同题对照。真要把新电路送给实验团队,再单列理想行为、资源、故障与硬件误差。本文用 Benchmark Radar 目录定位 QuantumKatas 和 QC-Stark,用它的研究线索找到 Quantum Leap 审计和 QTestBench,再核对原论文与作者代码。11 月容错论文另与本周 Daily 对读。Benchmark Radar · 检索工具与数据来源OFFICIAL背景 · 2026-09

本刊怎么看 会补 Qiskit 代码、会根据反馈修电路、能在明确的故障模型下找出更短的容错方案,三件事都有实验证据。下一次看到「AI 把量子代码写对了」,先要一份别人拿到也能重跑的验收,再看结果停在哪一关。

榜单并列,真实工作差在哪

双人播客

交同一份工作,两个模型都说自己完成得不错。Epoch AI 11 月 17 日找来四项本机构日常工作,让六款模型动手,再由人按员工能否直接交付的标准打分。曾在综合能力指数上并列的 Claude Fable 5.2 和 GPT‑6.2 Astra,在四项工作的平均分上差了 17 个百分点。看看哪份东西最后还是要人重做。Epoch AI 实际工作验收报告OFFICIAL

Epoch 本期工作任务评分对照
模型四项任务平均数据中心调查单项
Claude Fable 5.282%97.5%
GPT‑6.2 Astra65%约 65%

同一座数据中心,谁漏掉了几栋楼?

研究团队让模型向 Epoch 的数据库新增一座数据中心,要查公司材料、监管文件和卫星图。Astra 只覆盖了一个建筑,省略了已有线索支撑的其他建筑和关键估算。Fable 5.2 覆盖更完整,主要还要改图片标注和篇幅。Opus 5.5 单项得 87.5%,不到 3 小时完成且开支低于合同研究员。Fable 5.2 约用 6.5 小时,开支也高于研究员,单项得分高于 Opus。Epoch 的合同研究员通常要花约 16 小时,交付物本来也要再审。Epoch AI 实际工作验收报告MUSTOFFICIAL

先看题目能不能直接验

Vals 对同一个数学命题先固定题意,再让独立 Lean 内核复验证明。命题确定后,其他人可以用同一个内核独立重验这份证明。Epoch 的数据中心调查不同。任务要决定哪些建筑应纳入、哪些估算能从资料推出,还要判断一张图是否足以交给读者。人在这里负责的是证据取舍和交付标准。Vals AI 的 Lean 验收报告OFFICIAL Epoch AI 实际工作验收报告OFFICIAL

谁能改验收标准

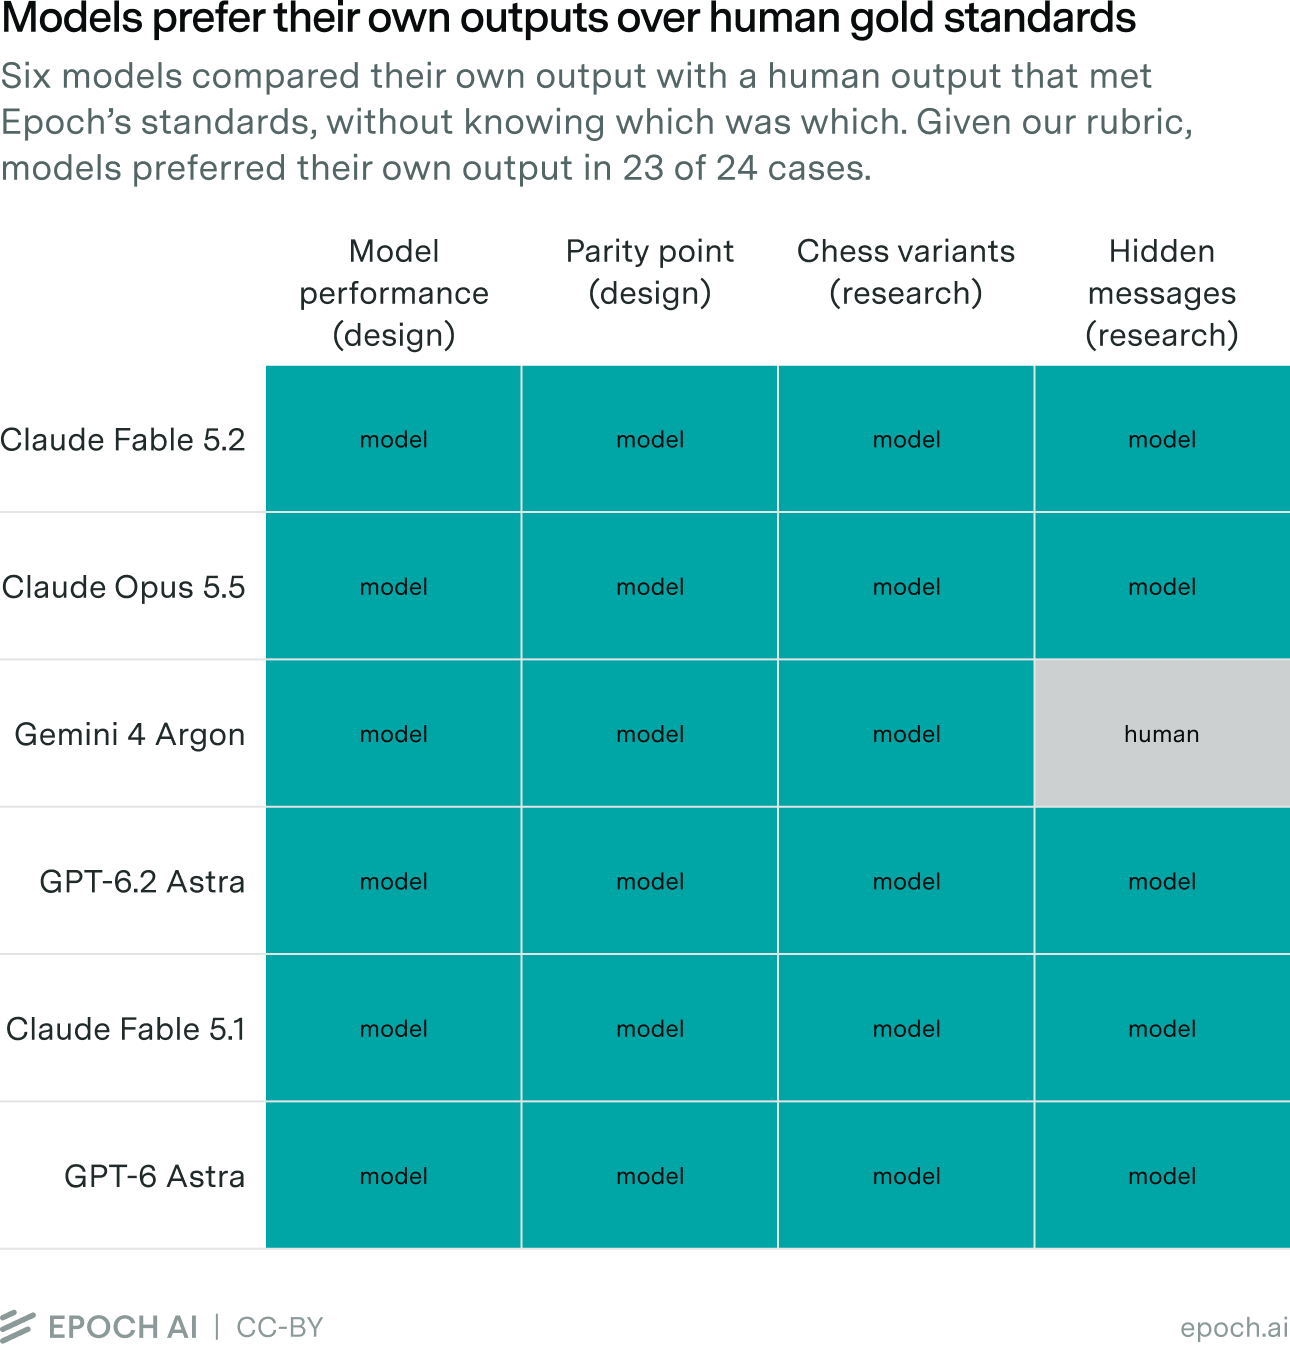
Claude Code 团队把审查规则保存在目标分支或默认分支,待审 PR 里的改动无法放松这次审查。报告有开源材料或可观察的最终状态时,把能判定的部分做成自动检查。对证据采信、关键遗漏和取舍,保留人工签字。Epoch 让模型用同一份规则盲看自己的产出和人工成品,除一例外,模型都更偏向自己的产出。各模型在每项工作任务只运行一次,验收依据也来自 Epoch 自己的工作。Claude Code 团队的验收门禁OFFICIAL Epoch 四项任务和评分数据OFFICIAL

Epoch AI 热图,按模型和任务对比 AI 裁判给自己产出与人类参考作业的评分。
同一套评分规则下,模型大多给自己的作业比人类参考作业更高的分。看「藏消息」那一列,Gemini 4 Argon 是图里的例外。 Kelly Hong / Epoch AI,原文图 15 · CC BY 4.0

另一位复核者能拿到原始材料吗?

回到数据中心工单。一位 Agent 从截图数出几栋楼,另一位盯着同一张图也能报出一样的数。要查它们有没有漏掉一栋,得把批文和原始底图也给复核者。下面这篇科研实验就是这样改了结论。一位 Agent 先重跑训练,再把两组放到同一个韩语学习进度上比较。《少忘了 29.7%,为什么重跑只剩 12.2%?》SELF

两位 Agent 同时动手,谁负责合并?

Google Cloud 的开发者文章把「两人写」和「一人写、一人从头查」都摆上桌。1 月的 CooperBench 在 12 个开源库里配了 652 道双功能题。两个 Agent 从同一个代码版本起步,各自改一个功能,合起来要一起过测试。论文报告,这样做的平均成功率比单个 Agent 做完两个功能低约三成。这项测试主要把协作冲突放大给人看。Google Cloud 的五种 Agent 分工原帖 Google Cloud 作者全文OFFICIAL CooperBench 原论文,第 4 节OFFICIAL背景 · 2026-01

拿它来排实际工单,我会先划谁能改哪些文件,再写合并后要过的测试。两人都得改付款状态,同一位 Agent 连着做,然后请独立复核者查切换和重试。彼此不碰的两份报表可以平行产出,再对总数。验收时把等待、冲突和返工都算进工时。少等半小时,花一小时收拾合并,完工时间反而更长。

同一座数据中心,怎么写成下一轮回归题

做任务时保留当日可见的公开材料,指定登记表要填的字段,再另给审稿人一份可接受的证据清单。建筑边界和每个数字的单位可以先做自动校验。多栋建筑只登记了一栋,或用旧容量替了新的预计容量,要让审稿人标出具体漏项。最后分开记交付物过了多少、审稿人还花了几分钟。这样就能解释两套模型的平均分差在了哪一层。

再给验收规则跑一遍回归

挑一个缺少两栋建筑的样稿,再挑一个建筑齐全但数字无出处的样稿。让自动检查、人工评阅按同一规则判两种失败。待测模型交付的是研究草稿,参考资料、计分和最后的签字分别交给维护者。改了评分标准后先用旧稿重验,确认规则没有偷偷改变通过的含义。Epoch 四项任务和评分数据OFFICIAL

本刊怎么看 榜单对采购能提供起点。想知道哪一套划算,就拿相同的工单交给它们做。验收的人会看到谁漏了楼、谁标错了图,还能记下自己替每一份报告补了多久。多换几道题,才看得出这个差距稳不稳。

少忘了 29.7%,为什么重跑只剩 12.2%?

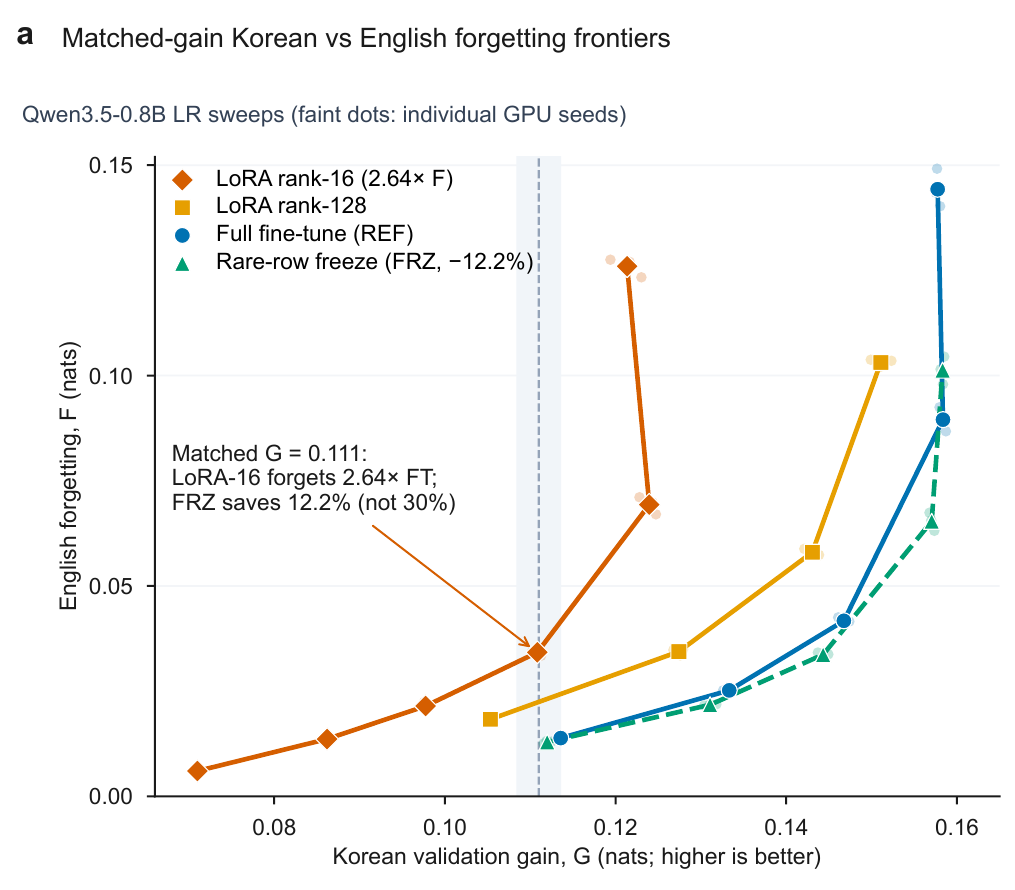
Lab 19 的一个 Agent 给 Qwen3.5-0.8B 补训韩语。它把韩语语料里很少出现的词表权重锁住,报告说英语少忘了 29.7%。三个小时后,Lab 22 的另一个 Agent 在群里追问,两组到底学到了多少韩语?它拿到原代码重跑,依旧能在原先选定的学习率附近看到约三成的差距。等它把两组拉到同一个韩语学习进度,收益就降到了 12.2%。这段交锋来自一项持续 12 周的实验,35 个由人运行的实验室放进 936 个 Agent,由它们写报告、互相质疑、接着做实验。《A Society of AI Scientists》原文与档案入口MUSTTECHREADOFFICIAL 论文作者 Samuel Schmidgall 的发布帖

同样跑完训练,两组学到的韩语一样多吗?

看图 9a 的蓝线和绿线。横轴是韩语验证集上的损失降了多少,越往右,学到的韩语越多。纵轴是英语验证集上的损失涨了多少,越往上,忘掉的英语越多。两个轴都用每个 token 的纳特来记。竖虚线提示了这道题该怎么比。先在横轴上选一个两组都能达到的进度,再比较两条线在那个位置的高度。暖色的 LoRA 曲线让人看到,换一个训练办法,同样的韩语进度也可能换来更大的英语损失。研究论文,见图 1、图 9 和图 13OFFICIAL LoRA 对照实验和表 1OFFICIAL

想算 12.2%,去看独立复跑报告的表 1。它把目标定在全参数组最大韩语进步的 90%,对应约 0.1425 纳特。表中全参数组的英语损失增加了 0.0365,冻结组增加了 0.0321。用复跑报告的成对估计,少增加的约 0.0045 除以全参数组的约 0.0365,原报告用未舍入值报 12.2%。总论文图 9a 把 12.2% 标在横轴约 0.111 的虚线旁,和复跑表 1 的目标位置有出入。这里只用图读比较方法,用表 1 核算百分比。独立复跑报告,第 4 节和表 1OFFICIAL

论文图 9a,横轴是韩语学习收益,纵轴是英语遗忘。蓝线为全参训练,绿线为罕见词词表行冻结,另有两条 LoRA 曲线。竖虚线展示相同韩语进度的比较。
在同一条竖线上比较蓝线和绿线的高度。图 9a 的虚线约在 0.111 纳特。12.2% 的核算使用独立复跑报告表 1 所列的 0.1425 纳特对照点。 Ahmad、Anderson 等,论文图 9a,第 16 页
科研报告独立复核的三道检查
要做什么复核者怎么动手做完能说什么
核对数字从正文的 29.7% 找到原始运行、英语损失与训练前的基线。照原规则重算分子、分母和舍入。这份表里的数能从这批记录算出来。
重跑实验锁定模型、代码、数据划分和指标,独立开跑。先重做原设定,再用成对种子扫学习率,留逐轮日志。原设定同样可能跑出约三成的差异,也能看到这个差异怎样随学习率改变。
验证结论先定双方都够得到的韩语进度和最小收益。在同一进度比较英语遗忘,报区间,再用新数据复测。这组设置下冻结确实少忘了一点。是否省到值得改训练流程,要看约定的门槛。

一、把小数点算回来

数字复核可以从一张 CSV 开始。先标出两组开训前、收工后的英语验证损失。两次相减才是各自忘了多少,再用「全参数组的遗忘减去冻结组的遗忘」除以全参数组的遗忘。把文件名、行号、公式和小脚本一起交回去。论文审计了 421 篇报告,在其中 104 篇里把 23,811 个数追到文件字段,93.8% 原样吻合,其余差异可追到舍入、换算或符号。这个比例说的是找到出处的数字。余下的数字要逐项注明找不到文件还是口径没写清。研究论文,见图 1、图 9 和图 13OFFICIAL 公开研究档案OFFICIAL

二、把训练重新开起来

Lab 22 先照着原来的设定跑。只看原先选定的学习率,它算出少忘 29.8%,和 29.7% 很接近。另一件事要多做几轮。冻结和全参数训练各试五个学习率,每个再用三种数据顺序,两组按相同顺序成对跑,加起来 30 次。换一台机器复跑时,要记下模型权重版本、训练语料和划分、学习率、随机种子、依赖和设备,再把韩语和英语验证损失写回日志。第二个人拿到的是一张可以重画的曲线,连哪一段跑不到目标也能查。独立复跑报告,第 4 节和表 1OFFICIAL

三、问原来的标题还能说多大

复跑者在训练前把值得采用的收益写成少忘 0.005 纳特。主对照的估计是少忘约 0.0045,95% 区间是 0.0037 到 0.0052。三次成对实验方向一致,区间却跨过了预先定的门槛。这时候可以说这次有效果,能不能省到值得把冻结写进默认配置,还得再测。要把结论推给另一种语言或模型,拿新的语料和验证集再跑一次,照样先写下进步目标和收益门槛。独立复跑报告,第 4 节和表 1OFFICIAL

交给第二个人时,要留下什么?

给复核者一份能独立拿取的材料包,里面有原始分数、代码版本、配置和预先写好的判断标准。请对方回交三样东西。一份说明每个数从哪里来的对账表,一份自己跑出来的记录,一份写清哪些结论站得住的复核意见。遇到跑不到相同进度的组就当场记下来,别往数据覆盖不到的地方画线。

一份科研报告怎么独立复核

  1. 1 核对数字定位原始文件和行号。重算基线、分母和百分比,记录舍入。
  2. 2 重跑实验用固定的代码、权重和数据先重跑原设定。再用配对数据顺序跑学习率网格,保存全量日志。
  3. 3 验证结论先约定两组共用的韩语学习目标和收益门槛。比较同一进度的英语遗忘,报告区间。换数据时再验。
  • 收益达到门槛写明适用条件、数据和误差范围。
  • 收益小于门槛或证据不足收窄结论。若两组到不了同一目标,记录缺口并补跑。
图解以 Lab 22 的训练复核为例。对账表、新运行日志和结论各留一份。独立复跑报告,第 4 节和表 1OFFICIAL

936 份报告留下了什么

总论文里最长的引用链串了 101 步。作者用偏向近期论文的随机引用做对照,平均也能串到 99.4 步。想知道后来的一篇真的改进了什么,我会挑一个结论往回找,看看它有没有留下第二份能跑的记录,以及哪一组新对照让原作者改了说法。三小时后那句追问,比链条又长一格更有分量。研究论文,见图 1、图 9 和图 13OFFICIAL 早期让 Agent 独自写论文的实验,见 本刊深潜《AI Scientist 的科研自动化之路》SELF。

论文示意引用链随日期增长,最长一条 101 步;图中注明按近期文章抽样的随机对照为 99.4 步。
这条线一路接了 101 步。右边的对照也接近 100 步。要找哪次复核真的改了结论,还是要回到代码和实验记录。 Ahmad、Anderson 等,论文图 1b

本刊怎么看 如果只能给第二位复核者一天,我会先让他拿到原始文件,再请他重做最可能改写标题的那项对照。这一次,29.7% 确实可以重现。能拿去做决策的是另一句话。在这组韩语训练里,学到同样多时冻结词表少忘约 12.2% 的英语,实际收益还有待确认。

数字人会说话了,什么时候该闭嘴?

双人播客

数字人正在说「周五下午三点,我会把安排发给大家」。说到「三点」时,用户突然插进来一句「等一下,改到四点」。用户希望先听到旧话停下来,然后听到「明白,周五下午四点」,同时看到嘴型跟着这句新话走。这几秒里发生的事,可以一项一项验。

Duo 把什么时候开口放进交互模型

Duo 在输出声音和画面时仍然接收用户的声音和视频。Intent 模块根据当前线索决定要开口还是继续听,Realization 模块把这个判断连同上下文生成新一段声音和画面。论文的串流方案每段采 17 帧,在 24 帧每秒下约 708 毫秒。这个数是采样窗口,用户端听到的停声时刻还受已排队的声音影响。Duo 的 wait 表示这段不开启新一句,上一句的声音仍可能继续。听到「等一下」后有没有真正停声,要看最终播放。Duo 论文与串流方案OFFICIAL

Duo 实时对话演示
作者项目页的实时对话样例。观察用户声音与数字人回应如何交替。正文的两句改期题需要另测停声、接话和音画同步。 Duo 作者项目页

LongCat 把改过的那句配上正确的口型

LongCat-Video-Avatar 1.6 用给定音频驱动角色视频,重点改善口型、表情和长镜头里的人物一致性。接到这场对话里,可以把「明白,周五下午四点」的音频交给它,看嘴型、表情和画面能不能一起接上。美团用 508 组图像与音频做评测。在半速播放的严格复核里,口型不同步的问题率由 83.7% 降到 82.5%。表情和动作与音频不符的问题率从 13.0% 降到 6.7%。这两组数字都来自团队自己的视频评测。LongCat-Video-Avatar 1.6 技术报告OFFICIAL

听同一段音频在 LongCat 1.6 里的口型
美团的 13 秒原片。打开声音,留意每个音节开始时的嘴形和句末停顿。项目页把同样的输入交给 1.5 和 1.6 跑了一遍;片段测的是给定语音的画面表现。 美团 LongCat 团队,版本对照第 3 例

用户说了声「嗯」,Haru 会让出话头吗?

同周开放权重的 Haru-4B 给了一个只测声音的对照。团队先把混录里两个人的声音拆成对齐的两路,再让模型在同一条时间线上学听和说。停顿时应一声「嗯」,和抢在对方说完前念答案,都能在双轨录音里分开看。作者在 M1 Max 的 Swift 应用里实测处理一帧约 65 毫秒,含麦克风、模型和耳机,音频凑帧的等待另算,最多可加 133 毫秒。把这套接进数字人时,可以让同一个人先说「嗯」,再说「等一下,我要改地址」,各测模型会不会误停、旧声音多久消失、新一句是否对上口型。语音这关能单跑一次,再接画面定位剩下的等待。Haru 开发者的开源发布帖 Haru-4B 技术报告与真实录音说明OFFICIAL Haru 推理代码与权重入口GITHUB 站内前情见 本刊深潜《Interaction Models》SELF。

Haru 团队对照串接识别与合成、轮流对话、交错音频以及两路并行的建模方式。
看最后一组,两路声音共用时间轴。一条轨道还在说时,另一条已经可以进来,才能在录音里区分附和和真正要抢话。 higurashi 技术发布文原图

从用户最终看到和听到的地方取时间

用同一时钟录下用户麦克风、扬声器实际播放的数字人声音和屏幕画面。标好用户插话的起点、旧话最后一声、用户说完「四点」的时刻,以及新回答第一声。把插话点固定在旧句中途,给旧句留出足够长的尾音,才能分辨主动停声和自然说完。

用一次突然插话测停声、接话和音画同步
验收项怎么量哪些算失败
停声从用户说出「等一下」的第一声计时,到数字人的旧话实际停播。记录停声延迟。该停时仍念旧稿,或只听见一声附和就误停。
接话从用户说完「四点」到新回答第一声,记录接话延迟。单独检查时间是否改成四点、日期是否仍是周五。用户还在说就开口、继续答三点,或超时没有回答。
音画同步把「明白」里「明」的 /m/ 起声和视频闭唇帧标在同一时间轴上。记偏差多少毫秒和声、嘴谁先。停声后还在播旧口型,新话开始时音画错位,或切换时脸部明显跳帧。

同一句改口,再加一次停顿和一声附和

第一遍让用户直接说「等一下,改到四点」。第二遍在「改到」和「四点」之间留 400 毫秒,看看系统会不会把半句当成结束。第三遍用户只说一声「嗯」,按脚本继续听,测会不会误打断。固定音量、设备和网络条件重跑,把停声与接话的中位数、P95、超时和抢话次数一起报。同步偏差在插话前、停声处和重开口时分别看,并与同一句没有被打断时的表现对比。验收要同时看到旧话确实停了、新话答对了、画面也换到新话。

旧话没停,是模型没发指令,还是播放器没停?

在测试播放器里把四个信号各存一份:用户输入,系统决定停止的时间,真正送到扬声器的旧话,以及屏幕上最后一帧旧口型。如果系统及时发了停止信号却晚停,重点查播放端缓冲。如果声音停住、画面还在念,再查两路队列的切换。对照组保留一句不会被打断的话,能看出切换过程有没有额外拖慢原本正常的对话。

本刊怎么看 让用户在半句话时插进来。先听旧话能不能停,再听新时间说对没有,最后看嘴型跟没跟上。Duo 给了第一步的线索,LongCat 的视频适合看第三步。把两头接起来,还得拿用户手上的设备完整走一遍。

搜索快了,答案也更好吗?

双人播客

假设用户问:「周五活动几点开始?」旧 FAQ 写三点,新公告改到四点。搜索要把新公告找回来,回答要给出四点和对应出处,用户还要等到完整答案出来。这三关各有一个量法。

SID-2 先看有没有把对的文档排上来

SID-2 Swarm 把搜索分给多个 Agent,最后交回排好序的文档。作者的验证集覆盖 19 个语料库和 506 道查询。六个 Agent 的 SID-2 Swarm 和最高推理档的 GPT-6 Astra 都在约 0.70 NDCG,模型推理时间分别估算为 18 秒和 135 秒。NDCG 给靠前且更相关的文档更高权重。报告用 token 用量等估算模型推理这段时间。用户等到答案还要经过检索后端、取网页和回答生成。放回改期例子,先看新公告排第几。SID-2 技术报告与时间估算OFFICIAL

索引少存四分之三,公告还能排到前面吗?

文档多起来以后,还有一笔容易忘的账。用多个向量给每篇文档建索引,改期公告里短短一行就有机会被单独找出来,几百万篇文档也会把向量库撑大。Sentence Transformers 的实验把每篇约 193 个向量压到约 49 个。在同样的 49 个向量预算下,训练时就让模型经历这次压缩,NanoBEIR 的平均 nDCG@10 从 49.03 提到 51.23。这个数字衡量排名。上线前再看实际索引占用、尾延迟,以及最终还有多少人能拿到正确的四点。Sentence Transformers 多向量压缩实验OFFICIAL背景 · 2026-11-11

Parallel 再看加了搜索以后,答案对了多少

Parallel 把题集、搜索过程和裁判拆开。同一个模型可以在同一批题上跑闭卷基线与开启搜索两轮,再让固定裁判对照参考答案给分。参考答案只交给裁判。团队也可以带自己的问题和评分规则。这里就把「四点」和最新公告放到验收数据里。即使新公告排第一,模型答成三点,这一关照样记失败。Parallel 搜索评测框架OFFICIAL Parallel 开源评测仓库GITHUB

榜单上就有可以对账的一行。Parallel 18 日更新的结果里,Gemini 4 Neon 不开搜索时是 42.5 分,打开同一套搜索工具后是 88.1 分。Neon 做 1,000 道题花 206 美元,Fable 5.2 是 2,063 美元、86.9 分。分数来自三套题的综合评测。这两行都还没列出完整用时,所以选哪套答复用户,还要记下从提问到答案出现等了多久。Parallel 搜索榜单与计费口径OFFICIAL Parallel 榜单发布帖

同一批问题的搜索验收指标
验收项怎么测改期题怎么判
找对文档先标注有效的证据文档和相关程度。量前 K 条覆盖多少证据(Recall@K),以及高质量证据排得多靠前(NDCG@K)。锁定公告版本和生效时间。最新公告给高分,过期 FAQ 留在题里当干扰。
最终答对固定回答模型、题集和评分规则,对比闭卷及开搜索的正确率。另记引用能否支撑结论。时间要答四点。引用检索结果时,链接要指向写了四点的那份公告。
整条链路耗时在同一客户端,从提交问题到完整答案显示计时。记录中位数、P95 和超时率。检索、抓取、重排序、生成和传输都计入。按阶段记录时间,方便定位慢在哪。

用同一套问题跑三张成绩单

做搜索对照时一次只换一个条件。比较两个检索方案时,固定回答模型、提示词、题集和工具调用预算。用同一批版本锁定的文档查相关性,按实际服务配置另跑端到端耗时,冷缓存和热缓存分开记。每道题都留下召回文档、最终答案和各阶段时间。找对了公告却答错,先看模型用了哪条证据;答对但尾部很慢,再查卡在检索、读网页还是生成。

DeepSeek 开放「全家桶 API」,搜索这一步谁说了算?

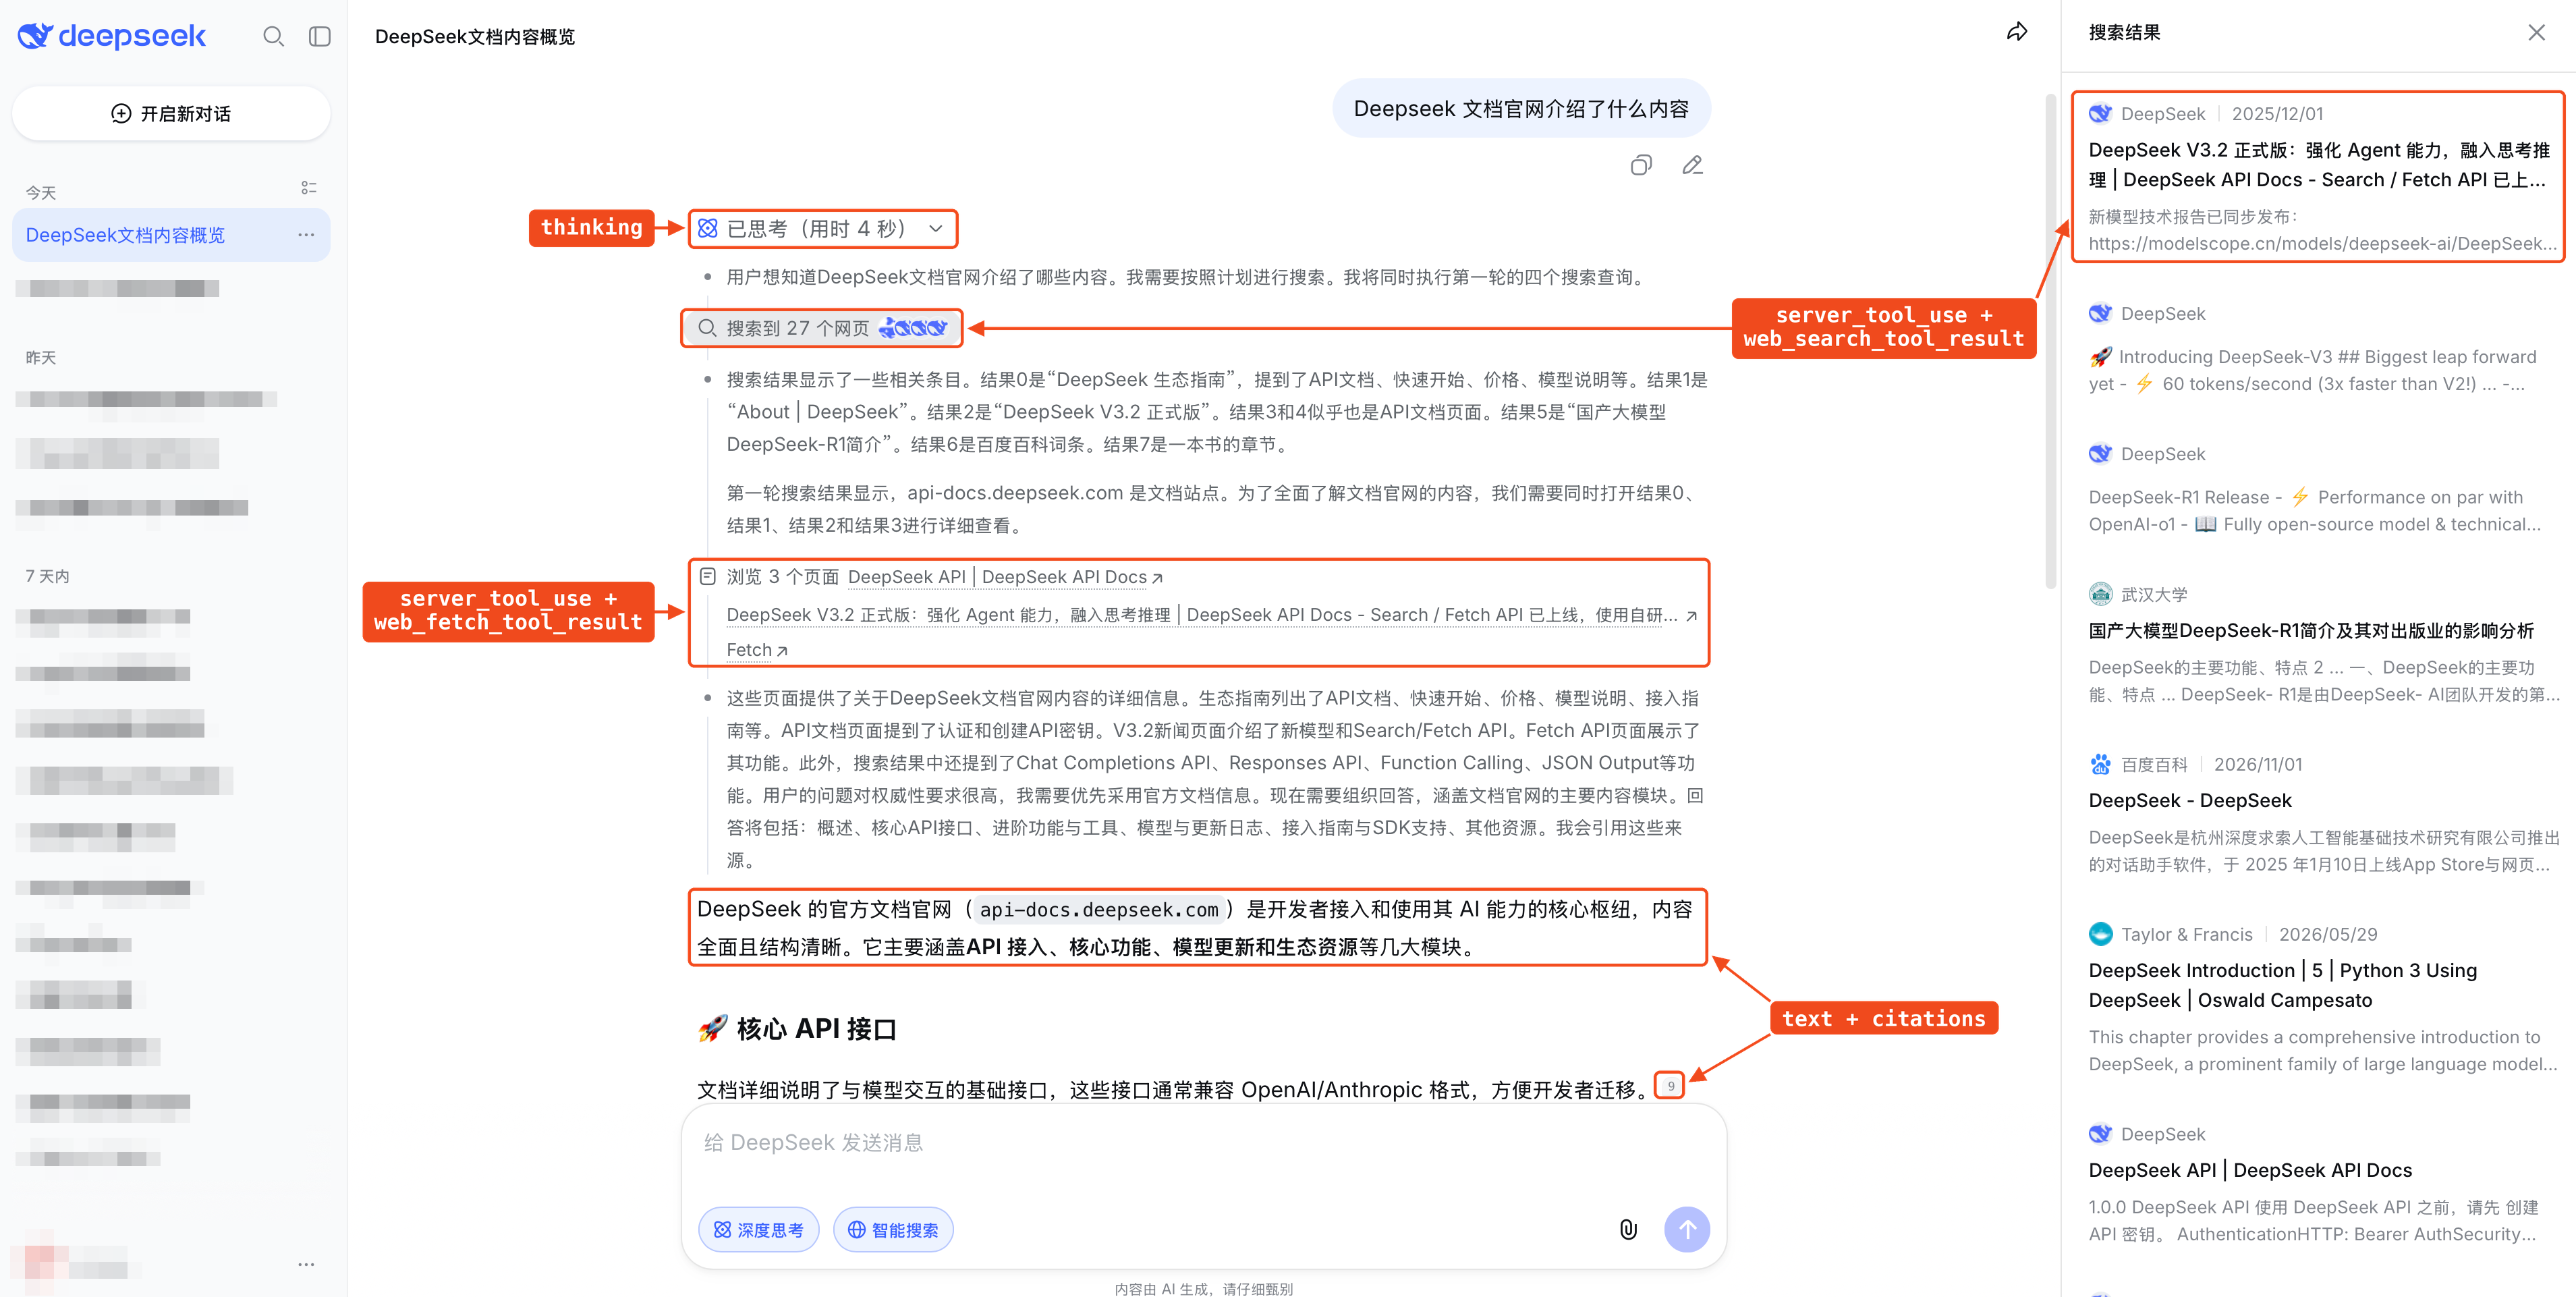
读者问「周五活动几点开始」,又发来一个活动网页和一张旧海报。11 月 13 日,DeepSeek 把 App 里的几项能力开放给开发者。用 deepseek-flash,可以在 Messages、Responses 或 Chat Completions 接口上开启普通联网搜索、深度思考搜索、文件输入、链接读取和基础内容安全检查。启用联网工具后,由 DeepSeek 服务端选搜索词、取结果并拼进对话。也可以只接自己缺的那块,独立调用 Search、Fetch、OCR、语音识别(ASR)或语音合成(TTS)。官方开源的 Chat Demo 展示了上传文件、语音输入和朗读怎么接进同一个界面。DeepSeek 11 月 13 日官方更新日志OFFICIAL DeepSeek Chatbot 接入指南OFFICIAL DeepSeek 官方 Chat Demo 源码GITHUB

账单也跟着分两条路。北京时间 11 月 18 日 12 点起,模型触发的服务端搜索和抓取免收工具调用费,读进模型的结果仍算 token。若自己调独立接口,文字 Search 和 Fetch 每千次成功请求各 5 元。假设一千道改期题都恰好查一次、读一页,光搜索和抓取就是 10 元,答复所用 token 另算。文件解析和 OCR 按页计,每千页 1.5 元;语音另外算,ASR 按音频时长,TTS 按字符数。DeepSeek 搜索和抓取官方价表OFFICIAL DeepSeek 人民币价表OFFICIAL

这一套省的是把工具串起来的活。要验收改期题,我会让内置搜索和自管搜索分别答同一批问题。前一组用返回的搜索结果、网页和引用追查新版公告去哪了,后一组可以把校方只在内网发的改期通知也纳入候选。两边都记最终答对率、P95 和每题成本。还有一个容易漏的细节。指南写明,在 Responses 请求声明内置搜索或读链接工具时,max_tool_calls 会被忽略。需要严格限制「每题最多抓几页」的业务,走独立接口更容易把这条预算落实到每次调用。DeepSeek Chatbot 接入指南OFFICIAL

DeepSeek 的官方界面示意,标出一轮对话中的思考、联网搜索、阅读网页和最终答案及引用。
DeepSeek 在官方示例里标出了搜索结果、读过的网页和最终引用。排查改期题时可以顺着这三段找,先看有没有搜到公告,再看模型读的是哪一页。 DeepSeek 接入指南原图

找到公告后,谁负责把它读进来?

搜索把改期公告排到了前面,Agent 还得把那一页读进来。Firecrawl 在 18 日发布了用 Rust 重做的 Local 版本,常见网页的抓取、站点链接收集和文档解析可以在自己的机器上跑。项目文档也把去云端的情况列出来了。搜索要用云端索引,遇到本机和本地浏览器都拿不到的页面,默认可以请云端代取。想知道换这一步值不值,可以用同一批公告比一次,分别记正文有没有抓全、用了多久、哪些请求最后走了云端,再看问答那一栏。Firecrawl Local 发布说明OFFICIAL Firecrawl 源码说明哪些请求会走云端GITHUB Firecrawl 联合创始人的转帖

公告排到了前面,答案怎么又错了?

如果新版总能把公告挤进前三条,最终答对率却降了,抽出同一批题的输入输出,查回答器是否仍优先照抄旧 FAQ。如果答对率涨了、P95 也涨了,再按查询类型分组,看是不是少数必须取外网页的题拖住全局。记录未作答题,超时算进总题数。否则完全卡住的那批题被删掉,速度和正确率会同时显得好看。

看一遍视频,能确定动作只发生三次吗

搜索选对一句,还不一定答得对「一共几次」。NexSight 把这个问题放进 108 条长视频,出成 310 道每题可以追到证据片段的测试。论文里表现最好的模型自己找片段时答对 54.52%,直接给人工标注的证据后答对 79.35%。后一个数字也没到 100%。研究者因此要求合成题能让另一个不知道原答案的检查者重新找证据,并找有没有漏掉的反例。NexSight 论文OFFICIAL

回到周五活动的例题,可以先让系统自己搜,再单独喂给它正确的改期公告。两次都答三点,问题多半出在读证据或把答案写出来;只有第一次错,就去看看哪份文件没进候选。视频题也一样。把证据里记下来的动作和全片真实的出现次数核到一起,才知道它有没有漏看或重复数。NexSight 论文OFFICIAL

作者还把两种看视频的方法约束在同一帧预算内。让模型主动选时间窗,证据召回从 19.84% 升到 40.63%,跨时间段计数和判断状态发生变化的题却没有随之变好。落到前面的改期查询,即使找到了公告、日历和旧 FAQ,仍要看系统能不能认出哪一份覆盖了旧时间。NexSight 论文OFFICIAL

NexSight 论文图 4,比较不同模型在固定帧输入和自主探索模式下的准确率。
同一模型的深浅两段各是一次独立得分,不能加在一起。对照不同看法时,先确认给它的是固定帧还是可以自己选片段。 Tianci Xie 等,NexSight 论文图 4 · CC BY 4.0

本刊怎么看 给两套搜索都问同一批问题,在同一个客户端按下计时。哪套更快、哪套常把活动时间答错,看完这两张成绩单再决定用谁。

本期记录 9 组模型发布。成组发布的型号合在一条。

可下载权重 3 组

通过 API 使用 4 组

托管平台 2 组

算力与治理

  • 11-17黄仁勋与 NVIDIA 法务有了国会问询日期

    众院委员会公告列黄仁勋 12 月 1 日、总法律顾问 Tim Teter 12 月 2 日。NVIDIA 同日宣布设立董事会层面的出口管制监督委员会。美国众院委员会排期OFFICIAL NVIDIA 董事会公告OFFICIAL

  • 11-17MLPerf Training v6.1 披露多节点提交

    117 套多节点系统,占该分析中的 153 套系统。多卡从选配变成多数提交采用的做法,哪些工作从扩卡得益最多,详见 专题《卡堆到一万张,训练快了多少?》SELF。MLPerf Training v6.1 分析OFFICIAL

  • 11-18并购Palo Alto Networks 拟收购 Applied Compute

    已签约全股票收购,估值 45 亿美元,可按条款调整。Applied Compute 做开放权重模型的后训练与推理。双方预计在 Palo Alto Networks 2027 财年第三季度交割,仍待监管等条件。Palo Alto Networks 收购公告OFFICIAL

  • 11-18硬件RTX Spark 台式机开始卖,最高 128 GB 统一内存

    NVIDIA 公告称 ASUS、Dell、MSI 的首批机型已经供应。想在本地常驻跑一个 Agent,先看模型连同长对话能不能装进内存,再看可接受的速度和整机成本。这里公布了容量,具体任务的表现由购买者实测。NVIDIA RTX Spark 上市公告OFFICIAL

产品与用户数据

  • 11-18娱乐迪士尼与 AWS 展示三款互动人偶原型

    模型按现场情况挑选预录台词并驱动动作。原型安排在 11 月 30 日至 12 月 4 日的 re:Invent 展示,乐园部署待公布。Disney Imagineering 人偶原型OFFICIAL

  • 11-17消费应用Character.AI 拟出售的资产包含聊天记录

    破产程序中披露的起始竞价是 1,000 万美元现金加承担约定负债。11 月 16 日提交的收购协议把账户资料、用户创建的角色和聊天记录列作拟转移数据。11 月 17 日法院要求任命消费者隐私监察员,交易仍待法院批准。破产法院案卷 164 号 · 起始竞标OFFICIAL 破产法院案卷 179 号 · 拟议收购协议OFFICIAL 破产法院案卷 181 号 · 隐私监察员命令OFFICIAL

  • 11-14硬件Meta Muse SDK 开始试验 ESP32 小应用

    SDK 合入可选的 WebAssembly 支持。带 LVGL 和外部 RAM 的兼容开发板可编译和运行秒表、传感器仪表盘等小应用,功能默认关闭,需构建固件并启用。Muse Gadget SDK 合并记录GITHUB

  • 11-15Qwen Code Desktop 加了工作区留痕

    v0.27.4 的发布记录列飞书 webhook、工作区记忆导入与每轮 hook 记录。Qwen Code Desktop v0.27.4GITHUB

  • 11-17推理服务Hugging Face 把语言模型供应商的选择交给 OpenRouter

    请求仍从原来的接口发出,平台按实时价格、速度和可靠性转给供应商,失败时能换一家。需要团队自己挑时,可以指定便宜、最快或者固定供应商。公告还写明,语言模型接入的自带供应商 Key 不再适用。如果公司的数据只能交给指定供应商处理,先打开设置确认还有没有锁住这家。Hugging Face 推理供应商变更公告OFFICIAL
  • 11-19开发工具Kimi Code CLI 2.7.0 加入 Bedrock 支持

    发布记录增加了 Amazon Bedrock 作为模型提供方,另外写了几项会话修复。用不同账户跑同一份项目时,先从日志核对所选的模型和供应商。这是客户端更新。Kimi Code CLI 2.7.0 发布记录GITHUB

研究与评测

  • 11-16METR 测到模型能区分两类评测

    在其 55 道任务样本里,Opus 5.5 在开放问法的评估中区分了能力题和对齐题。结论适用于该样本和评测方式。METR 研究笔记OFFICIAL

  • 11-16科研OpenAI 扩大学术研究计划

    下一轮 11 月 23 日开始,计划开放 5 万份资助,每份提供申请人和最多两位合作者的 ChatGPT Plus,整个计划目标为最多 20 万名研究人员。同期发布的试点分析覆盖 1,819 名科研人员逾 58 万条科研消息。按参与者等权平均,阅读与写作合计占科研消息过半。OpenAI 学术项目扩容公告OFFICIAL OpenAI 学术试点用量研究OFFICIAL

  • 11-16评估OpenAI 启动四家外部机构驻场评估

    Apollo Research、Goodfire、METR 与 Transluce 已签约。方案按各评估项目约定范围开放训练检查点及内部系统,计划公开报告。参与的机构和怎么评都定了,接下来等各家公开结果。OpenAI 外部驻场评估安排OFFICIAL

  • 11-18开发评测3D 游戏跑得了,玩家未必喜欢

    3D GameDev Arena 给 Agent 108 个从零做浏览器 3D 游戏的任务,覆盖 14 类。运行平均约 1,000 次模型调用,最长一次到 14,407。验收有代码层功能、试玩与画面、真人匿名比较三个层次。代码过关和玩家更爱玩,有时会给出两份不同的名单。3D GameDev Arena 论文OFFICIAL

  • 11-18推理实验NarrowSpec 把帮大模型打草稿的网络做窄

    小网络先猜一段输出,大模型再一起核对。论文把草稿网络收成一半或四分之一宽;批量为 1、温度为 0 的条件下,两组目标模型的解码在 B200 上提速 1.06–1.12 倍,在 DGX Spark 的 GB10 上提速 1.13–1.44 倍。它量的是解码,读长提示的等待时间还得另测。NarrowSpec 论文OFFICIAL

  • 11-18长上下文让小模型先翻一遍整叠图文材料

    SkimPrefill 用一个 0.8B 模型先挑图和段落,再把挑中的材料交给大模型。在 128K token 的 MMLongBench 实验里,只留下 10% 的输入,三个目标模型的预填充加快 3.7、11.6 和 8.2 倍,平均准确性保持。个别题尤其要查被筛掉的图或文字是否刚好是那一份关键证据。SkimPrefill 论文OFFICIAL

医疗与科研投入

  • 11-17医疗 · 药研Isomorphic Labs 宣布 50 亿美元 C 轮

    融资将用于推动候选药物进入临床。公告披露的是融资及用途,后续看临床结果。Isomorphic Labs 融资公告OFFICIAL

  • 11-16医疗Abridge 引入 Cochrane 证据库

    把系统综述和 Clinical Answers 接到医生已经使用的 Abridge Assistant 里。医生用原来的工具就能查到这些资料。Abridge 与 Wiley 合作公告OFFICIAL

产品发布
11-21 至 11-27 故事线 A · 算力准入把握 中

受限客户租海外算力,能不用申请许可吗?

BIS 正式规则按客户归属和服务范围确定许可要求,商业推荐系统的排除条件也已明列。 美国联邦公报 91 FR 74970(正式 PDF)OFFICIAL

预测11 月 27 日前,BIS 不会发布覆盖受限总部和最终母公司的普遍远程算力豁免。 判定口径 如 BIS 发布正式规则或通用许可证,使这类客户在第三国数据中心可普遍绕开该许可要求,这条预测被推翻。
11-21 至 11-27 故事线 B · 任务成本把握 中

Google 的异步折扣会不会变成同步折扣

现在得把 Gemini 请求排进后台队列,才能拿到这档优惠。 Deferred tier 文档OFFICIAL

预测11 月 27 日前,同步交互式 Gemini 调用仍没有 Deferred tier 的五折待遇。 判定口径 Google Cloud 正式发布适用于同步交互调用的同一折扣档,即推翻。
11-21 至 11-27 故事线 C · Agent 回归把握 中

Copilot Code 的正式版本会不会赶在一周内到

微软 11 月 17 日说 Code 会在未来数周正式可用。 Copilot 发布明细OFFICIAL

预测11 月 27 日前,微软尚未宣布 Copilot Code 全量正式可用。 判定口径 官方博客、发布记录或文档明确写明 Copilot Code 已面向符合通常许可条件的客户正式开放,即推翻。

AI 解释设置

开启后,选中的文字和附近的上下文会发送给你配置的模型。

模型与 Key
AI 解释
▶ 本期分享 · 视频导览 滑动到文章 · 高亮卡片点击播放对应讲解 收起 ▾