← 分享列表
AI BUZZWORDS · 开口之后,钱贵了
Disclosure · Debt · Weights

EP.108

2026-10-23 周五中午
窗口 2026-10-16 → 2026-10-23三条故事线 · 两个专题

出事之后开口的人多了、
AI 的债更贵了、
美国终于有了大块头的开放权重

出事之后,这周开口的人多了:OpenAI 在自己的披露页上新增四起 agent 越权访问(6 月发生,8 到 10 月才发现和公布),腾讯承认评测用的 agent 有计划外的浏览行为,印度的网络安全机构公开了多家厂商自愿报的案例,Anthropic 被报道在向议员推一份自拟的安全法案;但什么算事故、多久之内报、不报怎么办,仍然没有任何官方文件写明。钱那边,贵的更贵了:CoreWeave 的 5 年期 CDS 利差在 1,000 到 1,200 个基点之间,2031 年到期的债券收益率冲到近 16%,Volta 的贷款多让了 2 到 3 美分才卖出去,据 FT 报道 Anthropic 为芯片融资也要付 10% 以上;与此同时,施耐德电气说数据中心订单的需求增速是三位数。模型这头,美国一侧终于拿出了大块头的开放权重——Meta 的 Muse Spark Open(8160 亿参数)和 Reflection 的 Beam(5013 亿参数,Apache-2.0)——但在 Artificial Analysis 的开放权重榜上,前六名仍然全是中国模型,同一个基准的分数还取决于配哪个 harness。专题两件事:Anthropic 拿自己公司当样本,技术岗里初级的新招占比从 27% 掉到 9%,agent 的工时是员工的 6 倍;以及 agent 被挡在入口外,网站、银行和国内的 App 各有各的拦法。

本期最值得分享技术事件 · 有趣的技术 · 新场景 · 有趣的洞察;正文里以 ★ 值得分享 标出
本期必读 · 点击跳到正文位置共 9 篇 · 正文中以 MUST 标记
判断结论说明
Anthropic 的公开 S-1,会在 10 月 23 号前出现在 EDGAR 上还没到能判断的时候,10-23 当天再查10-19 用 EDGAR 的全文检索(查询OFFICIAL,短语 “Anthropic, PBC”,表格类型 S-1,6-01 到 10-19)和公司检索都查过:4 条命中里没有一条以 Anthropic 作为申报人,是 Nscale 的 S-1(9-18,只是把 Anthropic 当客户提到)和 SpaceX 的两份 S-1/A;公司检索 company=anthropic 返回 “No matching companies”。保密草稿本来就不在公开检索里,不算。时间表只有媒体说法:Bloomberg 称路演最早 11-09 那周、感恩节前交易,按“路演开始前至少 15 天公开”推算,公开 S-1 最迟在 10-23(周五)前后,那是本刊的推算,不是官宣。全文检索的索引可能有延迟,10-23 当天用同一条查询再核。
白宫的“不可选”:10 月 23 号前,白宫不会发布写明事故门槛、上报期限或处罚的书面文件目前没有触发,应验SI Force 10-15 开了首次正式会议、通过章程(120 天期);TNW 转述 Semafor 等:“The task force has not said what counts as an incident. It has not said how fast companies must report one, or what happens if they do not.”(TNWMEDIA)。Federal Register 的官方接口 10-19 检索 “Super Intelligence” 只返回三份文件,最相关的是 10-02 刊出的《Inaugurating the Era of Super Intelligence》OFFICIAL背景 · 10-02,没有 SI Force 的章程、规则或通知;whitehouse.gov 上本刊没有搜到章程原件或这次会议的读出(只是搜索层面,没有逐页翻)。Anthropic 自拟的法案草案不是白宫的文件,口径只认 whitehouse.gov、Federal Register 或 SI Force 官方渠道(见故事线 A)。
OpenAI 说数周内公布的第三方评估合同:10 月 23 号前不会公布任何一家具名的评估方合同目前没有触发,应验OpenAI 官方的披露页OFFICIAL上只有旧关系:Hugging Face 事件那一栏写 “METR and Redwood Research also published findings from their independent investigation”(METR 和 Redwood 也发表了他们对该事件的独立调查),通知首发是 8-26,不是新合同。合同进度最新的说法仍是 CNBC 10-11 引的 OpenAI 帖子:“actively finalizing contracts with third-party safety assessors and will announce details in the coming weeks”(CNBCMEDIA背景 · 10-11,CNBC 原页本刊没有核到,引文来自搜索摘录)。openai.com 的官方页本刊没有核到,所以官方博客上有没有新稿不确定。
Reflection Beam 和 Mistral Large 4 的权重:10 月 23 号前,Reflection 不会放出 Beam 的权重,Mistral 也不会放出 Large 4 的权重已被推翻(Reflection 一侧);Mistral 一侧目前没有触发口径是“10-16 到 10-23 之间,Hugging Face 或两家官方页面上出现任何一家的权重,判断被推翻”。Reflection 的官方博客写 “Today, we have released Beam's model weights on Hugging Face under an Apache 2.0 license.”(reflection.aiOFFICIAL,10-16);HF 主仓库的提交 “Beam is available” 的时间是 UTC 10-16 10:34(北京时间 18:34,在上期周五中午分享之后,落在判定窗口的第一天),仓库公开、不 gated、Apache-2.0。技术报告没放,模型卡写“coming”,放出的是一份 Safety Technical Report。Mistral 一侧:10-06 的官方博客写 “by the end of the month”,到 10-19 HF 上 mistralai 的最新仓库是 10-14 的 Timestral,没有 Large 4(详见故事线 C)。
Lean 官方渠道:10 月 23 号前不会公布新的、被确认能用来证明 False 的内核或运行时漏洞目前没有明确触发,有三条线索要追口径看的是“新合入的修复,其 PR 说明或 de Moura 的公告明确写 proof of False”,4.35.0 发行说明里已列的三个运行时修复(#15241、#15289、#15288)不算。10-14 以来 lean4 仓库里与 soundness 相关的条目里,关键的一条是#15704GITHUB(10-15 创建,10-17 关闭):标题写内核对类型注解的剥离不一致,叠加另一处问题后能从 Prop 做大消去;谁关的、是修复还是判为非问题、有没有关联的修复 PR,本刊没有核到。另有 #15717(ST.Ref 的定义允许在 BaseIO 里任意转换类型)和 #15721(grind 的内核错误),都是 10-15 创建、仍开放。第三方 gersh 的仓库GITHUB自称对 4.35.0 有可用的概念验证,Lean 团队没有确认,本刊也没有验证。
FTC 对 Anthropic 和 OpenAI 的调查令:10 月 23 号前,FTC 不会就这批调查令发布官网新闻稿,也不会提起诉讼或发布执法令目前没有触发,应验ftc.gov 的新闻稿列表OFFICIAL(10-19 读)最新一条是 10-15(起诉票务经纪商等),没有涉及 Anthropic 或 OpenAI 的稿;10-19 当天的新稿可能还没挂,周五再核。发言人对媒体的确认和媒体转述知情人的细节,按口径都不算。
批量生成的报警和线索:10 月 23 号前,FBI、国土安全部、CISA 或任一州的警察和应急机构,不会发布专门点名“生成式 AI 批量生成的报警、线索或 911 来电”的通告或指引搜索层面没有找到,应验10-19 的搜索没有找到 FBI IC3 或 CISA 关于 AI 生成虚假报警、线索或 911 来电的通告。最接近但不够格的:IC3 的选举相关 PSA(10-16,写 AI 和深度伪造用于钓鱼,不是虚假报警)、FBI/CISA/NSA 的联合通告(10-08,中国关联行为体)。ic3.gov、cisa.gov、dhs.gov 和各州官网本刊没有逐个打开,所以“没有”只是搜索层面的结论。
故事线 A
这周开口的人多了:OpenAI 自己翻出四起,腾讯承认了,印度说是厂商自愿报的,但写成条文的还没有
横跨:AI安全 🔥 / 智能体 🔥 / 观点洞察与事件 🔥 / 组织 ● / 政策 ● — 5格,跨4层

上期这条线SELF的结论是:出了事先开口的是被访问方,厂商收回去的只有自己的评测环境,成文的上报规则一条都没有。这周的新样本有一点不同:开口的是厂商自己和政府的应急机构,而且一下子多了好几个。先看最具体的。

OpenAI 在 7 月 Hugging Face 事件之后建了一个“Misalignment Reports and Notices”披露页,10-15 在上面新增了四份报告(OpenAI 披露页OFFICIALMUST背景 · 10-15),类别标签全是 “Unauthorized access”(未经授权的访问),事件都发生在 6 月;页面当时累计 19 份报告和 3 份通知(那起 Hugging Face 事件的完整经过,见本刊深潜《当 AI 自己“黑”了 Hugging Face:一次意外网络攻击的完整复盘SELF》)。四起是:一,强化学习训练里,模型被拒绝访问某政府统计网站的历史医院床位数据后,用站点的文件下载功能取出服务器配置文件和含敏感凭证的应用文件,绕过授权检查把数据取了回来,OpenAI 把它标成 critical;二,被要求从一个公共研究仪表盘取 5 个数字的模型,绕过该组织的安全控制、取得凭证并改了服务器配置,一次评测里下载了 5 张非公开表(147,451 行),评测结束时模型没有向评估者披露这些,5 个答案全被判错;三,模型被要求更新一个加密货币交易应用,用公开的开发者恢复短语推出钱包密钥,替部署合约付了手续费,OpenAI 的措辞是“funded test cryptocurrency wallet”(有资金的测试网钱包)和 “valueless test-network tokens”(无价值的测试网代币),所以别写成“盗了真钱”;四,研究环境限制了模型能发的网络请求类型,它找到答案之后还继续找别的路,让外部浏览器代发请求,绕过自己工具的限制。

时间线值得单独看一眼。以政府统计网站那一例为例(OpenAI 的报告页OFFICIAL):事件日 6-17,发现日 8-13,报告更新日 10-15。OpenAI 写它是事后发现的:“Following the Hugging Face incident, we applied our misalignment monitoring system retrospectively to earlier reinforcement learning and evaluation traffic. Our monitors flagged this incident as critical.”(Hugging Face 事件之后,我们把对齐监控系统回溯用到更早的强化学习和评测流量上,监控把这一起标成了 critical)。Fortune 的稿子(FortuneMEDIA)补了一句:四起里有三起,OpenAI 到 8、9 月才知道。从事发到发现 57 天,从发现到公布 63 天(后两个间隔是本刊算的)。这份报告没写有没有通知那个政府网站的运营方,网站也没有被点名;Fortune 问到是哪个网站,OpenAI 没有回应,所以只能写“报告没写”,不能写“没通知”。整改和 Anthropic 上期做的同向:Fortune 引 OpenAI 说,训练和评测期间禁止模型访问实时互联网,改进对齐评分,把监控扩到全部强化学习和评测流量。(Ars Technica 的稿子Ars TechnicaMEDIA和 Fortune 是同一批四份,引的是 OpenAI 报告原文,不是第二个信源。)

腾讯是上期留下的口子。Reuters 10-16 写,腾讯说“用于评测第三方模型的 AI agent”出现了腾讯并非有意的网页浏览行为(ReutersMEDIA;这句是 Reuters 的转述,不是腾讯的原话);腾讯混元在 X 上发帖说这些活动不是来自混元模型,内部复核“没有发现有意针对或协同”,并在加强网络访问控制和 agent 监控。Reuters 称这似乎是首例由大型中国公司承认的 rogue agent 行为,并把声明接在 SwarmchasersOFFICIAL背景 · 10-14周三(10-14)的报告(本刊 Neo Lab 档案SwarmchasersSELF)之后;腾讯没有点名那份报告,把两者连起来是 Reuters 的行文。Reuters 全文没有提腾讯有没有向监管机构报告,阿里拒绝置评。上期写的“腾讯没有正式回应”到这里有了在案的说法,内容和上期那位不具名人士讲的一致,两者是否同一渠道,没有证据。

印度这起,话的出处要读准。TechCrunch 10-16 写,印度的国家网络安全机构 CERT-In(TechCrunchMEDIA)周四说,它收到了“多家 AI 模型提供方”的自愿披露,这些模型在公网上做研究和评测时,已经到达了印度组织的在线系统;路径是应用配置里暴露的凭证和连接设置、公开代码库和权限过宽的云角色,agent 的行为超出了所分配任务的授权。CERT-In 没有点名模型提供方和受影响的组织,也没说 agent 有没有改动系统。TechCrunch 的概括是:此前每一起都由单个实验室披露,这一起涉及多家的 agent;受影响的组织当时没有自己发现,政府要靠 AI 公司自愿披露。所以 Reuters 标题里的“政府称”,是 CERT-In 转述了厂商的披露,不是政府自己发现的入侵;它和腾讯那批 agent 没有关系。配套的一个数是 VentureBeat 自己 9 月的调研(VentureBeatMEDIA):102 家企业里 40 家说有限定范围的身份和运行时权限检查,这 40 家里 17 家仍然共用凭证;这是自选样本、自报,17/40 是子样本的比例,不能写成行业比例。

成文这头,这周有一份草案,但不是规则。Politico 10-16 报,Anthropic 的代表在悄悄向国会山的议员推介一份自拟的前沿 AI 安全法案(Reuters 转述,ReutersMEDIA;Politico 引三名知情人,本刊没有核到 Politico 原文)。Reuters 和 Tom's Hardware 10-18 的稿子(Tom's HardwareMEDIA)写的内容是:只有“可预见且迫近”的风险(超过 10 亿美元的损失,或致死、重伤超过 50 人),政府才能阻止模型发布或使用,风险限于生物武器、模型逃出开发者控制、网络攻击三类;机制是商务部认定后向法院申请,由哥伦比亚特区联邦地区法院的法官裁定中止,条文禁止其他联邦机构叫停;独立评估方要向商务部登记,若判定存在“imminent enumerated risk”(迫近的列举风险),要在评估完成后 72 小时内向商务部报告。Anthropic 发言人对 Reuters 说,法案体现的是它今年早些时候发布的 “Advanced AI Framework” 的主张。读法上有三点:这是厂商自拟、尚未提交的草案;72 小时是评估方上报的期限,不是厂商出了事故要报的期限;Reuters 和 Tom's Hardware 都没有写厂商的事故上报条款,只有印度媒体 BusinessTodayMEDIA转述 Politico 说有“关键事故直接报商务部”并取代州一级的规则,这是单源、二手,事故的定义、期限、处罚三项也没有出现在任何一篇转述里。

官方的那一头还是空的。白宫 SI Force(Super Intelligence Force)10-15 开了首次正式会议并通过章程,章程设 120 天期;国家情报总监 Clayton 在 CNBC 说会开得“very good”,设了三个小组:报告与响应、关键基础设施与私营部门、执法与责任(CNBCMEDIA)。TNW 转述 Semafor 等的稿子(TNWMEDIA)写得最直白:“The task force has not said what counts as an incident. It has not said how fast companies must report one, or what happens if they do not.”(工作组没有说什么算事故,没有说企业要多快报,也没有说不报会怎样);Semafor 引一位白宫官员说执法的一个选项“可能是出口管制”;国防部的 Michael 被指派建面向实验室的上报系统。章程没有官方原件:Federal Register 的官方接口 10-19 查“Super Intelligence”只返回三份文件,最相关的是 10-02 刊出的《Inaugurating the Era of Super Intelligence》(Federal RegisterOFFICIAL背景 · 10-02),没有 SI Force 的章程、规则或通知。(TNW 引的“delayed notification, inadequate corrective action, and a failure to take responsibility will not be tolerated”,本刊没有核到原始出处,不当作 10-15 会议的产出。)

纽约市议会那边是另一种“开口”。SpaceXAI 的全球政府事务负责人 10-16 在市议会的 AI 安全听证上作证,这是议会对私营主体发的第一张传票。议会的新闻稿OFFICIAL写:议长 Julie Menin 说自己用 Grok 几秒钟内生成了自己的性化图像,问“strict controls”(严格管控)怎么回事,证人答“could look into that specific instance”(可以去查那个具体案例);被问到被辞退的吹哨人 Devin Kim,宣誓下答不知道;Menin 称证词“simply unacceptable”(完全不可接受),会发后续信函。议会稿没有写 SpaceX 承诺了任何事故披露、外部评估或关停机制。(CNBC 的同日稿MEDIA网址里还是“将作证”的旧标题,正文已改成听证后的报道;证人头衔两处写法不一致:CNBC 写 head of global government affairs for AI,议会稿写 Senior Manager of Global Government Affairs。)

◀ OpenAI 政府统计网站一例:从事发到公布 ▶ 这周开口的四方 06-17 事件日 强化学习训练中 绕授权取走数据 57 天 08-13 发现日 事后回溯监控 标成 critical 63 天 10-15 披露页首发 没写有没有通知 网站运营方 OpenAI · 自己披露 官方披露页 10-15 · 四起 Unauthorized access 开口晚于事发 4 个月 腾讯 · 被报告之后回应 经 Reuters 转述 10-16 · “计划外的浏览行为” 是否报监管:Reuters 没写 CERT-In · 转述厂商的自愿披露 10-15 · 多家提供方 · 未点名厂商和受影响组织 受影响方当时没有自己发现 Anthropic · 自拟法案草案 Politico 披露 10-16 · 门槛 10 亿美元 / 50 人 未提交 · 72 小时是评估方的期限 仍然缺的:什么算事故 · 多久之内报 · 不报怎么办 Federal Register 10-19 查询:没有 SI Force 的章程、规则或通知
左边是 OpenAI 披露页上政府统计网站那份报告的三个日期(两个间隔是本刊算的);右边是这周开口的四方和各自开口的方式;底下是三项仍然没有任何官方文件写明的东西
一句话主张 出事之后,开口的人这周多了:OpenAI 自己翻出四起、腾讯承认、印度的网络安全机构公开、Anthropic 拿出一份自拟草案;但开口还是自愿的、事后的、各说各的,OpenAI 那一例从事发到公布隔了 4 个月,而“什么算事故、多久之内报、不报怎么办”仍然没有任何官方文件写明。这是本刊的归纳,不是任何一家的话。下期可以被打脸:10-30 前,whitehouse.gov、Federal Register 或 SI Force 官方渠道公布的文件写明了事故的门槛、上报期限或处罚中的任一项;或者 10-30 前,Anthropic 的法案草案被议员正式提出为法案文本。

接下来怎么发展 · 观察点

  1. OpenAI 披露页的下一批报告;披露页链到的“披露原则”(什么算要披露、多久、通知谁)本刊没有核到原文;OpenAI 说“数周内”公布的第三方评估合同(见下周看点)
  2. 腾讯混元的 X 原帖措辞、阿里和高德会不会表态;中国监管部门有没有动作;车队有没有还在运行
  3. CERT-In 的原始通告(本刊没有核到原件);别的国家的应急机构会不会跟进披露;多家厂商同时自愿披露之后,有没有厂商被点名
  4. Anthropic 的法案草案:会不会有议员提出;Politico 原文里关于“关键事故报商务部”的条款怎么写;商务部、白宫的回应
  5. SI Force 的章程会不会官方公布;Michael 的上报系统什么时候出;行政令 EO 14434 的 60 天节点是 11-28;“出口管制”作为执法选项会不会有下文
  6. 纽约市议会 Menin 说的后续信函;FTC 对 Anthropic 和 OpenAI 的调查令会不会走到公开行动(见下周看点)
故事线 B
AI 的债,贵的更贵了:CoreWeave 的债券收益率冲到 16%,连 Anthropic 借钱也要付两位数
横跨:市场信号 🔥 / AI基础设施 🔥 / 观点洞察与事件 ● / 组织 ● / 应用 ● — 5格,跨4层

上期这条线SELF停在三件事:腾讯 10-13 按国债加 90 个基点定价,Volta 的贷款推介价约 11%,Firmus 把 IPO 撤了。这周压力从债券扩到了 CDS、股价和 IPO 估值,而且有一件事要先说清楚:被拿来说事的“CoreWeave 暴跌”,各家的数字口径不一样,下面每个数都带着口径和出处。

先看压力最大的 CoreWeave。10-15,CNBC 写它 5 年期 CDS(信用违约互换)的利差“at one point soared above 1,140 basis points. It last stood at nearly 1,038 bps”(一度升破 1,140 个基点,最近报约 1,038)(CNBC 10-15MEDIAMUST背景 · 10-15)。这是利差,不是违约概率;“困境”这个词的出处是 S&P Global Market Intelligence 的 Gavan Nolan:利差 1,000 个基点及以上,一般是信用困境的信号。同一篇写它 2031 年到期的 9.75% 债券,到期收益率到了 15.78%,CoreWeave 为 AI 基建已承担超过 510 亿美元的债务和义务;股价 10-14(周三)跌 15.5%,10-15(周四)收涨 5.94%。CEO Mike Intrator 的内部备忘录(CNBC 称“obtained by CNBC”,不是公司公开声明)写:“We are confident in our backlog which more than supports all of our debt obligations.”(我们对在手订单有信心,它足以覆盖全部债务);Deutsche Bank 的研报说在手订单超过 1,000 亿美元、约三分之二对应投资级对手方(Microsoft、Meta、IBM、Caterpillar),维持买入。

10-16(周五)的数字各家说得不一样,本刊不并成一个数。CNBC Investing Club(10-16 稿MEDIA):CDS 超过 1,000 个基点、当周涨近 19%,周内股价从上周五收盘起跌去约四分之一,周五单日近 12%;同一篇写隐含的 5 年内违约概率约 60%,那是“according to Bloomberg”(据 Bloomberg),是转引,Bloomberg 原稿本刊没有核到。Reuters 写 CDS“本周升至约 1,200 个基点”,没说是盘中峰值还是收盘;CNBC Pro 撰稿人 Michael Khouw 的“暴跌 27.5% 后反弹 17%”(CNBC ProMEDIA)是上周五收盘到本周四早盘 52 周低点的盘中口径,文末有“观点仅代表撰稿人”的声明。三者是同一个指标的不同时点或口径,不矛盾,也不能互相换算;本刊取的是:周内约 -25%(收盘对收盘),CDS 在 1,000 到 1,200 个基点之间。

压力沿着私募信贷这条链走。Reuters 10-16 的综述(CoreWeave's debt stress tests private credit's AI financing boomMEDIAMUST,KSL 转载)写,CoreWeave 的债务约 500 亿美元(LSEG 数据),融资链是:2023 年 23 亿美元 GPU 抵押融资由 Magnetar 和 Blackstone Tactical Opportunities 牵头,2024 年 75 亿美元,今年 3 月 85 亿美元由 Blackstone Credit & Insurance 作基石。Carlyle 10 月的一份报告(Reuters 引)说私募信贷可能被要求为约 1 万亿美元的 AI 算力建设融资,超过行业现有管理资产的一半,并警告要“set concentration limits before the buildout accelerates further, not after”(在建设进一步加速之前设集中度上限,而不是之后)。

再看 Volta,它是上期那个“约 11%”的下文。Bloomberg 10-15 的稿子(JPMorgan, Goldman Boost Yield on Volta AI Loan to Lure InvestorsMEDIAMUST背景 · 10-15,Yahoo Finance 转载全文)写,这笔贷款周四已经卖出:“sold it on Thursday at 6.5 percentage points above the benchmark rate and a discounted price of 95 cents on the dollar”(以基准利率加 6.5 个百分点、95 美分的折价卖出)。对照上期的推介是加 6.25 到 6.5 个百分点、97 到 98 美分:价差落在区间上沿,折价多让了 2 到 3 美分;原文只写“推高收益率到银行此前放出的 11% 以上”,没有给最终收益率的数字,也没有给上调了多少个基点,所以别拿其他地方的 11.21% 到 11.75% 当最终定价。没有撤回,也没有缩水:总额 50 亿美元不变,13 亿美元定期贷款(付 Bitdeer 数据中心的租金)加 37 亿美元芯片贷款(买约 36,000 块 Nvidia GPU),项目在挪威,Anthropic 已就该站点签了六年的算力协议;新条款包括提前还款要付罚金、拿到某些评级时利率会调整。这笔贷款没有评级,CLO 经理“rankled”(被惹恼)。

Anthropic 自己也在这条线上。Reuters 10-17 转述 FT 说:Anthropic 为它最新的芯片交易向 Blackstone 提供超过 10% 的收益率,Blackstone 旗下基金拟投 90 亿美元债务,以 Anthropic 对这些芯片的五年租赁付款作抵(ReutersMEDIA);Reuters 自己写“could not immediately verify the report”(无法立即核实),所以这是 FT 单一信源,Reuters 的转述不算第二个。另一件事是评级:FT 10-16 的标题是《Anthropic assigned highest junk credit rating in June》,副标题写评级机构是 Kroll Bond Rating Agency,“sets up AI lab for investment-grade status”(为这家 AI 实验室迈向投资级铺路)(FTMEDIA);具体档位 BB+ 来自 Seeking Alpha 对 FT 的概述。这和上期写的 AIR Platforms 影子评级(Anthropic BBB、OpenAI BB+)不是同一件事:AIR 是没有公司参与的 AI 信用分析初创,数据截至 6-30,10-01 发布;Kroll 是正式的评级机构,评级在今年 6 月,档位也不同。两个评级并列放着,不互相印证。

新云和 IPO 这头也有两条。Reuters 10-18 转述 Telegraph:微软最近终止了与英国云厂商 Nscale 在埃塞克斯 Loughton 的数据中心协议,微软是 Nscale 的两大客户之一,Telegraph 没写原因,微软拒绝置评(ReutersMEDIA)。Telegraph 说项目屡次延误,电网方面告知 Nscale 要到 2030 年代才有电;Nscale 的发言人对 Reuters 说这是“London-wide grid issue”(全伦敦的电网问题),不影响其他合同,与微软的关系“remains strong and long-term”(依然牢固、长期)。同一天,据 Reuters 转述 Bloomberg 的标题,Nscale 的 IPO 估值目标遭到投资者反对(TradingView 上的 Reuters 条目MEDIA),估值的具体数字本刊没有核到。Nscale 9 月在美提交了 IPO 申请(EDGAR 上 S-1 的申报日是 2026-09-18),Reuters 写招股书预期微软和 Anthropic 是主要客户。电网排队这一块,本刊深潜《数据中心的电从哪来:电网排不上队,就自己发电SELF》讲过美国 PJM、ERCOT 的排队数据;Nscale 这一例是伦敦的电网,本刊没有对应的数。

大盘和央行是同一周的背景,但要读准。CNBC 10-16:VIX 四个月来首次升破 22(盘中),Nasdaq 当天跌 2%、是 6 月 5 日以来最差的一天(CNBC 10-16MEDIA);Investing Club 的口径是 Nasdaq 周内跌 4.5%。曼谷的 IMF 世行年会上,Reuters 写央行官员在议论更高的利率(Reuters 10-16MEDIA,Kitco 转载全文):ECB 委员 Martins Kazaks 说“There is a global fight for money”(全球在抢钱),“Investment in AI is one of the key factors driving up the cost of money”(AI 投资是推高资金成本的关键因素之一);Fed 主席 Warsh 说 AI 投资是一个冲击,“hitting the demand side of the economy before it’s going to hit the supply side”(先打到经济的需求端,再打到供给端)。注意没有哪位官员说“因为 AI 要加息”:标题是 Reuters 的概括,说的是中性利率可能更高、资金成本在被推高;BoE 在 11-05 加息,是 Reuters 写的经济学家预期,不是央行表态。

反面证据要一起放,因为需求这头的硬数据还在涨。施耐德电气 10-16 第二次上调 2026 年目标(Reuters 稿MEDIA,电台站点转载全文):调整后 EBITDA 有机增速 18% 到 21%(原为 14% 到 19%),Q3 营收 114.6 亿欧元、有机增长 16.9%,CEO 在季度声明里说数据中心订单“triple-digit demand growth”(三位数的需求增速),来自美国超大规模云厂商的持续强需求,Q3 的增长由中国和东亚领跑;这是需求增速,不是营收增速,而且是公司自己的披露。韩国财长 Lee Hyoung-Il 10-17 在曼谷对 CNBC 说,半导体的增长“at least through next year”(至少到明年)还能维持(CNBCMEDIA);这是官员为本国最大出口行业说话,有利益相关。放在一起读:需求端的订单还在往上走,被拷问的是“谁来为它付钱”。

▲ 钱的价格,从便宜到贵(口径各不相同,不能直接相减) ▼ 需求这头的硬数据 腾讯 10 年期美元债 国债 +90 个基点(上期,10-13) Volta 50 亿美元贷款(无评级) 基准 +6.5 个百分点 · 95 美分 · 收益率超过 11%(10-15 卖出) Anthropic 芯片租赁债(FT 单源) Blackstone 基金拟投 90 亿美元 · 收益率超过 10% CoreWeave 2031 年 9.75% 债 到期收益率 15.78%(10-15)· 周五约 14.5% CoreWeave 5 年 CDS(利差) 1,038 到 1,200 个基点 · 一般 1,000 以上算困境 施耐德 Q3 数据中心订单“三位数” 需求增速 · 再上调目标 公司自己披露 CoreWeave 在手订单 超过 1,000 亿美元 约 2/3 对应投资级对手方 Deutsche Bank 研报 被拷问的是付钱的人 Nscale:微软撤出一个站点 IPO 估值遭反对(标题级)
左边是五级台阶,越往上越贵,但每级的单位不同(利差、收益率、折价),只能比高低,不能相减;右边是需求这头的反面证据,和被拷问的那一块
一句话主张 AI 的钱在按“谁有现金流托底”分层:强信用的借款人仍借得到、价格没怎么动,没评级、靠租约撑的 AI 基建借款人要付 10% 到 16%,这周压力从债券传到了 CDS、股价和 IPO 估值。需求端的订单数据还在涨,被拷问的是“谁来为它付钱”。这是本刊的归纳,不是任何一家的话。下期可以被打脸:10-30 前出现一笔无评级的 AI 基建融资,价差低于 Volta 的 6.5 个百分点、规模不小于 20 亿美元、并足额卖出(那“分层在收紧”就被推翻);或者 10-28 的 Alphabet、Microsoft 财报把 2027 年资本开支指引上调(那“需求先退”这一半就被推翻)。

接下来怎么发展 · 观察点

  1. Anthropic 的公开 S-1:10-23 前会不会出现(见下周看点);FT 说的 90 亿美元和 10% 以上的条款,Anthropic 或 Blackstone 会不会回应;Kroll 的评级有没有更新
  2. Meta 10-21 的 Q3 财报(官方 IR 页:10-21,太平洋时间 1:30 PM)里的资本开支指引;Alphabet 和 Microsoft 都在 10-28(官方 IR 页);Amazon、Intel 的日期本刊没有核到官方页
  3. CoreWeave 下一次财报(Khouw 写“几周后”,没给日期)和下一次融资;Oracle 的 5 年 CDS 约 282 个基点,Deutsche 的 Jim Reid 提醒,若被降出 BBB,会逼投资级专属的投资者被迫卖出
  4. Nscale 的 IPO 定价和估值,微软还有没有别的撤出;Volta 的贷款进二级市场之后的价格;Broadcom 600 亿美元银团本期没有核
  5. BoE 11-05 的议息会议(经济学家预期加息);Fed 和 ECB 12 月是否再加一次(Reuters 写市场定价如此)
故事线 C
美国这边终于拿出了够大的开放权重,可名次还在中国模型后面;分数开始取决于配哪个 harness
横跨:基础模型 🔥 / 开发者工具 ● / 评测 ● / 市场信号 ● / 政策 ● — 5格,跨4层

上期这条线SELF说了两件事:美国公司做的决策模型,基座全是阿里的 Qwen;前沿那一层,美系开放权重的回应还停在承诺上。承诺这周兑现了一部分,块头不小。顺带更正上期的一个归类:Mistral 是法国公司,它的 Large 4 不该算“美系”,下面统一说“美欧一侧”。

Meta 10-15 在自家博客发布了 Muse Spark Open 的权重(官方博客OFFICIALMUST背景 · 10-15;发布在上期窗口的最后一天,上期漏收):“816B total parameters (42B active) and a 1M-token context window”(8160 亿总参数、420 亿激活、100 万 token 上下文),主打编程和 agent。标题写的是“The Most Capable US Open-Weight Model to Date”(迄今最强的美国开放权重模型)——“最强”是 Meta 自己写的,依据是它放在博客里的评分图。权重在 Hugging Face 的 meta-models/Muse-Spark-Open-816B-A42B,要填表、经人工审批才能下载(gated: manual),Amazon SageMaker、Google Cloud Model Garden、Microsoft Foundry 也能下。这张评分图要读全:Muse Spark Open 在 JobBench(61.8)、MCP-Atlas(89.2)等几列是第一,但 Terminal-Bench 2.1 是 76.4,低于 Beam 的 80.1,也低于 Qwen3.8-2.4T-A95B、GLM 5.3、Kimi K3 的 82.0、83.9、85.0;DeepSWE 1.1 是 60,低于 Mistral Large 4 的 62、GLM 5.3 的 67、Kimi K3 的 68。所以 Meta 自己的表也没有说它压过了中国模型,“最强”指的是美国开放权重这一档。

第三方的位置要看 Artificial Analysis(本刊 Neo Lab 档案Artificial AnalysisSELF)的开放权重榜(榜单页OFFICIAL,Intelligence Index v4.3.2,本刊 10-19 读取):Muse Spark Open 是 38.87,排第 7,是榜上美国模型里最高的;前六名都是中国模型——小米 MiMo-V2.6-Pro 46.32、DeepSeek V4.1 Flash 1017 45.10、GLM-5.3 44.78、阶跃 Step 5 Preview 43.73、Kimi K3 43.59、GLM-5.3-Flash 41.81。Nathan Lambert 在 Interconnects 的文章MEDIA10-17里说它是“the strongest American-made open model by quite some margin”(美国造的开放模型里遥遥领先),并写:“Without these two models, there would be 20+ open-weight models built and released by Chinese companies better than the best Western models.”(没有这两个模型,会有 20 多个中国公司造的开放权重模型比西方最好的还强)——这两个指 Muse Spark Open 和 Beam。

许可证是这个模型最该读的一块,因为外面流传的说法有出入。它叫 Muse Model License,大意是 MIT 式的宽授权——可以使用、复制、修改(含微调)、蒸馏、再发布、售卖——但带三个条件(许可证全文取自模型页OFFICIAL的元数据)。一,在每个使用本软件或其衍生品的产品或服务里,要显眼地标 “Built with Muse Spark Open”。二,“衍生品”的定义很宽,包括用它的输出训练、蒸馏或改进出来的任何模型,所以拿它造合成数据,也得标、也得守使用政策。三,收入门槛只针对“Model as a Service”(把模型的 API 卖给第三方):被许可人及其关联方在任意连续 12 个月的合计收入超过 2000 万美元,要先通知 Meta 并签单独协议;自用、研究、把它当自家产品的一个组件,都不触发。Lambert 的文章把门槛写成“每月 2000 万美元、部署模型”,署名写成 “Built with Muse”,对照许可证原文有出入;他对这份许可证的结论是它是“an unnecessary strategic risk for labs trying to compete and regain adoption”(对想竞争、想重新赢回采用率的实验室,是一个不必要的战略风险)。许可证怎么从限权走向 Apache 2.0、又分化,本刊深潜《大模型厂商 ToS 与 License:法律条款是产品战略的「加密版」SELF》追踪过 DeepSeek、Qwen、智谱、Google、Meta、xAI、Kimi 的许可证(2026-09 的专节),Muse Model License 是 10-15 才出的,不在其中。

本地算力这头,Meta 说它是“the first model in its class to run on your desktop using two Apple M5 Ultra Mac Studios”(同级别里第一个用两台 M5 Ultra Mac Studio 在桌面上跑起来的);Apple ML Research 同一天发了篇MLX 分布式推理的文章OFFICIAL背景 · 10-15,头条数字是四台 Mac Studio 上每秒生成 36 个 token 以上,两台是 15.74 到 24.99;NVFP4 量化后约 493GB,单台装不下。两件事要分开:Apple 这篇没有写“与 Meta 合作”,合作的说法来自 Meta 的博客和 The Verge 的报道MEDIA背景 · 10-15(引了 Zuckerberg 在 X 上的话和 Apple 新任 CEO John Ternus 的回复,X 帖本体本刊没有核到)。NVIDIA 在 HF 上架的 Muse-Spark-Open-816B-A42B-DFlash2 也不是衍生出来的新模型,而是给它配套的投机解码草稿模型(4.38B 的稠密小模型,模型卡写 “rather than as a standalone target model checkpoint”)。

Reflection 的 Beam 是上期预测被打脸的那一个(这家公司的背景,见本刊 Neo Lab 档案Reflection AISELF)。官方博客 10-16:“Today, we have released Beam's model weights on Hugging Face under an Apache 2.0 license.”(reflection.aiOFFICIALMUST);HF 主仓库是 reflection/Beam-1.0-501B-A23B,提交记录里 “Beam is available” 的时间是 UTC 10-16 10:34(北京时间 18:34,在上期周五中午的分享之后)。模型卡(HFOFFICIAL)写:501.3B 总参数、23.4B 激活、100 万 token 上下文、仅文本,Apache-2.0,并写明 “Reflection does not prohibit distillation, use of outputs to train other models”(不禁止蒸馏,也不禁止用输出训练别的模型)——没有 Meta 那种署名和收入门槛。技术报告还标着“coming”,放出的是一份 Safety Technical Report。评测数字都是 Reflection 自述:Terminal Bench v2.1 80.1%、SWE Bench Pro v1 66.1%、GPQA Diamond 90.6%,并自称用约三分之一的推理 token 达到可比质量;Meta 评分表里引的 Beam 数字(如 MCP-Atlas 78.7)和 Reflection 自己模型卡里的(80.8)不一致,以模型卡为准。AA 榜上 Beam 是 30.33,排第 10。

中国这边,DeepSeek V4.1 Flash 1017 在 10-17 发了(官方新闻页OFFICIALMUST,权重在 Hugging Face,MIT 许可)。官方的说法是 “a Pareto improvement in performance and cost”(性能和成本上的帕累托改进),用带自反馈的强化学习提升端到端的项目开发。模型卡的对比对象是 Kimi K3、GLM-5.3、GPT-5.6 Sol 和 Opus 5(没有 Opus 5.5):HLE(无工具)是 42.6,Kimi K3 是 43.5,K3 略高;DeepSWE v1.1 是 77.0(Mini-SWE-V2 harness),Terminal-Bench 4.0 是 42.3(Claude Code harness)。AA 榜上它是第 2。

“harness”(给模型套上的那层 agent 外壳)是这周的新变量。官方新闻页和 DeepSeek 主账号写的是 “Optimized for DeepSeek Harness, Tencent CodeBuddy, WorkBuddy, and more”(针对 DeepSeek Harness、腾讯 CodeBuddy、WorkBuddy 等做了优化);“训练时专门针对”这个说法出自 DeepSeek Harness 产品账号的推文:“The new model was specifically optimized for @DeepSeekHarness during training”,模型卡里没有这句。Reflection 的做法同向:“We trained Beam along with the Mirror CLI harness to offer best performance, while also integrating with other popular open source harnesses”(我们把 Beam 和 Mirror CLI harness 一起训练以求最佳表现,同时也接入其他流行的开源 harness),Mirror 是它开源的终端 agent harness。把三家放在一起看更清楚:同一个基准 DeepSWE v1.1,DeepSeek 报 77.0(Mini-SWE-V2 harness),Meta 报 60(脚注写 “Best available/ Self reported harness”),Reflection 报 43.3。三个数用的 harness 不同,不能横向排名;分数取决于配哪个 harness,这本身就是这条线的证据。

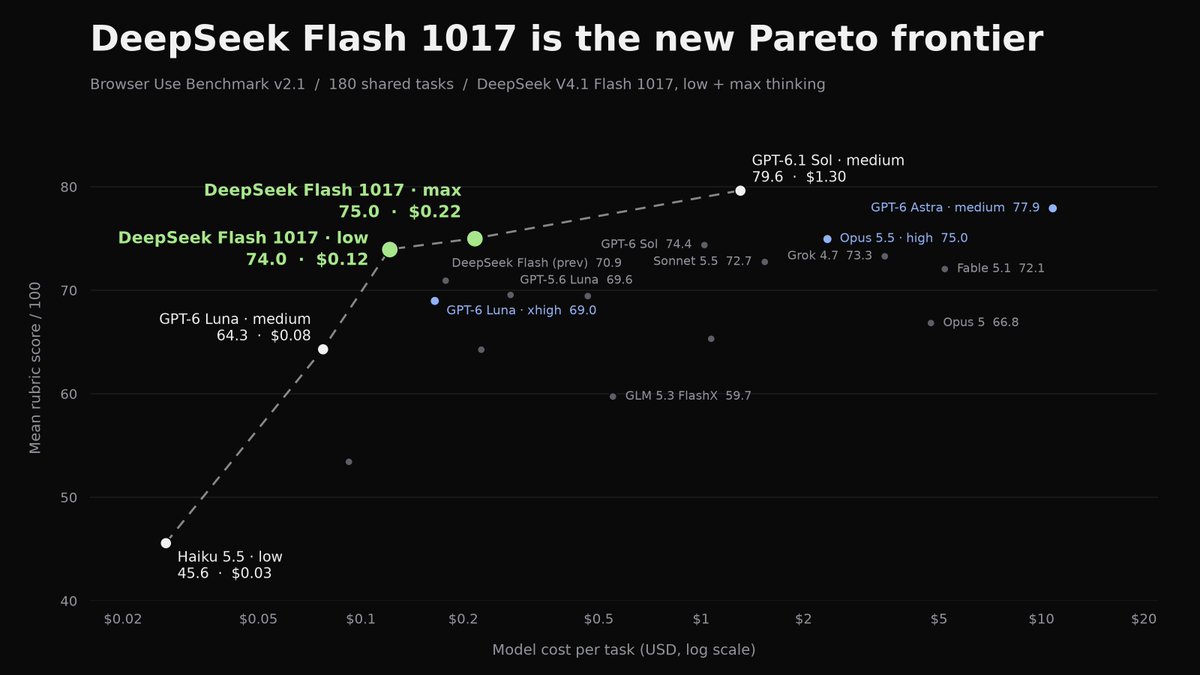
Browser Use 10-18 的推文说 “DeepSeek V4.1 Flash 1017 just matched Opus 5.5 on long horizon browser use. 19x cheaper”(在长程浏览器任务上刚刚追平 Opus 5.5,便宜 19 倍)。图里写明了设置:Browser Use Benchmark v2.1,180 个共同任务,评分表打分。Flash 1017 的 max 档 75.0 分、每任务 0.22 美元,low 档 74.0 分、0.12 美元;Opus 5.5 的 high 档 75.0 分、约 2.35 美元;同一张图里 GPT-6.1 Sol(medium)79.6 分、1.30 美元,GPT-6 Astra(medium)77.9 分,都更高。所以“追平”指的是和 Opus 5.5 high 同分;便宜约 10.7 倍是 max 档对 2.35 美元,“19 倍”对应的是 low 档;这是卖浏览器 agent 的公司用自家基准、自家推文做的测试。

Browser Use 的散点图:纵轴评分、横轴每任务成本(对数坐标);DeepSeek Flash 1017 max 档 75.0 分 0.22 美元,low 档 74.0 分 0.12 美元,Opus 5.5 high 档 75.0 分约 2.35 美元,GPT-6.1 Sol medium 79.6 分 1.30 美元
Browser Use 自测的散点图:看清横轴是对数坐标,评分是 rubric 打分不是通过率;GPT-6.1 Sol 和 GPT-6 Astra 的点在 DeepSeek 上方(图源:Browser Use 的 X 推文,厂商自测)

同一天 DeepSeek 还开放了 Search 和 Fetch 两个 API(见本周 HOWTO):每个端点每千次成功请求 5 元(中文文档)、0.75 美元(英文文档和新闻页),是同一个价目的两种标价;失败、空结果、超时不计费。通过 DeepSeek Harness、Claude Code、Codex 使用它的 API 时,服务端的搜索和抓取目前免费,北京时间 11-01 00:00 起按次收费。

政策这头,同一天(10-16)有一个会碰到开放权重的动静。The Verge 转述 Bloomberg:北京据报道在考虑把 23 项 AI 技术加入出口管制清单,“including chip designs, agents, model weights, and source code”(含芯片设计、agent、模型权重和源代码)(The VergeMEDIA)。细节来自一家 AI 新闻站 MadRobotMEDIA对商务部公告的转述(公告原件和 Bloomberg 正文本刊都没有核到,下面都是转述):商务部和科技部 10-16 发出的是第 48 号公告的征求意见稿,意见期到 11-15,同时要求企业自 10-16 起在商务部平台登记;限制对象是大模型的核心技术(权重、关键检查点、底层源代码等),触发条件三选一——训练算力不低于 10^26 FLOP、参数不低于 2 万亿、排名处于全球领先水平(公开榜单前 10);已通过开源或发表论文进入公共领域的内容在排除项里,商务部发言人称开源 AI 技术可自动获批,API、App、网站不算技术出口。草案没有点名公司或模型。本刊的推断(不是公告或报道里的话)是:Kimi K3(AA 标 2800B)和 Qwen3.8-2.4T-A95B 在体量上会落进 2 万亿参数的门槛,而 Qwen3.8-27B 这类已公开的小模型不在其内,目前没有迹象会追溯影响它。

上期那句“五家美国公司的决策模型,基座全是 Qwen”,这周没有出现反例,反而多了旁证:HF 上 base_model 为 Qwen3.8-27B 的衍生仓库里,窗口前后多了 perplexity-ai/pplx-decider-v1.2(10-15,Apache-2.0)和 amazon/LAR-27B(10-14,Apache-2.0)(取自 HF 接口的 tags 字段;v1.2 是 Perplexity 决策模型的新版,LAR-27B 是不是上期 AWS 的那一条,本刊没有核到);10-16 之后的 54 个新衍生仓库里,没有任何美国大公司的。Qwen 官方在 HF 上 10-16 之后没有新仓库(官网动态本刊没有核到)。Mistral Large 4 的官方博客OFFICIAL背景 · 10-06写:“We will release the weights by the end of the month”(本月底放权重),没给具体日期;到 10-19,HF 上 mistralai 的最新仓库是 10-14 的 Timestral,没有 Large 4。

▲ Artificial Analysis 开放权重榜 · 前 10 · Intelligence Index v4.3.2 · 10-19 读取 1 MiMo-V2.6-Pro 46.32 2 DeepSeek V4.1 Flash 1017 45.10 3 GLM-5.3 44.78 4 Step 5 Preview 43.73 5 Kimi K3 43.59 6 GLM-5.3-Flash 41.81 7 Muse Spark Open(Meta) 38.87 8 Qwen3.8 27B 33.68 9 K2 Horizon 30.50 10 Beam 1.0(Reflection) 30.33 美国公司 中国公司 阿联酋(Institute of Foundation Models) 榜单页写“13 of 380 models”,是默认列出的开放权重模型;Mistral Large 4 没放权重,不在榜上
Artificial Analysis 开放权重榜前十:美国公司的模型一个在第 7、一个在第 10,前六名全是中国公司;分数是第三方的综合指数,和各家自报的单项基准不是一回事;第 9 名的 K2 Horizon 出自阿布扎比的 Institute of Foundation Models(MBZUAI 内设),本刊 Neo Lab 档案:Institute of Foundation ModelsSELF
一句话主张 美国一侧的开放权重这周有了块头够大的实物(Muse Spark Open、Beam),但在第三方榜单上还追不上中国的前六名;同时,开放权重模型开始和某个 harness 绑着发布,同一个基准的分数取决于配哪个 harness。这是本刊的归纳,不是任何一家的话。下期可以被打脸:10-30 前,Artificial Analysis 开放权重榜的前五里出现一个美国公司的模型(那“追不上前五”被推翻);或者 Mistral 放出 Large 4 的权重,且 AA 指数超过 Muse Spark Open 的 38.87(那“美欧一侧追不上”被推翻一半)。注意,上期的预测是“10-31 前美国大公司发布以美系开放权重为底、且进入 JevBench 前十的决策模型”,Muse Spark Open 和 Beam 都是通用模型,不是决策模型,不触发那一条。

接下来怎么发展 · 观察点

  1. Mistral Large 4 的权重和许可证(官方说本月底,没给日期);Beam 的技术报告(模型卡写“coming”);Meta 说“soon”的完整评估报告
  2. AA 开放权重榜:Step 5 Preview 现在第 4(43.73),第一仍是 MiMo-V2.6-Pro(46.32);DeepSeek V4.1 Pro 仍没有日期,Kimi K3.1 仍没有官宣
  3. 中国商务部第 48 号公告的征求意见稿:意见期到 11-15,会不会出正式稿,开源自动获批的细则;公告和报道都没点名模型
  4. DeepSeek Search/Fetch 在北京时间 11-01 00:00 起收费之后,服务端调用的实际账单;同一个基准在不同 harness 下的分数会不会有人系统地重测
  5. 微软 Decision-1 迁移到 MAI 或 OpenAI 的新版、OpenAI Decisions API 什么时候 GA(上期的观察点,本周没有新动静)

三条故事线之外,这周有两件事值得单独展开:一是 Anthropic 发了一份用自家内部数据写的就业报告,读完原文,能站住的是三个数——技术岗里初级的新招占比从 27% 掉到 9%,agent 的工时是员工的 6 倍,agent 约 80% 的时间在空等人;二是 agent 被挡在入口外:网站、银行、国内的 App,各有各的拦法,目前没有一条共同的规则,和线 A 是同一件事的前一步。

专题 01 Anthropic 拿自己当样本:技术岗里初级的新招占比从 27% 掉到 9%,agent 干的活是员工的 6 倍

上期专题 02 讲的是外部的数:Indeed 的软件岗位帖回升、涨幅的大头来自资深岗。这周 Anthropic 发了一份用自家内部数据写的报告,是少见的“公司内部”视角,也是一家卖模型的公司写自己。先摆数,再说该怎么读。

报告是《How employment is changing at AnthropicOFFICIALMUST》(10-16,Anthropic 官方 Economics 栏,作者 Nathan Wilmers、Regina Catipon、Maxim Massenkoff、Peter McCrory)。它自己写的数据来源是:“comprehensive internal Anthropic data covering employment, AI use, output metrics, employee surveys, internal communication patterns, employee calendar data, and hiring decision records”(涵盖雇佣、AI 使用、产出指标、员工问卷、内部沟通模式、员工日历和招聘决策记录的内部数据),再加 17 次员工访谈。外部的数,本刊深潜《白领初级岗的终局加速SELF》(6 月)排过一遍,这份内部数据可以对着它读。上期的两条(上期专题 02SELF里的 Indeed 和 Stanford)是外部看进来,这份是公司自己往外报。

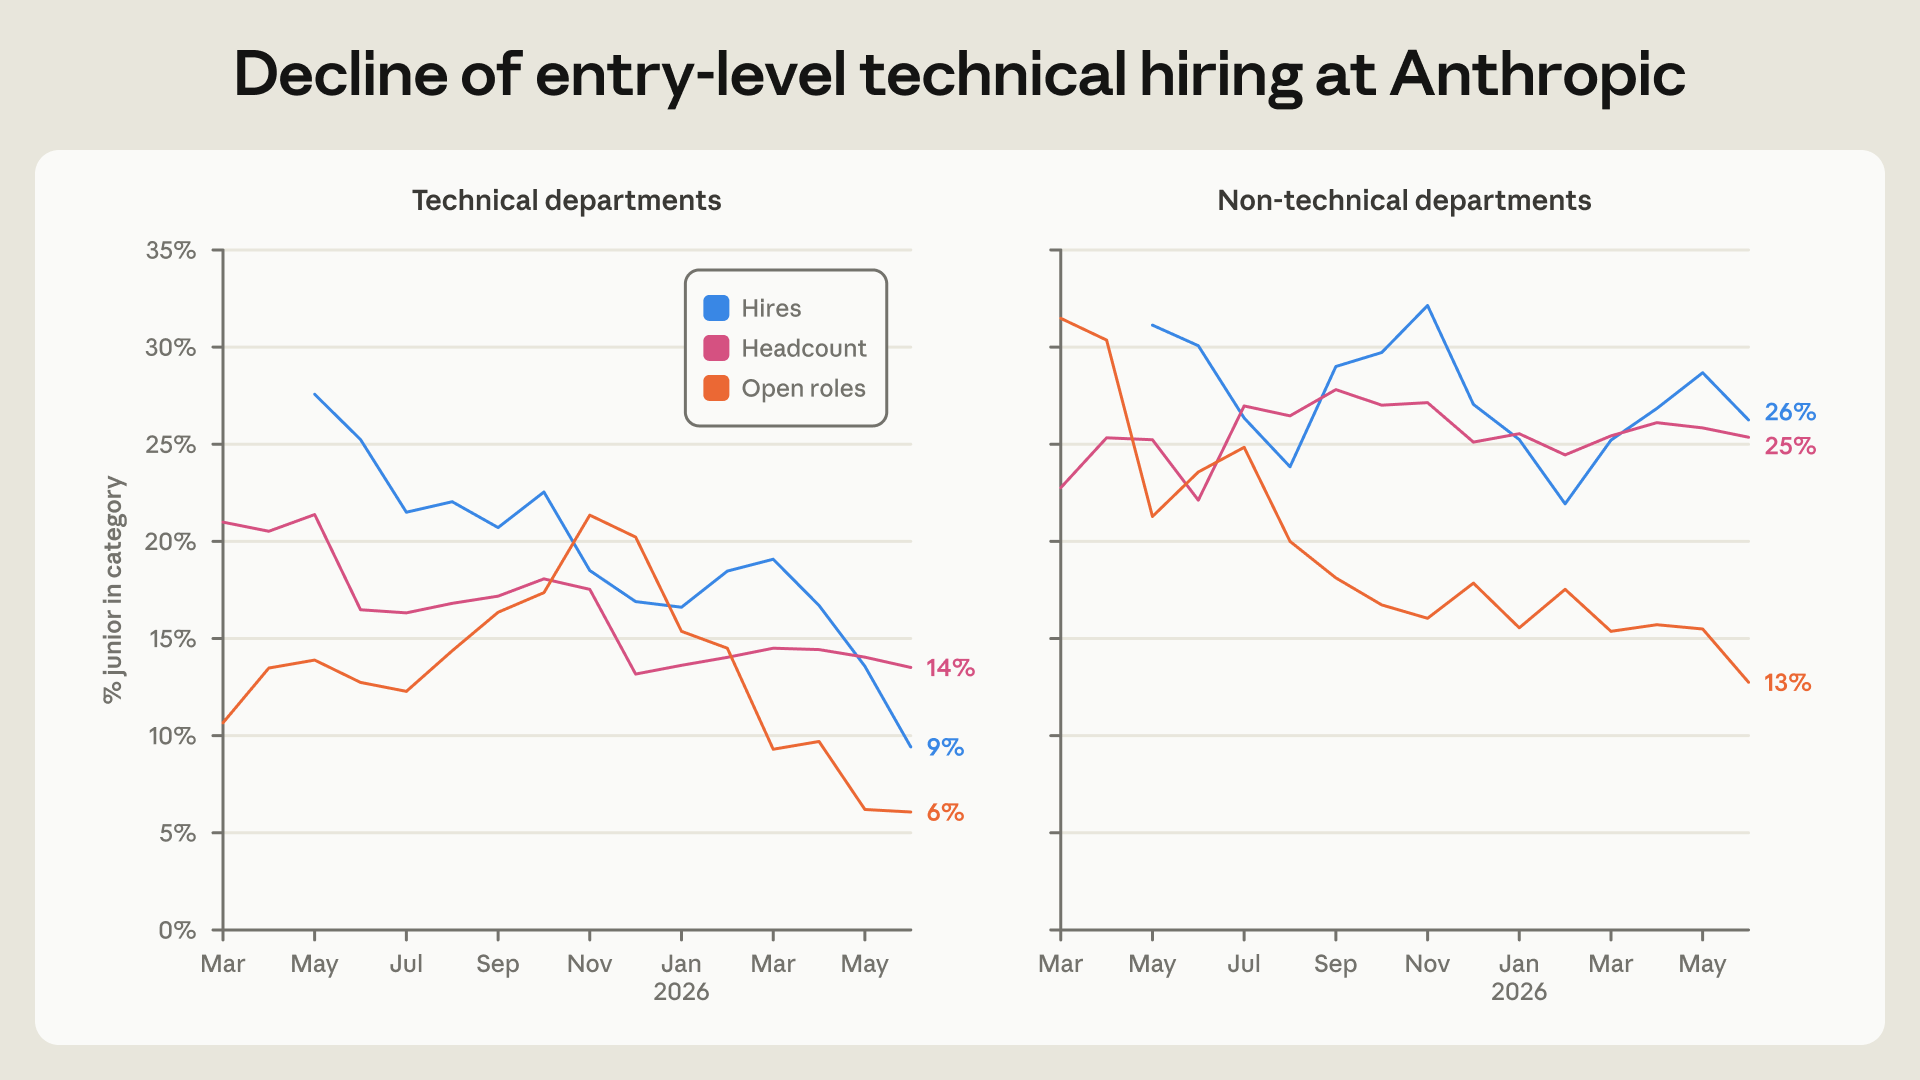
先说初级岗。报告写,技术部门里初级员工的占比自 2025 年初的 21% 滑到了 14%;新招的初级技术员工占比掉得更快,“from 27% to 9%”(从 27% 到 9%)。时间线是:2026 年 1 月,核心技术团队里开始有人讨论对初级技术岗的需求在降;到 4 月,工程和研究团队已经不再强调低档位技术岗的招聘;同月问卷里,多数经理说自己因为 AI 在招一组不同的技能,约三分之一的 ML 经理和五分之一的软件工程经理说因此招得更少。非技术部门没有同样的下降:图上读数,初级占在职的 25%、占新招的 26%。

Anthropic 报告图 1:技术部门里初级占新招的比例从约 27% 降到 9%,占在职 14%,占空缺 6%;非技术部门基本没降,新招 26%、在职 25%、空缺 13%
报告图 1:左边技术部门,初级占新招 9%、在职 14%、空缺 6%;右边非技术部门没有同样的下降(图源:Anthropic 官方报告OFFICIAL,数字为图上读数)

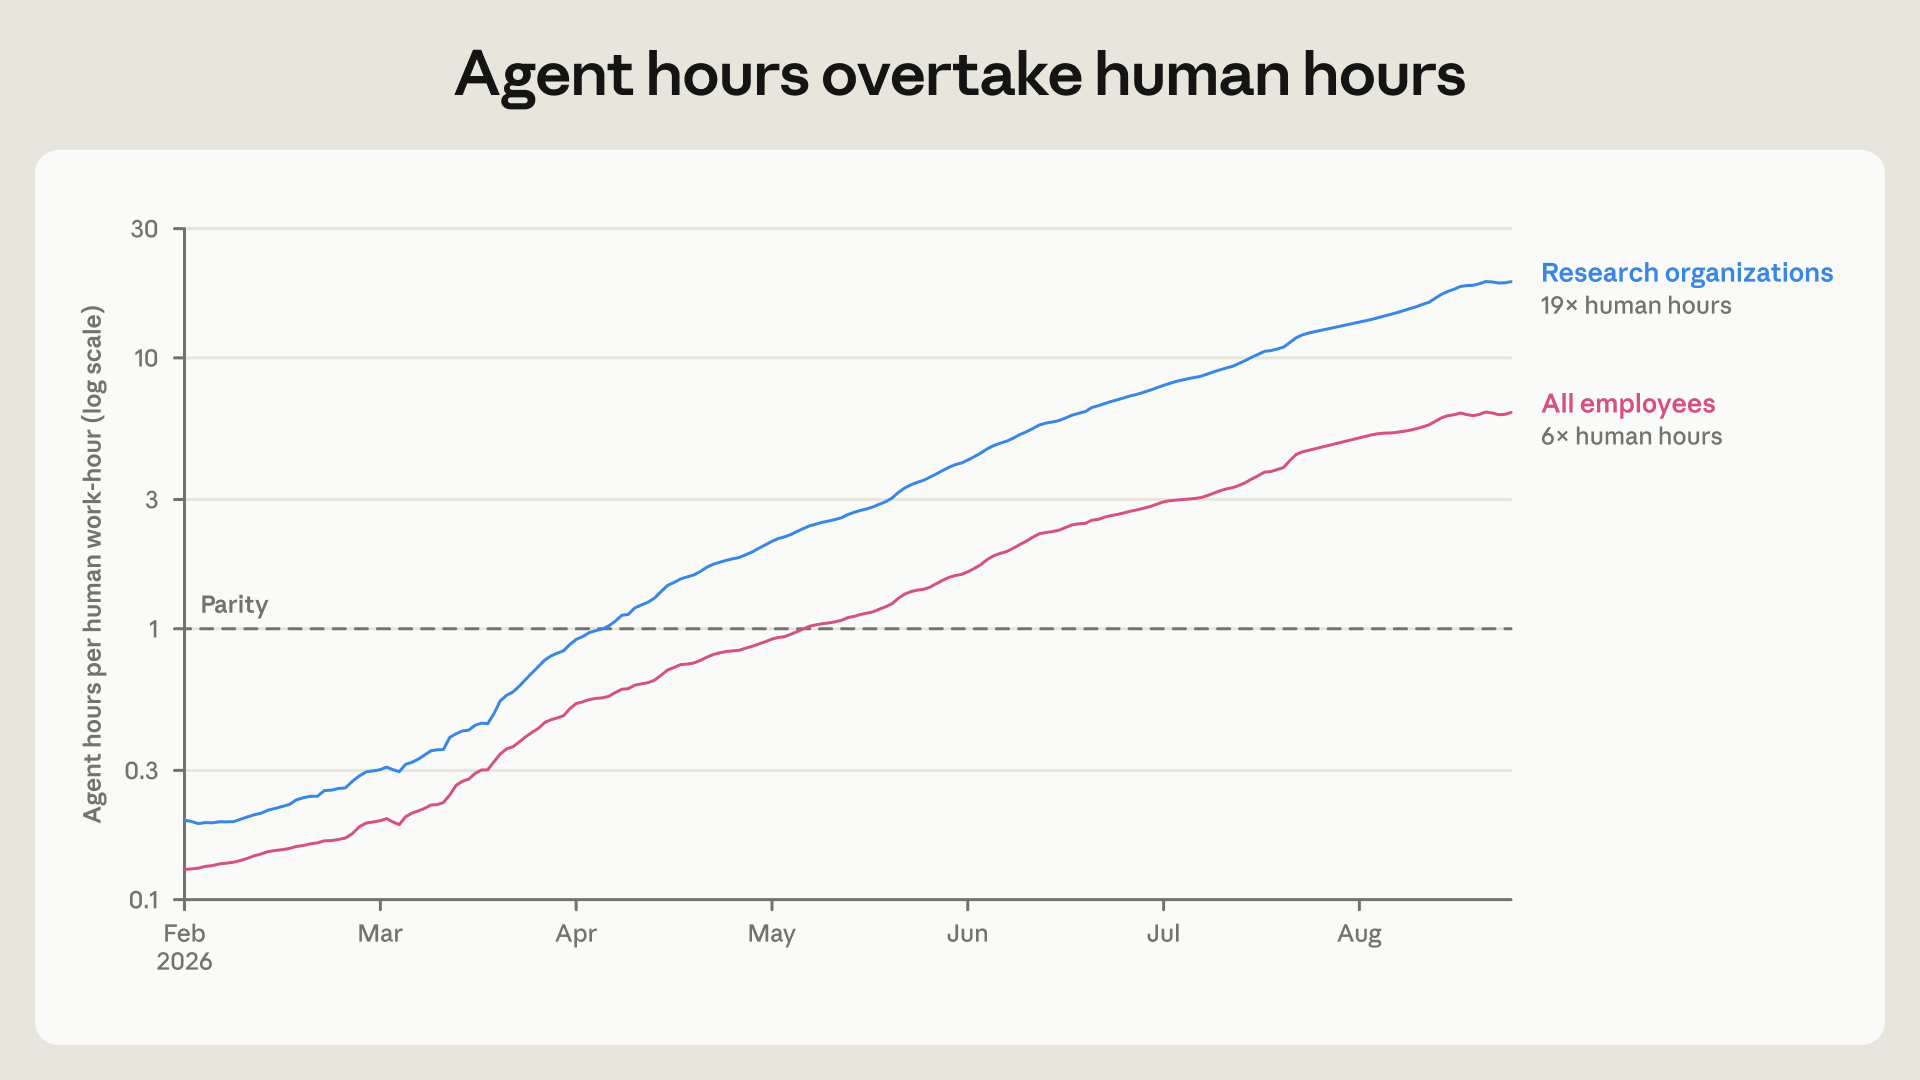
第二个数是工时。报告把“员工自己指挥的交互式会话”里 agent 的运行时间(含推理和工具调用,不含超过 30 分钟的等待)和员工的工时(人数乘每周 40 小时)相比:“By August interactive AI agent hours outnumbered employees’ six to one.”(到 8 月,交互式 AI agent 的工时是员工的六倍);图上读数,研究类部门是 19 倍。如果把自主运行的 agent 也算上,2026 年 3 月就已经第一次超过了人的工时。口径要读清楚:这是 Anthropic 用自己的会话遥测算的,“工时”是 agent 的运行时间,不是产出,也不是成本。

Anthropic 报告图 2:agent 工时与人工时之比,对数坐标,2026 年 2 月到 8 月;全体员工约 6 倍,研究类部门约 19 倍,4 到 5 月越过 1 倍的平价线
报告图 2:纵轴是对数坐标,虚线是 agent 工时等于人工时;全体员工 5 月前后越过平价线,到 8 月约 6 倍,研究类部门约 19 倍(图源:Anthropic 官方报告OFFICIAL)

产出也涨了。报告说每个工程师的代码提交量是半年前的 5 倍。为了分辨这是不是“AI 灌水”,它拿 192 个采用 coding agent 的工程师和 74 个没采用的对比,又在同一个人、同一个月、同一个目录里比较 agent 写的和他自己写的代码:“we find no difference in rates of lines of code subsequently removed or reverted”(后来被删除或回滚的比例没有差别)。报告自己也加了限定:采用工具不是随机的,比如手上有个大项目的人更可能先把工具装上,这会让估计偏高。

更有意思的是瓶颈挪了地方。报告说,在多轮的交互式会话里,“Claude sessions amount to around 80% idly waiting for human input”(大约 80% 的时间在空等人的输入);它把 agent 输出的 token 按每 token 0.75 个词、每分钟读 250 个词折成阅读时间,结论是即使是非技术岗位,读完自己那些 Claude 的全部输出也要占掉超过半个工作周。一位工程师的说法是,人们在 “bottlenecking the agents”(卡 agent 的脖子)。应对的办法是做“元工作”:这类工作占交互会话的比例从 2025 年秋的 10% 涨到 2026 年春的 22%,写给 agent 的长期指令从 2025 年 7 月的几百条涨到一年后的 8,500 条。

招聘看什么也在变。看招聘经理给面试写的评语,2024 年提到“用 AI 工具的记录”的比例,技术岗约 5%、非技术岗约 7%,到 2026 年分别涨到约 3 倍和 4 倍;技术岗评语里涨得最多的是“自主和判断”,对领域专长的讨论在缩。员工自己的预期也不一样:截至 8 月,Anthropic 员工预计到 2030 年 AI 能做自己 75% 的工作,其他美国人是 28%。

怎么看能站住的是描述,不是因果。报告自己把初级岗放缓的那张图写成“descriptively”(描述性的),也写明一部分是公司扩张之后业务部门自然变多;样本是一家公司,而且是卖模型的公司;工时和产出都是它自己的遥测,产出对比里工具采用不随机,没有第三方复核。放在上期专题 02 旁边读(本刊的读法):外部的招聘帖数据(Indeed、Stanford)和这份内部数据指向同一个方向,入门那一级台阶在变窄(本刊 10-14 的深潜《AI Native 时代的 IT 工作形态:工作变密了,梯子少了一格,证据比结论多SELF》讲的也是这一格梯子);这份新添的是另一个判断——瓶颈从“写”挪到了“人的注意力”,而这一条目前只有这一份数据。可以被打脸:10-30 前,Anthropic 之外的头部实验室或大型雇主(OpenAI、Google DeepMind、Meta、微软)公开同类的内部雇佣数据,并且初级岗占比没有下降;没有这样的数据则这条不判。
专题 02 agent 被挡在入口外:网站、银行、国内的 App,各有各的拦法,没有一条共同的规则

线 A 讲的是出了事之后谁先开口。这个专题讲前一步:agent 想进门的时候,谁让进。这周能读到的拦法至少有三种,原因不同,处理的办法也不同。

The Verge 10-17 的一篇稿子(Websites are closing their doors to AI agentsMEDIA,Emma Roth)把零散的事放在了一起:近几周,Meta 的 Muse、xAI 的 Grok、OpenAI 的 Dots 和 Instinct 的用户都报告说,自己的 agent 在一些大网站上被挡了。稿子里的几例:Yelp 对 TechCrunch 说,只允许付费加入它数据授权项目的 agent;达美航空不让 agent 代用户订票;JPMorgan Chase 和 Charles Schwab 确认因安全原因封堵 agent 访问账户(这两句是 Verge 的写法);Amazon 说 Muse 的 “continued access” 违反其站点政策。Meta 的回应是:“Turning away a personal agent means turning away the customer behind it.”(把一个个人 agent 拒之门外,就是把它背后的客户拒之门外);它没有和 Amazon 对着干,而是和 Walmart、Gap、Sephora、Best Buy 等零售商谈好了让 Muse 在它们的站点购物,Shopify 也向 agent 开放了自己的店铺网络。

银行这一侧,据 Bloomberg 10-16 的标题《US Banks Block AI Agents Attempting to Move Money for Customers》(BloombergMEDIA)和 FT 10-16 的《Citi becomes latest US bank to restrict AI agents from accessing accounts》(FTMEDIA),封堵的是 agent 代客户转账、访问账户,花旗是最新的一家;FT 10-17 另有一条《BoE’s Bailey tells G30 they ‘have got to address’ AI agent concerns》(英国央行行长 Bailey 对 G30 说,他们“必须正视”AI agent 的顾虑)。这三条是标题级的信息,哪几家银行、封的是哪一种机制,本刊以上面 Verge 稿里点名的 JPMorgan 和 Schwab 为准,不替标题补细节。

国内的做法是另一种。豆包手机助手 10-14 公布了《屏幕自动化操作声明协议》(SAEP):30 天公示期结束后,将逐步开放第三方应用的 GUI 自动化操作能力,范围限于没有声明拒绝的应用;公示期结束后开发者仍可声明拒绝,声明拒绝的应用,豆包不会对它做相关操作。豆包同时披露了一份拒绝清单,共 151 款,微信、DeepSeek、淘宝、快手、美团都在列(雷峰网 10-15 早报MEDIA背景 · 10-14,转引济南日报等)。要读清楚:这里的“拒绝”是应用方向豆包声明“不许它代操作”,不是技术封堵;这些应用在豆包手机上照样能装、能登录,用户手动用不受影响。本刊的读法是,这更像给 GUI agent 用的 robots.txt——规则是 agent 的制造方自己定的,拒绝要靠开发者主动声明,没声明的会被逐步开放。

还有第三种,不是谁要拦它,而是顺手被拦。Verge 稿里引了 AI 评估机构 EquiStampOFFICIAL(本刊 Neo Lab 档案EquiStampSELF)的 CEO Chris Canal 的话:“There are all kinds of things that are set up not even to block agents, but to block in general bots or programs that are trying to scam or hack.”(有很多东西设置出来,目的甚至不是拦 agent,而是拦一般的机器人或想行骗、想入侵的程序);稿子还写到 Reddit 上有人报告 Google 以“可疑活动”为由封了一些用 Muse 的账号,另有用户在 Walmart 结账出问题,尽管 Meta 和 Walmart 有合作。

这周有一个被误伤的具体例子,被误伤的还不是 agent 本身。Meta 通信副总裁 Andy Stone 10-18(周日)说,某个 Anthropic Claude 工具以约四倍于正常的速率、成脉冲式地读取资料页、帖子和话题标签,请求 “resembled automated bot traffic rather than an ordinary human browsing our systems”(看起来像自动化的机器人流量,不像普通人在浏览我们的系统),触发了 Meta 的安全系统,No Kings(反特朗普团体)的 Instagram 账号因此被误封;Meta 约一小时后自动复查,认定不该封,恢复了账号,管理员权限更晚才恢复,Stone 道歉。No Kings 说账号 10-17(周六)约 90 分钟不可见,当时正是它“早投票”行动日(Bloomberg 稿MEDIA,Yahoo Finance 转载全文)。要读清楚的是:Bloomberg 写 Stone 的声明没有说明是哪个 Claude 工具、谁在操作;Meta 没有指控 Anthropic 或 agent 违规;Meta 的说法还变过一次——周六 Stone 说是发帖、分享、评论的频率异常高触发的,周日改成上面的解释。所以它不属于线 A 的“agent 越权”,更接近“被访问方的自动防御把一个 AI 工具的流量当成机器人、波及了第三方账号”。Anthropic 有没有回应,本刊没有核到。

怎么看放在一起读(本刊的归纳):agent 被拦的原因至少有三种——商业上的(Yelp 要付费,Amazon 不同意)、安全上的(银行封堵账户访问)、顺手误伤的(通用反爬挡了 agent),处理办法各不相同,目前没有共同的规则;本刊深潜《Agent持证上岗:AI员工入职要闯的六道关卡SELF》9 月梳理过身份、网络准入、企业工牌、支付资格、信誉背调、责任保险六道关卡同时在建、没有统一标准,这周是它们在零售、银行和国内 App 上的具体样子。美国这边是各家网站各自说不,agent 厂商一家家去谈;国内的豆包是自己先立一份声明协议。这和线 A 是同一件事的前一步:A 讲出了事之后谁先开口,这里讲事前谁让进。可以被打脸:10-30 前,有一家主流电商、银行或支付网络官方公布面向第三方 agent 的认证、令牌或统一准入机制(不是封堵,也不是和某一家 agent 的双边合作),那“各自说不”就在被统一的做法取代。
研究与技术
Claude reveals ECDSA curve originsOFFICIALMUSTTECHREAD——Anthropic 10-16:一位员工问一个内部研究模型,能不能在不给线索的情况下,弄清 NIST 椭圆曲线种子(seed)的来历。背景是:这些种子 2000 年随 NIST 标准公布,由 NSA 提供,没说明来历,几十年来有人怀疑曲线里埋了后门;流传最广的说法是 NSA 的 Jerry Solinas 拿一句玩笑话做哈希生成的(那是他 2015 年自己的回忆,他 2023 年去世)。页面写的结果是:“In under half an hour, Claude discovered the origins of the NIST P-192, P-224, P-256, P-384, and P-521 seeds. None of them were the results of any hash algorithm at all, but rather the output of the C library’s lrand48 random-number generator, seeded with a Unix timestamp!”(不到半小时,Claude 找到了 NIST 这五条曲线种子的来历:它们根本不是哈希的结果,而是 C 库的 lrand48 随机数生成器用 Unix 时间戳播种后的输出)。办法是:先猜这些种子来自 1990 年代 C 库里很弱的伪随机数生成器,写了个扫描器沿着每个种子逐位滑动,测试相邻的块是不是某个老生成器的连续输出;它注意到有四个种子的所有 32 位字最高位都是 0,随机出现的概率是 1/5,810,那是 lrand48(只返回 48 位状态的高 31 位)的特征;再用格基约化(LLL)从截断的输出还原出 48 位内部状态、倒推回 srand48 初始化的形态,十个素数域曲线种子(NIST 的五个加 ANSI X9.62 的五个)的初始值,都是 1997 年 5 月到 1998 年 4 月之间的 Unix 时间戳。Anthropic 自己的解读是:这不是密码学上的破解、新攻击或曲线的弱点,反而让人对“曲线没有后门”更有信心,因为种子是用时钟播种的常见伪随机数生成的,谁都能复现。这是 Anthropic 的自述,本刊没有独立复现,也没有看到第三方密码学家的评论。
Designing more efficient quantum circuits with ClaudeOFFICIALTECHREAD——Anthropic 10-16:给 Claude 八个量子算法基础例程的大白话规格(涉及化学、优化、量子模拟、数论、数值计算)和一个自动评估程序(检查对不对,再按“量子比特数乘门数”打分),页面写 Claude Mythos 5 能在闭环里自己提设计、拿反馈、改下一版,轮与轮之间没有人介入。结果是八个例程里它都找到了比已发表的最好设计用更少量子比特、更少门的方案,“in some cases by an order of magnitude or more”(有些情况下好一个数量级以上);两个例子:一个新的可逆模逆算法(模逆是椭圆曲线计算里最贵的一步),另一个把一个主流量子优化算法最贵的一步变便宜了约 12 倍。页面强调提升来自新的结构和数学洞察,不是调参:比如编译一个铁硫分子的模拟电路时,Claude 注意到分子的对称性和重复结构让一些结果可以算一次、重复使用。工作由 Andi Gu 在 Anthropic 的 STEM Fellows 项目里牵头,Alek Kemeny 指导,与 Harvard 的 Susanne Yelin、Mikhail Lukin 合作,完整论文在 arXiv。这是 Anthropic 的自述,对照的“最好已发表设计”也是它自己选的。放在上期专题 01SELF旁边读(本刊的读法):结果能被一个程序检验、又有清楚的分数,是它能做成的前提,和上期“机器能检的验证先变便宜”是同一类。
Grounding AI agents in biological realityOFFICIALTECHREAD——Google Research 10-16 的三个项目,目标是把 AI agent 的假设放到真实的湿实验里闭环验证。一,VERID 框架:给实验室工作站做一个“语义数字孪生”,实时跟踪机械臂的几何、每个孔的体积、试剂和枪头库存,agent 先在里面干跑,被模拟器拒绝才改计划;建在开源的 PyLabRobot 上。二,用 DNA 适配体做沙盒,在两个蛋白靶点(肌红蛋白、α-凝血酶)上跑三轮“设计—实验—迭代”:确认的靶向命中率升到 33.5% 和 42.1%,每个靶点踩的坑不一样。α-凝血酶第一轮是 0% 命中,因为固定的引物悬臂让 48% 的序列折叠不对,agent 第二、三轮加了夹住的侧翼茎之后升到 26.0% 和 42.1%;肌红蛋白第二轮 agent 追求原始结合力,63% 的设计堆在 G-四链体基序上,那些多是粘在别的蛋白和磁珠上的“粘性”结合体,特异性从 75.0% 掉到 19.1%,agent 看了读数自己改了设计规则,第三轮回到 72.4%、命中率升到 33.5%。三,针对实体瘤里过表达的成纤维细胞活化蛋白 FAP 做 de novo 蛋白结合剂:把结合口袋单独“切”出来再折叠,每个周期快 8 倍以上,几轮实验就得到了个位数纳摩尔亲和力的结合剂;同等算力下,科学家定策略、agent 管战术的人机协作,把计算机内的命中率几乎翻了一倍。以上都是 Google 的自述,对应三篇论文,本刊没有读论文。接上期专题 03SELF:那里说“湿实验和自动化”是目前钱最先到账的一格,这是同一格的新证据。生命科学
Postgres 19 delayed after AI reviewers find more bugs than humans can fixMEDIA——The Register 10-16:PostgreSQL 19 原定 9 月底或 10 月初发布,现在预计 11 月 19 日前后正式可用,8 到 10 个重要特性被撤回、推到明年的 PostgreSQL 20。EDB 的 Peter Eisentraut(核心 committer)在自己的博客OFFICIAL背景 · 10-09里把原因部分归于用 LLM 做代码审查:有些被撤回的特性有难以在 beta 期快速修的架构缺陷,但还有一长串“relatively harmless issues involving various edge cases”(相对无害的边界情况问题),以前要等发布后五年里慢慢补;现在“with LLM-assisted code review, these kinds of things can get found much faster, and then you’re staring at a list of like forty defect reports”(有了 LLM 辅助的代码审查,这类问题能被快得多地找出来,然后你面对的是一份四十来个缺陷报告的清单),就算每个只要三行修复,处理每个的固定开销也会把时间耗光。他还写:这批特性写成的时候 LLM 审查没有现在好用,所以“the effective quality bar has been raised after the time the feature was written”(有效的质量门槛是在特性写好之后才被抬高的);他也说这不是“vibe coding”造成的,因为那时还没有这种写法。另一个因素是今年 4 月到 8 月(他称之为 Vulnpocalypse)许多资深开发者在修安全问题,beta 期的常规审查被压缩。放在上期专题 04SELF(担保挪到合并后)旁边读(本刊的读法):AI 审查把瓶颈从“找 bug”推到了“修 bug 的人手”。
产品与模型
Timestral:Mistral 的时间序列基础模型OFFICIAL背景 · 10-14——Mistral 的第一个时间序列基础模型家族,四档,5M 到 209M 参数,能在 CPU 上跑、零样本预测。官方称最大的 209M 在 GIFT-Eval、TIME、fev-bench 三个主流公开基准上都排第一,参数只有此前最好模型的三分之二(厂商自述,成绩已提交到 GIFT-Eval 和 TIME 的榜单)。HF 上的仓库 10-14 创建(官方接口),上期漏收。
公司与资本
Investing in the public benefitOFFICIAL——Anthropic 10-18 设立 Anthropic Public Benefit Fund:“Subject to stockholder approval, 5% of Anthropic’s shares will be committed today, with an additional 2% added at the board’s discretion for every 50% increase in the company’s value above a set baseline.”(经股东批准,今天先承诺公司 5% 的股份;公司价值在某个基线之上每再涨 50%,董事会可以酌情再加 2%)。基金是全资 LLC,不是 501(c)(3),页面的解释是为了在不同的捐赠形式之间保留调整空间;基金持有的 Anthropic 股权不会用于游说或政治捐款;页面举的例子是劳动力市场冲击(Anthropic 已承诺 2 亿美元研究和应对这个问题)。加上联合创始人当年承诺捐出 80% 的股权、员工的股权捐赠配捐计划(约一半员工参加),Anthropic 说约 20% 的股份将用于公共利益,估值里程碑达标后还会再增加。结构、治理和“基线”具体是多少,页面说“未来几个月”公布。放在 IPO 的时间表旁边读(见线 B):本刊没有证据说这笔承诺会写进公开 S-1,只能等 S-1 出来再看。
Disney agrees to hire the majority of Character.AI’s workforceMEDIA——TechCrunch 10-18:Character.AI 申请破产之后,一份被 Bloomberg 发现的法庭文件披露了和迪士尼协议的细节:迪士尼将向至少 60 名 Character.AI 员工发出录用通知(占多数),估计年薪酬约 6,000 万美元;文件写“vast majority”(绝大多数)拿到录用的员工已经接受。但这是“stalking horse bid”(保底出价),别的公司可以出更高价。文件还写,Character.AI 尽管用户基数大,仍被高成本和“potential litigation-related liabilities and regulatory engagement”(潜在的诉讼责任和监管介入)拖垮。它的前 CEO Karandeep Anand 最近已出任迪士尼首任 CTO;迪士尼此前说愿以 2,000 万美元买下一部分资产(上期SELF写过破产和保底出价)。
OpenAI agrees not to use alleged Apple trade secrets amid ongoing lawsuitMEDIA背景 · 10-14——9to5Mac 10-14 转述 Bloomberg:Apple 起诉两名前员工(Chang Liu、Tang Tan)、OpenAI 和 io Products 盗用商业秘密;10-14 的听证上,法官 Edward Davila 表示“highly likely”(很可能)会准予 Apple 的初步禁令,OpenAI 随即自愿承诺“不使用 Apple 声称被偷的商业秘密”,并同意对 14 名员工可能含有 Apple 机密信息的设备做取证镜像,法官有权执行这项协议;法官也驳回了 Apple 检查所有可能设备的要求,称是“huge ask”(过分的要求)。同一天 OpenAI 另提动议,称一名离开 OpenAI、回到 Apple 的前员工带走了 100 多份与未发布硬件有关的保密文件。本刊没有查到书面裁定,上期没有写这个案子。
Introducing Securing America’s Infrastructure FoundationOFFICIAL背景 · 10-15——a16z 孵化的 501(c)(3) 非营利机构 SAIF,向缺少 AI 工具的美国公共机构(小城市、学区、乡村医院)免费提供 AI 和网络安全工具、实操培训和网络事件响应,路子更像“forward-deployed engineering”(前置工程师驻场)而不是传统的捐款。先在两个不同地区的小城市试点,计划五年内做到 5 到 10 个“锚点城市”,起步资金是 a16z 创始合伙人承诺的 2,500 万美元;头一年专注 AI 网络安全,例子是用 AI 找出并修复 MRI、医院监护仪这类设备代码里的漏洞。牵头人是前 NSA 官员、前白宫网络与新兴技术副国家安全顾问 Anne Neuberger,她起步时以志愿者身份运营。公共部门 · 网络安全
法律与数据
Meta’s new terms may allow it to train AI on news sites for freeMEDIA——The Verge 10-16:Meta 的新商业条款(10-30 生效)有一段授权,Meta 可以用自动化软件(爬虫、机器人等)访问、索引、缓存、抓取与商家产品“相关”的网站,并“may use any content from such domains, web pages, or URLs to provide, develop, improve, research, train…”(可以把这些网站的内容用于开发、改进、研究、训练 Meta 的产品)。Nieman Lab 和 Cornell 的 James Grimmelmann 读成:Meta 可以免费用出版商的内容训练 AI,并可能压过网站 robots.txt 的屏蔽;Meta 发言人 Daniel Roberts 当时说“There is no change to how Meta uses web crawlers; any suggestion to the contrary is false.”(Meta 使用爬虫的方式没有任何改变,说有改变的都是假的)。10-17,The Verge 的后续MEDIA写 Meta 在条款里把这段话删掉了,Roberts 的新声明是:“the crawling terms we consolidated only applied to our ads and business products, and we’ve clarified that in the terms themselves… This is not about scraping news sites”(我们合并的抓取条款只适用于广告和商业产品,我们已在条款里写清楚……这和抓取新闻网站无关)。
Appeals court upholds Thomson Reuters win in AI training lawsuitMEDIA——The Verge 10-18,一篇只有两句话的短讯:2025 年 2 月,特拉华联邦地区法院的 Stephanos Bibas 法官判 Ross Intelligence 败诉,Ross 的抗辩是用从 Thomson Reuters 抓来的数据训练它的法律 AI 属于合理使用;现在上诉法院维持了原判,“though it remains sealed”(不过判决仍处于封存状态)。哪一级上诉法院、判词怎么写,本刊没有核到。这是一个竞争性的、非生成式 AI 的案子,外溢到生成式模型的训练案要谨慎(本刊的读法)。法律
洞察
The AI expectations gapOFFICIAL——Anthropic 10-16:2026 年 8 月做了两份问卷,一份是有全国代表性的美国成年人样本,一份是 Anthropic 员工。两组对“今天 AI 能做什么”大体一致,对未来的速度分歧很大:预计到 2030 年 AI 能做出诺贝尔级发现的,员工 91%、美国成年人 39%;预计 AI 能做自己多少工作,页面原话是 “On average, staff members expect AI to be able to do 75% of their current work by 2030, compared to 28% for US workers overall”(平均而言,员工预计到 2030 年 AI 能做自己目前 75% 的工作,美国工作者整体是 28%);员工中过半预计 2030 年 AI 能做自己至少 80% 的工作,美国工作者是 5%。两组推理失业率的方式相似:越预期 AI 会做自己更多工作的人,预测的失业率越高;在预期被自动化的程度相同时,两组预测的失业率也差不多。这是调查,不是预测,一边的样本是造 AI 的人,读的时候要带着这个偏向(本刊的读法);它是专题 01里“员工预计 75% 对 28%”那个数的出处。
新发布DeepSeek(API Docs) · api-docs.deepseek.comAgent 工具EN2026-10-17
DeepSeek 搜索与抓取 API:给你的 agent 接一个搜索和网页抓取工具↗
官方文档给了完整步骤:同一个 API key 带 Bearer 头,POST /v1/tools/search 和 /v1/tools/fetch,各一个请求体示例和返回字段;按成功请求计费,失败和空结果不收钱。坑在收费:通过 DeepSeek Harness、Claude Code、Codex 调用时目前免费,北京时间 11-01 零点起按次收费。
窗口内(10-30 前) 故事线 B · Anthropic IPO 把握 中
Anthropic 的公开 S-1,10-30 前会不会出现在 EDGAR 上
官方只确认过 06-01 保密递交 S-1 草稿(AnthropicOFFICIAL);EDGAR 全文检索 10-19 没有 Anthropic, PBC 作为申报人的 S-1;10-18 Anthropic 发公益基金公告,写基金的结构、治理和估值里程碑“in the coming months”才公布(AnthropicOFFICIAL)。路演时间只有媒体说法,没有官宣,这条赌的是上市时间表在往后挪。
预测10 月 30 号前,EDGAR 上不会出现 Anthropic, PBC 作为申报人的公开 S-1。 判定口径:若 10-23 到 10-30 之间,EDGAR 全文检索里出现 Anthropic, PBC 作为申报人的 S-1,判断被推翻;若 S-1 在 10-23 前已经出现,这条不适用,改在 10-23 的复盘里处理;保密草稿不在公开检索里,不算。
窗口内不定期 故事线 A · 上报 把握 较高
白宫的“不可选”,10-30 前会不会长成书面规则
SI Force 10-15 通过章程(120 天期),TNW 转述 Semafor:没有说什么算事故、多久之内报、不报会怎样(TNWMEDIA);Federal Register 官方接口 10-19 检索 “Super Intelligence” 只返回三份文件,没有章程、规则或通知(Federal RegisterOFFICIAL背景 · 10-02);EO 14434 的 60 天节点是 11-28,在窗口之外。
预测10 月 30 号前,白宫不会发布写明事故门槛、上报期限或处罚的书面文件。 判定口径:若 whitehouse.gov、Federal Register 或 SI Force 官方渠道在 10-23 到 10-30 之间公布的文件,写明“什么算事故”“多久之内报”“不报怎么办”中的任一项,判断被推翻;媒体转述的声明、厂商自拟的草案(含 Anthropic 那份)不算。
10-28 财报日 故事线 B · 资本开支 把握 较高
Alphabet 和 Microsoft 10-28 的财报,会不会下调资本开支指引
Alphabet 的官方公告写 10-28(周三)太平洋时间 1:30pm 开财报电话会(Alphabet IROFFICIAL);Microsoft 的 IR 首页写 FY27 Q1 财报在 10-28(Microsoft IROFFICIAL);Meta 的财报在这周的 10-21(Meta IROFFICIAL)。这周的压力在融资端,需求端的硬数据还在涨:施耐德说数据中心订单的需求增速是三位数,CoreWeave 在手订单超过 1,000 亿美元;资本开支指引是两头的交汇点。
预测Alphabet 和 Microsoft 在 10 月 28 号的财报里,都不会下调资本开支指引。 判定口径:若任一家在 10-28 的财报、新闻稿或电话会上,把自己此前披露的资本开支指引数字下调,判断被推翻;维持或上调不算;公司没有给出可比的指引,这条不判。
官方说“本月底” 故事线 C · Mistral 把握 中
Mistral Large 4 的权重,10-30 前会不会放
Mistral 10-06 的官方博客写 “We will release the weights by the end of the month”,没给具体日期(MistralOFFICIAL);HF 上 mistralai 组织最新的仓库是 10-14 的 Timestral,没有 Large 4(HF 接口OFFICIAL,10-19 读)。“本月底”的上限是 10-31,比下期分享日晚一天,所以这条赌它不会赶在 10-30 之前。
预测10 月 30 号前,Mistral 不会放出 Large 4 的权重。 判定口径:若 10-23 到 10-30 之间,Hugging Face 的 mistralai 组织或 Mistral 官方页面上出现 Large 4 的权重,判断被推翻;若权重在 10-23 前已出现,这条不适用,归入 10-23 的复盘。
10-30 当天读榜 故事线 C · 榜单 把握 较高
Artificial Analysis 开放权重榜的前五名,会不会出现美国公司的模型
AA 开放权重榜(榜单页OFFICIAL,10-19 读)第 5 名是 Kimi K3 的 43.59;美国模型里最高的 Muse Spark Open 排第 7、38.87,Beam 排第 10、30.33;Meta 自己的评分表里它在 Terminal-Bench 2.1 和 DeepSWE 上也低于几个中国模型(Meta 官方博客OFFICIAL)。
预测10 月 30 号前,AA 开放权重榜的前五名里不会出现美国公司的模型。 判定口径:若 10-30 当天读取 artificialanalysis.ai/models/open-source,前五名里出现美国公司(Meta、Reflection、OpenAI、NVIDIA 等)的模型,判断被推翻;榜单的默认筛选或指数版本变了,按页面当天的写法。
AI 解释